软件掘金RSI:十万国产芯片撑起62万亿Token
引言
RSI(递归式自我改进)正从模型算法层扩展到系统工程层。智谱把RSI放在了Infra层:以GLM-5.3为“中枢”,打造一套会自我学习、会自我迭代的推理基础设施。这套系统支撑了GLM-5.3-Flash(外界熟知的 Ox-Alpha)在上线一周内处理超62万亿Token的峰值表现,更关键的是,它完全跑在十万张国产芯片上,并在两周内完成了从全量打通到生产流量切换,端到端吞吐提升3.2倍。背后的信号非常清晰:在算力受限与生态不成熟的现实下,靠软件“掘金”比靠硬件“堆料”更能赢得时间与效率。
为什么在Infra层搞RSI:从“更多芯片”到“更聪明的系统”
- 供给受限与成本拐点:在“300亿算力成本战”背景下,新增一块卡的边际价值迅速下降,推理侧的每一次调度、每一份缓存,都是真金白银。把RSI放到Infra层,等于让系统持续自我优化,直接作用于单位Token成本与吞吐。
- 底层解耦的必要性:国产芯片的软件生态不够完备,算子、通信、内存语义差异巨大。RSI化的Infra可以把“硬件异构”抽象成“可学习的适配问题”,通过自动化搜索与反馈闭环,跨越不同芯片、不同网络形态的兼容障碍。
- 长期复利效应:算法上的一次优化只惠及某个模型或某段版本;Infra层的优化会在所有模型、所有场景中复用,并通过数据闭环不断累积“工程直觉”,形成复利型护城河。
简而言之,把RSI下沉到基础设施,就是把“更多算力”的竞赛,改写为“更聪明调度、更高效利用”的竞速。
十万张国产芯片的硬仗:软件补硬件的三把刀
在十万卡规模的国产芯片集群里,内存、通信、软件栈与稳定性是四座“大山”。智谱的解法是用GLM-5.3驱动的Infra Agent把关键技术组合成几把“通用刀法”:
- 用通信换内存:节点内张量并行 + 层分割,把模型按层拆开,在单机多卡上协同承担注意力与输出的主计算。内存压力被拆分,热点被“摊平”到多卡。
- 用计算换内存:启用 ReplaySSM,装不下就丢,再在用到时复算。以短暂的算力开销换取宝贵显存,尤其适合百万Token级上下文的KV压力。
- 用精度换容量:W8A8量化把权重与激活压缩至8位,带来带宽与存储直接减半;KV缓存按重要度动态混用INT8/FP8/BF16,显存“颗粒级”榨干。
- 用解耦换调度自由度:把编码、预填充、解码彻底拆开,让调度器能独立伸缩路径、错峰资源,稳定吞吐而不牺牲尾延迟。
在这一套“软件打补丁”的组合拳之上,Infra Agent高频迭代策略,将国产芯片的利用率和单Token成本拉近英伟达体系。考虑到大规模集群每天可能有数百张卡故障、网络抖动与丢包,这样的稳定性与速度并非“写出代码”就能实现,关键在于能否让系统在复杂环境下自我诊断与自我修复。
让RSI真正落地:把“稀疏反馈”变成高频闭环
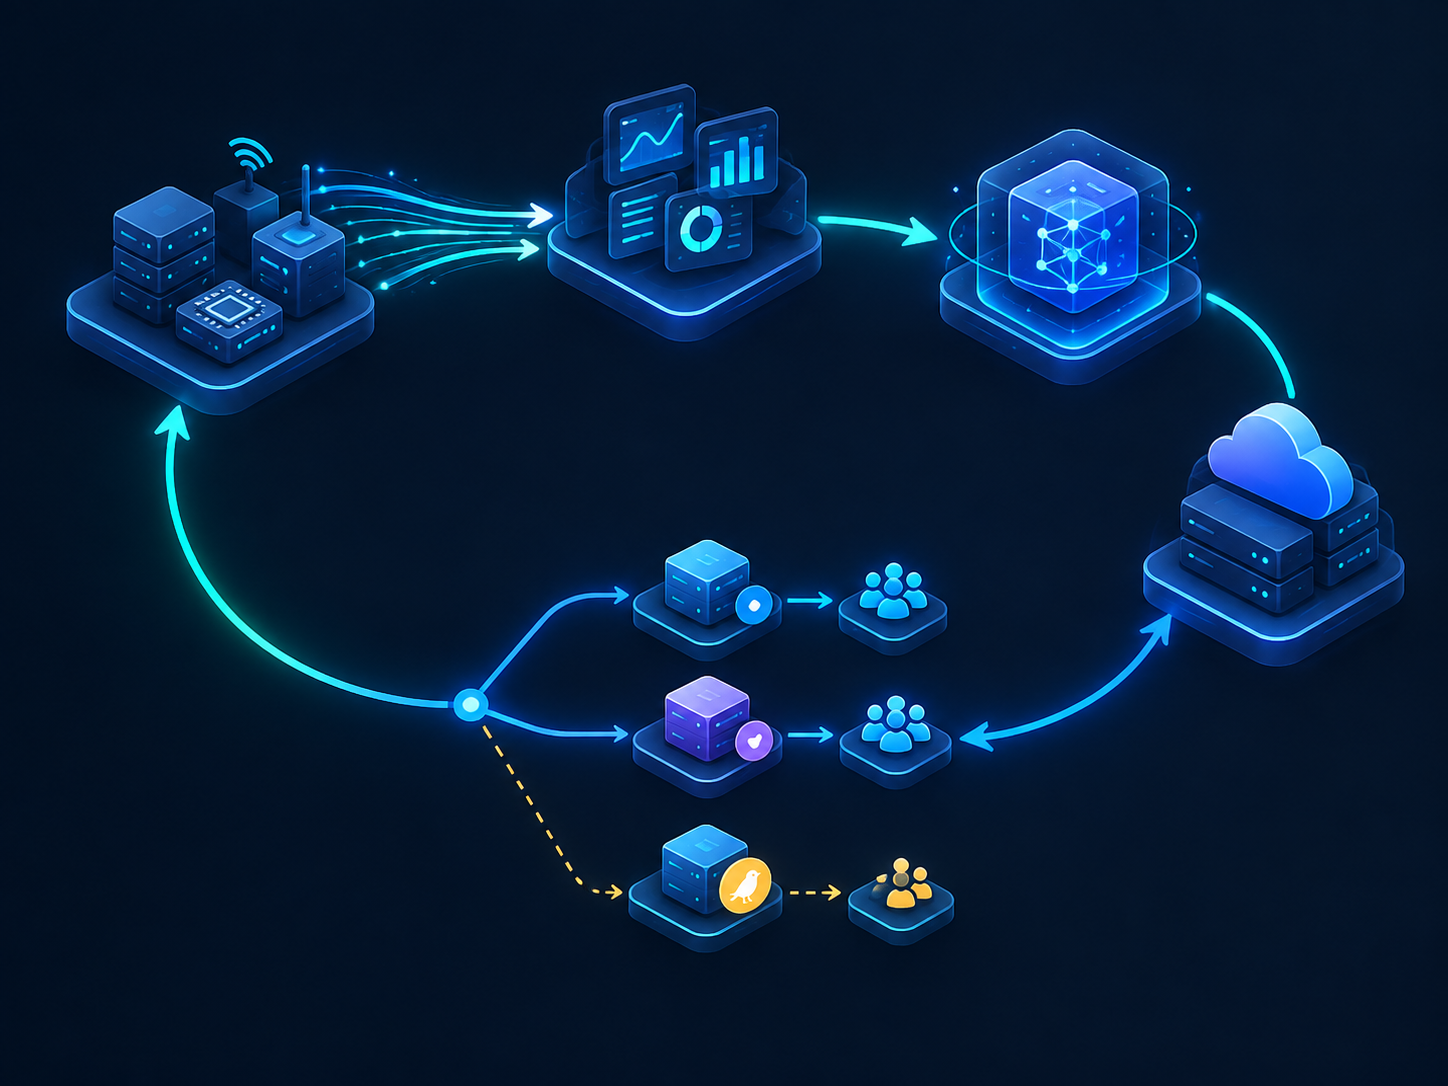
系统优化的最大难点是“稀疏反馈”:只看到“吞吐降了20%”,却不知道根因在算子、内存、还是网络。要让AI真的驱动Infra演进,需要把稀疏反馈“变密、变快、变可学习”。
可以预想的三步路径:
- 统一遥测与语义标签:把芯片计数器、网络时延、内存水位、调度决策与模型侧指标打通,构建端到端的因果图谱,为AI提供可解释的观察空间。
- 构造可替代目标与微基准:用代理指标(如阶段级QPS、KV命中率、热点迁移成本)近似总体目标,建立分钟级可复现实验,把小时级大回归变成秒级微改进。
- 低风险试验平台:灰度/金丝雀发布、自动回滚与鲁棒A/B,使强化学习、贝叶斯优化或进化搜索成为“安全可控”的默认工具链。
在这个框架中,GLM-5.3不只是被服务的对象,也充当系统优化的“参谋”。它读取日志与拓扑,提出假设与补丁,生成新的调度或量化配置,借助微基准快速验证,再把结果回灌到策略库。正如“模型优化系统、系统反哺模型”的表述所指,最小闭环已经开始运转,优化频率越高,收益越呈指数叠加。
影响与展望
- 对中国AI产业的意义:在外部供应受限与生态不均衡的现实下,RSI化的Infra为国产芯片提供了“发挥极限”的自动化途径,把“算力差距”转化为“软件红利”与“数据护城河”。
- 对产品与成本的意义:推理侧成本通常占大头。3.2倍吞吐提升与62万亿Token的实战验证,证明了把RSI落在Infra层的直接商业价值。
- 对技术范式的启发:AI for Systems 与 Systems for AI的双向馈赠,将成为下一代AGI栈的默认形态:模型参与系统设计,系统反向塑造模型能力。
挑战仍在:稳定性边界、指标体系标准化、跨芯片可迁移性,以及策略过拟合的风险。但一旦闭环跑通并可持续自增益,基础设施将不再是“手工调参的黑箱”,而是“能自学的算力工厂”。从这个意义上看,把RSI放在Infra层,既是现实约束下的务实选择,也是通往更高效、更普惠AGI的必经之路。
标签: RSI 智谱 国产芯片 推理基础设施 GLM-5.3
