AI资讯
从卡到秒:国产Token工厂端到端推理优化
海外算力收紧下,解读北京智源与清昴智能联合发布的国产 Token 工厂端到端推理优化方案与众智 FlagOS 落地:以统一软件栈、异构资源调度和推理内核优化,把按卡采购翻译为按秒交付,压降每百万 Token 成本,保障国产算力稳定供给。
海外算力收紧下,解读北京智源与清昴智能联合发布的国产 Token 工厂端到端推理优化方案与众智 FlagOS 落地:以统一软件栈、异构资源调度和推理内核优化,把按卡采购翻译为按秒交付,压降每百万 Token 成本,保障国产算力稳定供给。
面向企业生产的多智能体应用,详解大模型推理调度与KV缓存优化:覆盖端到端时延、成本与并发SLO,诊断时间/空间/共享三维瓶颈,助力可靠落地,聚焦AICon北京2
腾讯优图实验室负责人离任,映射技术重心由单点模型转向系统化智能。本文梳理其从医疗影像AI到多模态大模型的转型,解读Video-MME等工作,并评估企业级Agen
阿里巴巴发布基座大模型Qwen4-Max,稀疏注意力+MoE架构,原生多模态与百万级长上下文,智能体与编程升级。评测显示Token用量近半,缓存命中定价每百万T
阿里巴巴发布新一代基座大模型Qwen4-Max,2.4T总参数、QSA稀疏注意力与MoE协同,原生视觉与百万级长上下文兼备;在编程、智能体与长链路推理上更稳更准
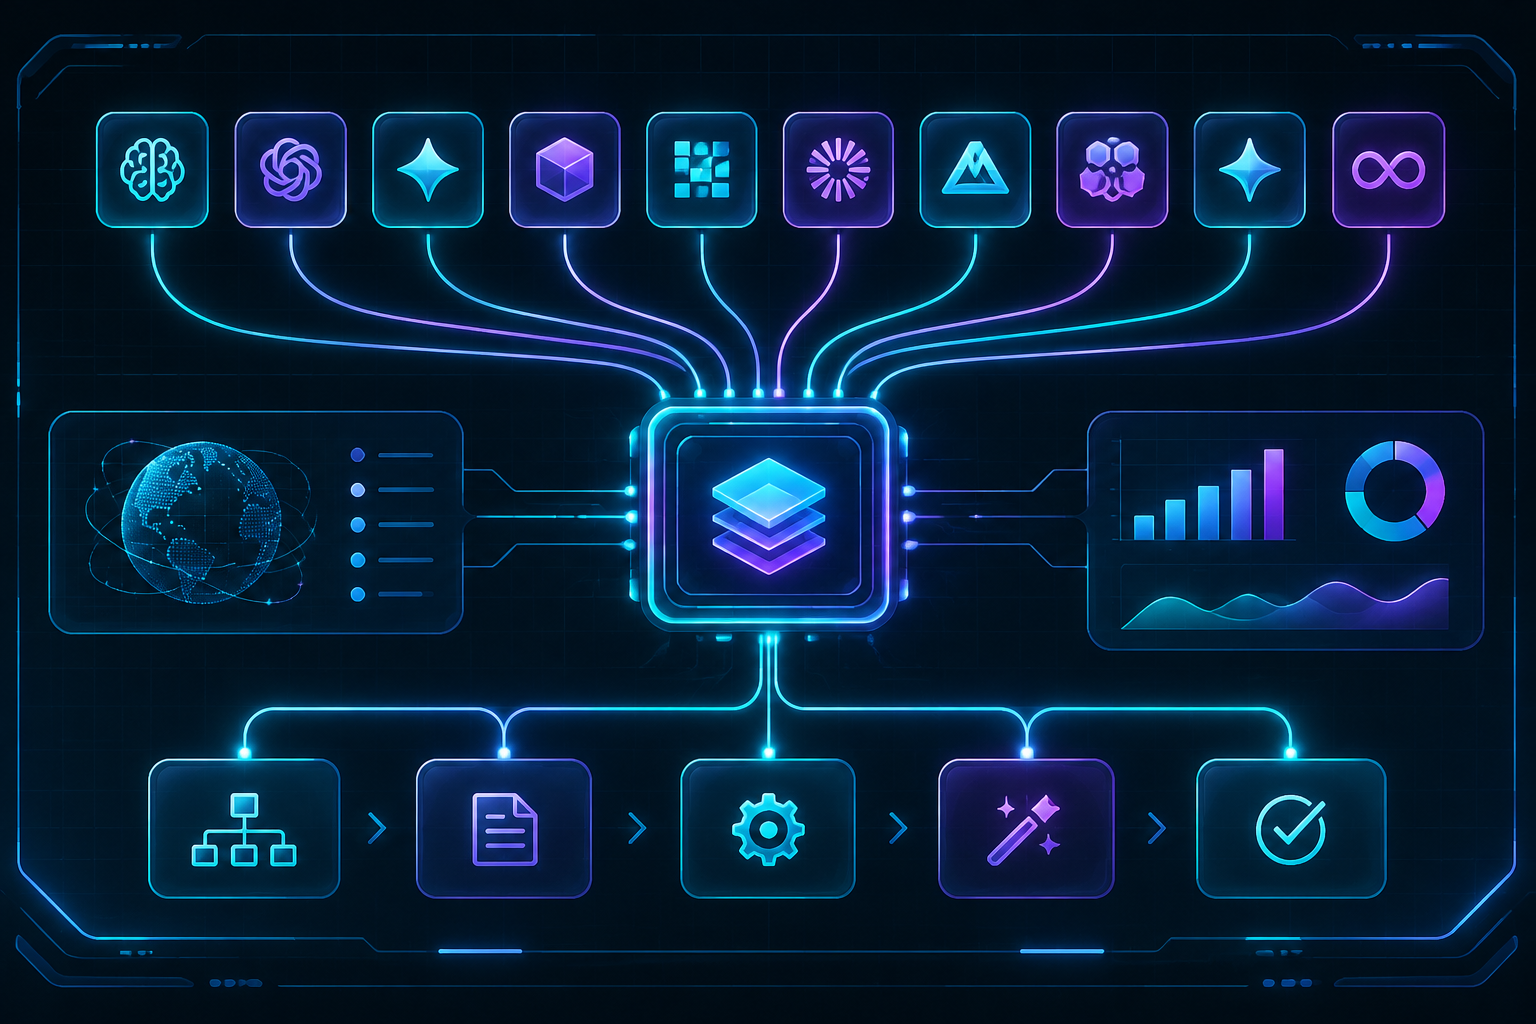
千问办公引入Qwen4-Max、DeepSeek等10款大模型,放开模型选择,面向多模型编排与Agent场景,重塑质量-速度-成本平衡,并给出分任务的实战选型指
面对11.11大促的瞬时洪峰与复杂协同,京东零售引入数字人队长这一Super Agent,常驻京Me群聊,跨群聚合上下文,主动调度工具与经验,把“信息到行动”的