Jev 28秒标注428条:不生成,只决策
引言
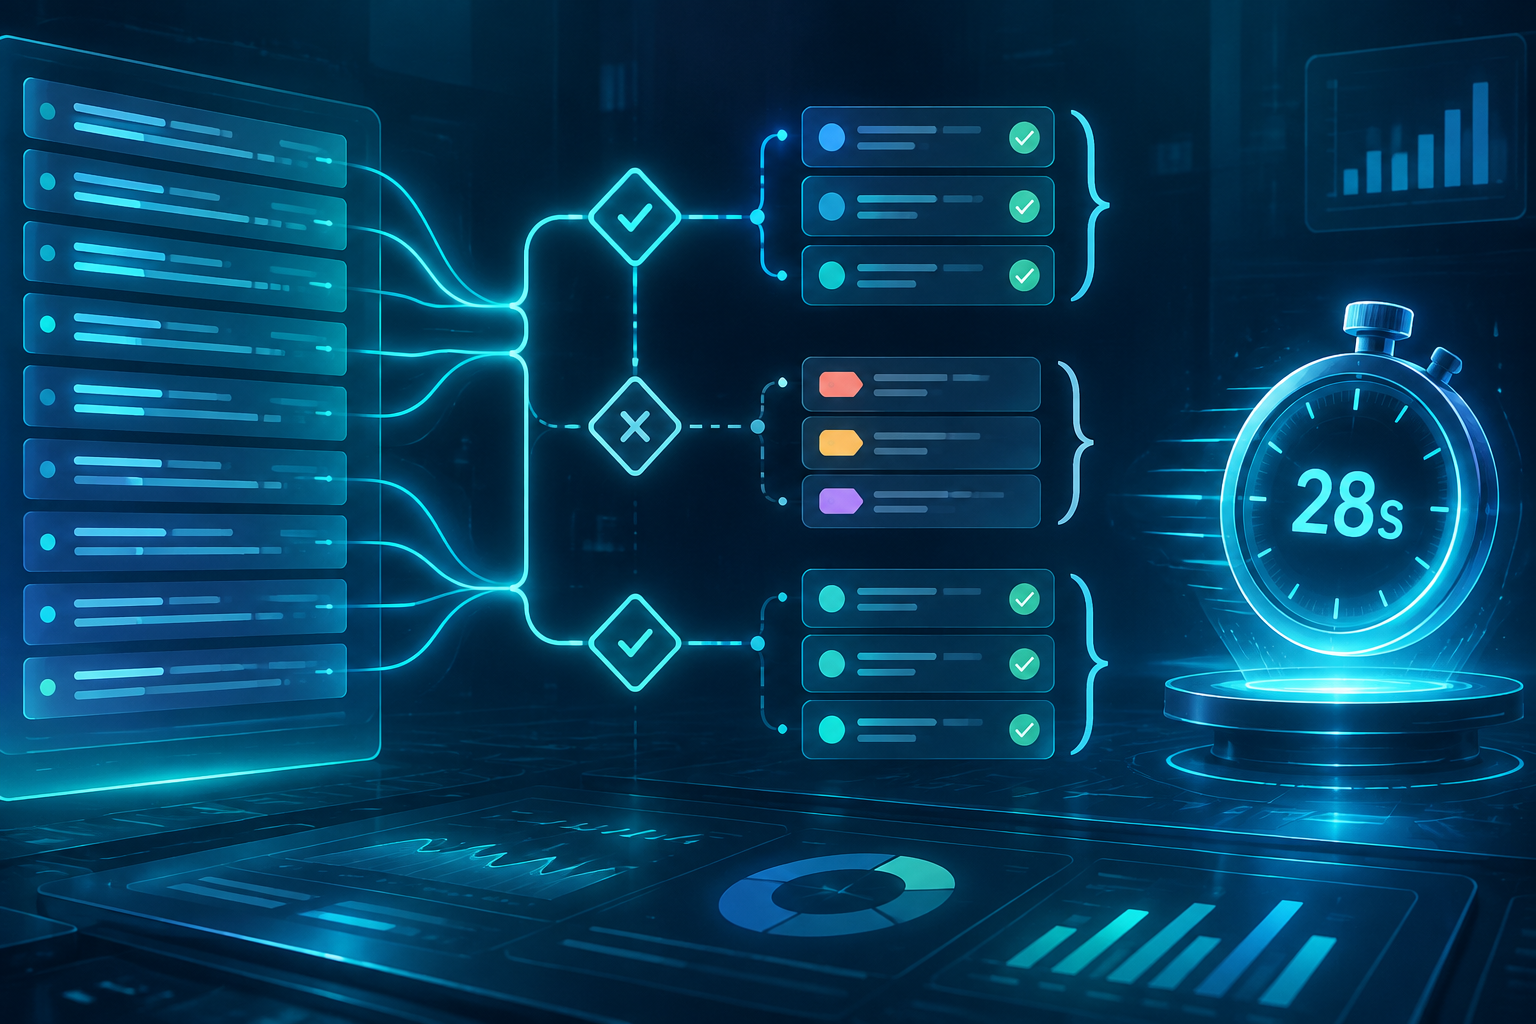
这几天,一个名为 Jev 的模型在社交媒体上刷屏:有人用它打马里奥、过滤垃圾信息、甚至实盘做量化交易,也有人冷嘲它“不过是个 JSON 分类器”。更刺激眼球的,是它与主流大模型在速度上的反差——同一任务,Jev 28 秒刷完 428 条数据并完成打标,而另一边的长推理模型还在第 6 条“慢思考”。在“慢即是安全”的深度推理路线与“快且准确”的工业化诉求之间,Jev 选择了反其道而行:不写长文、不做对话,专注于一个问题——迅速、可校准的决策。
这到底是AI革命,还是一次格式化得更漂亮的分类器?要理解这点,需要回到它的技术路径与产品定位。
Jev 是什么:从生成到决策的“降维重塑”
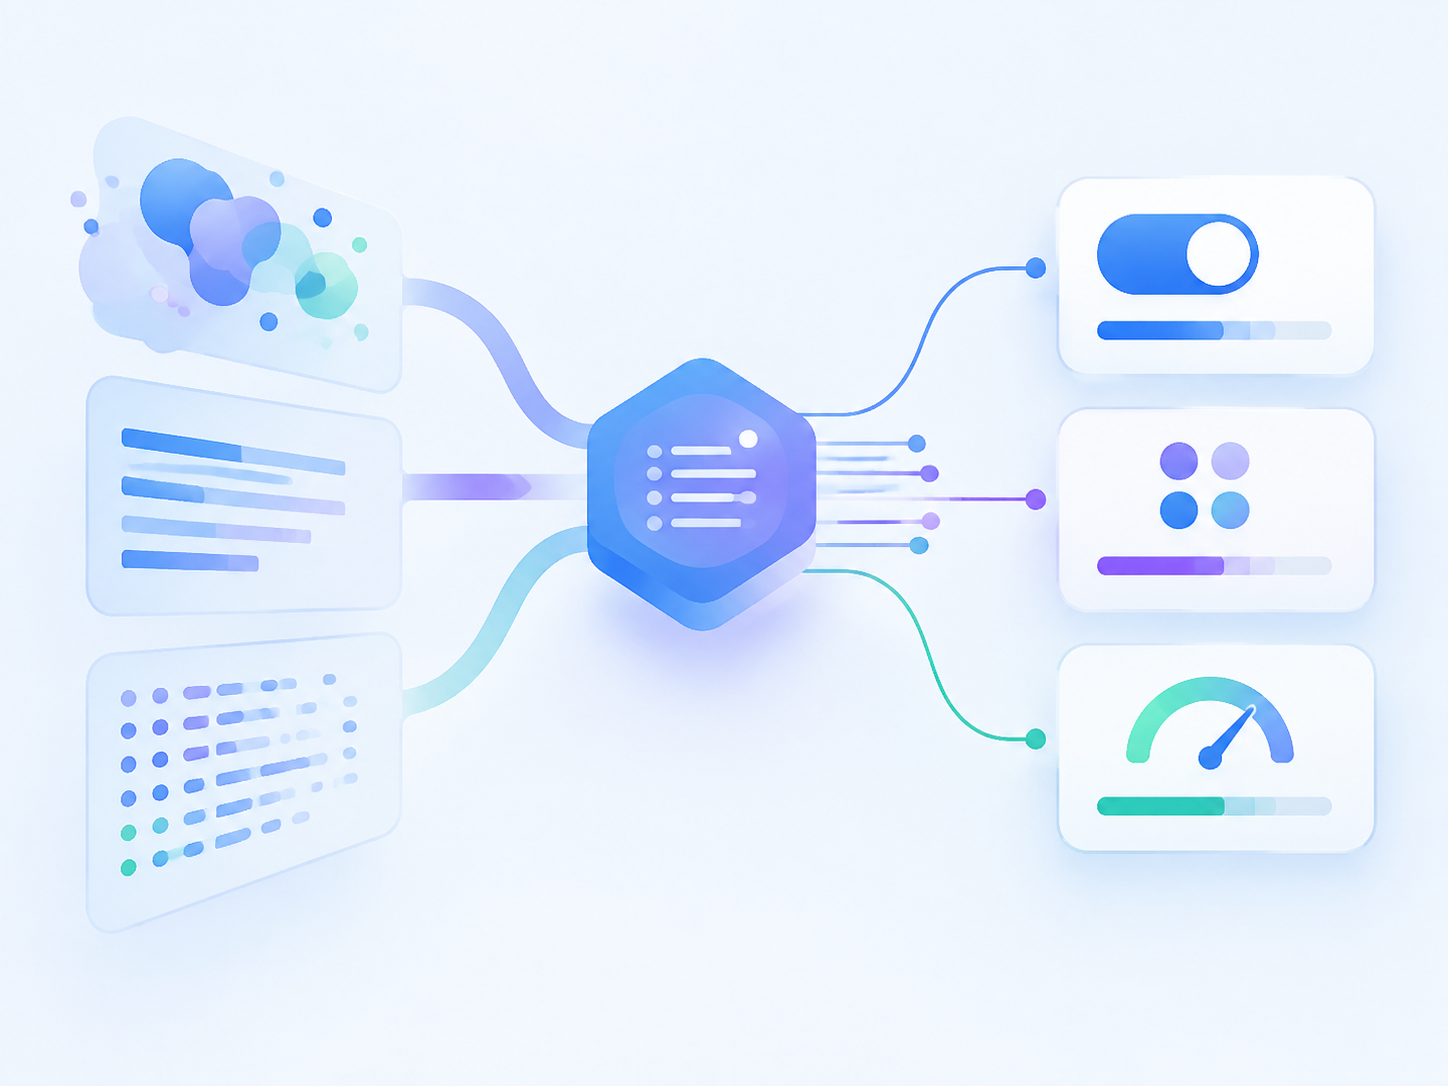
Jev 的核心定义并不复杂:不生成文本,只做决策。它接收非结构化的输入(文本、日志、图像描述等),输出结构化、带类型的概率决策,主要包括:
- bool:是/否判断,附带置信度;
- choice:多选一的选择分布;
- score:区间打分,并提供校准后的概率。
与传统 LLM 的“逐字生成”不同,Jev 的输出天然结构化、可直接被程序消费。这意味着决策可以不经再解析,立即触发自动化动作——对工程系统而言,这是极强的“可执行性”。
它的速度与成本优势来自两点:
- 模型架构与推理机制的调整,配合“并行采样”,避免 token-by-token 的串行生成;
- 一套新的训练范式:校准决策强化学习(RLCD)。这一范式强调“认识内的诚实”——概率即认知,几成把握说几成,把“不会瞎编”作为训练目标。
这条路线,是对 RLHF 与 RLVR 两代方法的反思与延伸:
- RLHF 将模型的输出与人类偏好对齐,带来了对话式大语言模型的突破,但也引入了“取悦式”幻觉;
- RLVR 通过可验证的奖励(如可编程判定、数学验算)推动了深度推理模型的发展,但带来高延迟与高成本;
- RLCD 则把问题“降维”到可靠、迅速的决策上,强调概率校准与并行采样,牺牲“长链思考”,换取“毫秒级响应”。
从认知比喻看,它更像是 Agent 系统中的“System 1”:快速、稳定、成本低的前线判别器,替大脑中的“System 2”节省算力与带宽。
它是“JSON 分类器”吗?形式之外的实质差异
“分类器”这个标签,表面上没错:Jev 的输出确实是结构化的类型与分布。但它与旧时代的 if-else 或经典分类器有几点本质差异:
- 概率校准:不是只给一个“类别”,而是提供可对齐到现实频率的概率。这使其更像“概率化的策略决策器”,可纳入风险控制、阈值调整、成本—效益优化。
- 并行决策而非生成:内部并行地评估多个选项,直接输出最终分布,绕过了序列生成的惯性与冗余。
- 强工程可用性:输出类型明确、可组合,天然对接工作流引擎与自动化平台;相比通用 LLM 的“自然语言+正则解析”,出错面更小。
- 训练目标的迁移:从对话“对齐”转向“决策正确且可信”,在损失函数、奖励设计与评估指标上,更接近传统决策系统(如 Brier Score、ECE 的优化)。
因此,把它简单视作“JSON 分类器”容易低估其系统性创新:真正的创新不在输出格式,而在“以决策为原生对象”的训练、推理与评估闭环。
当然,也需要承认边界:它不是下一代“无所不能”的通用模型,而是一个明确选择了纵深方向的“决策引擎”。
能力与边界:Jev 适用于哪些场景?
从产品定位看,Jev 的长板非常明确:高频、低延时、结论明确的场景。这类场景对“长推理”的需求低,对“吞吐与成本”的要求高:
- 实时筛选与分流:内容审核、垃圾过滤、风控前置规则、客服分诊、医院挂号优先级、仓储分拣。
- 大规模标注与数据治理:快速打标、去重、重要度评分、优先级队列排序,配合数据管线大幅降本。
- 在线决策与风控:阈值化的交易策略、欺诈初筛、系统异常初判,作为二线深度检验的前置。
- Agent 系统的“守门员”:先由 Jev 完成“是否需要深思”的判定,再把极小比例的难例交给慢但更准的长推理模型。
同时,Jev 的边界也应被清晰界定:
- 复杂因果与长链推理:需要多步论证、外部工具调用与可验证证明的任务,交由深度推理模型更适合。
- 无法定义客观目标的开放任务:如创作、辩论、开放式探究,缺乏清晰的奖励与评价标准时,决策会漂移。
- 数据分布突变与公平性:在监管与风控领域,概率校准并不等于公平,跨域迁移需要持续校准与监控。
- “不会有幻觉”的语义澄清:不瞎编文本并不等于不犯错;校准意味着诚实地报告不确定,而不是“真理保证”。
速度对比也需谨慎解读。所谓“28 秒 428 条 vs 6 条”的实验,可能包含任务定义、并发设置、硬件环境、容忍度阈值等多重变量。对企业而言,关键不在“绝对快多少”,而是“在目标精度下的单位成本与端到端延迟”。
影响与展望:从“大一统”到“多模型流水线”的转向
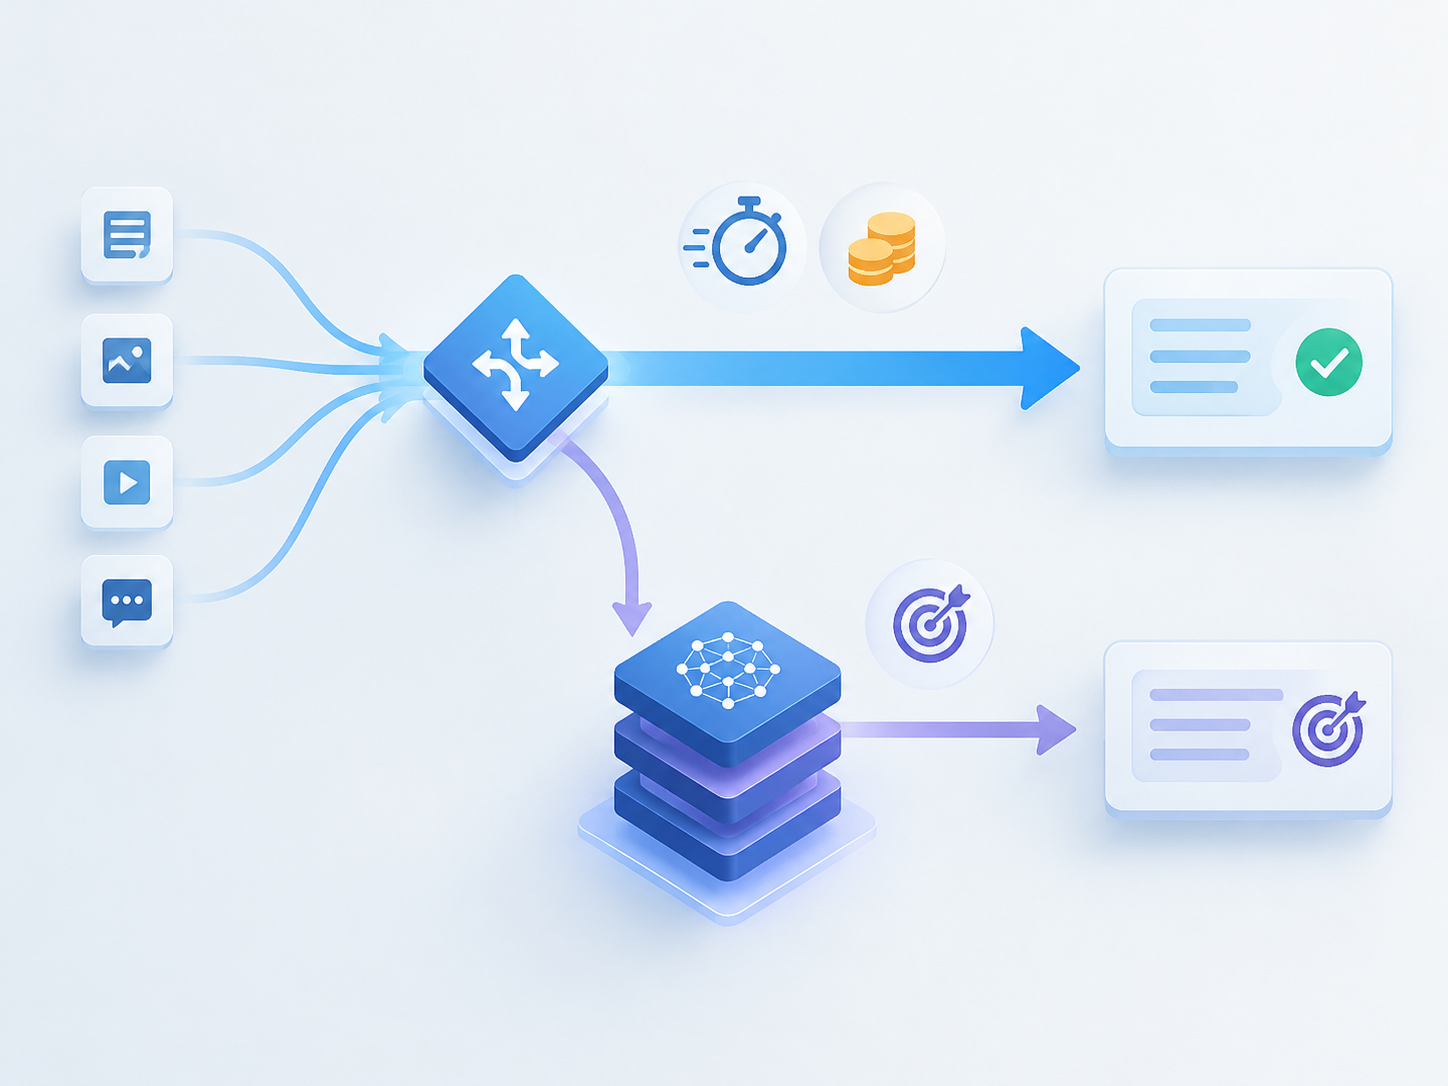
Jev 的出现,更像是一记“路线修正”:与其把所有任务推给一个无所不能的超大模型,不如在系统层面拆解——让“快思考模型”做大多数可判定任务,剩余难例由“慢思考模型”精细处理。这种“系统1+系统2”的分工,可能带来几方面的行业变化:
- 架构层面:从单一 LLM 接口,演变为“决策前置+推理后置”的双层流水线;MLOps 将更关注阈值管理、难例回流、热启动与在线校准。
- 评估体系:从单纯的准确率与 BLEU/ROUGE,扩展到 Brier、ECE、P95 延迟、单位请求成本(CPS)与误触发率(FPR)等决策指标。
- 产品形态:面向企业自动化的“决策即服务”将成为独立品类;结构化输出成为默认需求,减少“自然语言->解析->执行”的脆弱链条。
- 监管与合规:当决策覆盖医疗分诊、金融风控、内容治理,概率校准、可解释性与偏见审计将成为落地门槛。
- 与 Agent 的耦合:Jev 作为“动作触发的守门员”,可显著提升 Agent 系统的吞吐与成本结构;同时,需要配套的回退策略与人机协同机制。
值得强调的是,Jev 并不是要取代深度推理模型,而是把“快思考”重新放回工业自动化的中心位置。对于长期苦于 LLM 慢与贵的团队,决策前置的价值在于“把确定的先做了”,在真实世界的成本与延迟约束中,尽可能地把自动化比例推到更高。
真正的考验在于:它能否在跨域迁移中保持校准,能否在复杂业务中与规则、模型、人工协同出稳定的闭环,能否建立公开、可复现的基准来对抗过度营销。若这些问题得以良好回答,“快思考”的路线将不仅是一次产品爆款,而是自动化时代的基础设施升级。
标签: Jev 大模型 Agent 决策模型 RLHF
