1M上下文不炫技:MiMoV2.6押注强化学习
引言
1M token 上下文听起来足够吸睛,但在 MiMo-V2.6 身上,它更像是一盘“面子工程”。真正的底牌,是把代码、通用 Agent、视觉与网络安全任务拉到同一套强化学习框架里,并让一次更新产生 2.5 万条轨迹,围绕长时交互和工具调用去优化模型的“行为”。这代表一种从“更大模型”到“更强后训练”的范式转向:不仅让模型看得多、记得久,更要让它在复杂环境中动得对、收敛快、成本稳。
1M 上下文的真实用法:为 Agent 而非炫技
数字上,MiMo-V2.6-Pro 总参数 1.02T、激活参数 42B;Flash 版 309B/15B;两者均支持 1M 上下文并覆盖文本、图像、视频与音频。若只看规格,很容易把它归入“规模升级”。但其注意力与稀疏计算的组合,明显是为长轨迹 Agent 的计算形态做了工程化取舍:
- 局部优先的注意力:Pro 采用 70 层 Transformer,其中 60 层为滑窗注意力(窗口 128 token),10 层为全局注意力。绝大多数层只处理局部信息,间隔使用全局层“汇合”远端语义。这意味着 1M 上下文并非每一层都要和全部 token 交互,计算负担被精准压在“常用邻域”。
- 稀疏 MoE:每层 384 个专家,仅路由 8 个,token 级激活参数约 42B。保留大容量以装下多任务能力,同时把每步成本锁在可控范围。
- 推测解码提速:引入 5 层 MTP speculative decoder,drafter 一次前向可预测后续 7 个 token,再由主模型并行验证,显著提升长序列生成吞吐。
这三者叠加的意义,在 RL 阶段尤为明显:当单次更新需要生成上万条、每条几十步的轨迹,任何“单 token 增量成本”都会被指数放大。MiMo-V2.6 用局部注意力、稀疏专家与推测解码,把长时交互的单位成本打到足够低,才有余量把轨迹数量推上去。
从问答到轨迹:统一 RL 与奖励重塑
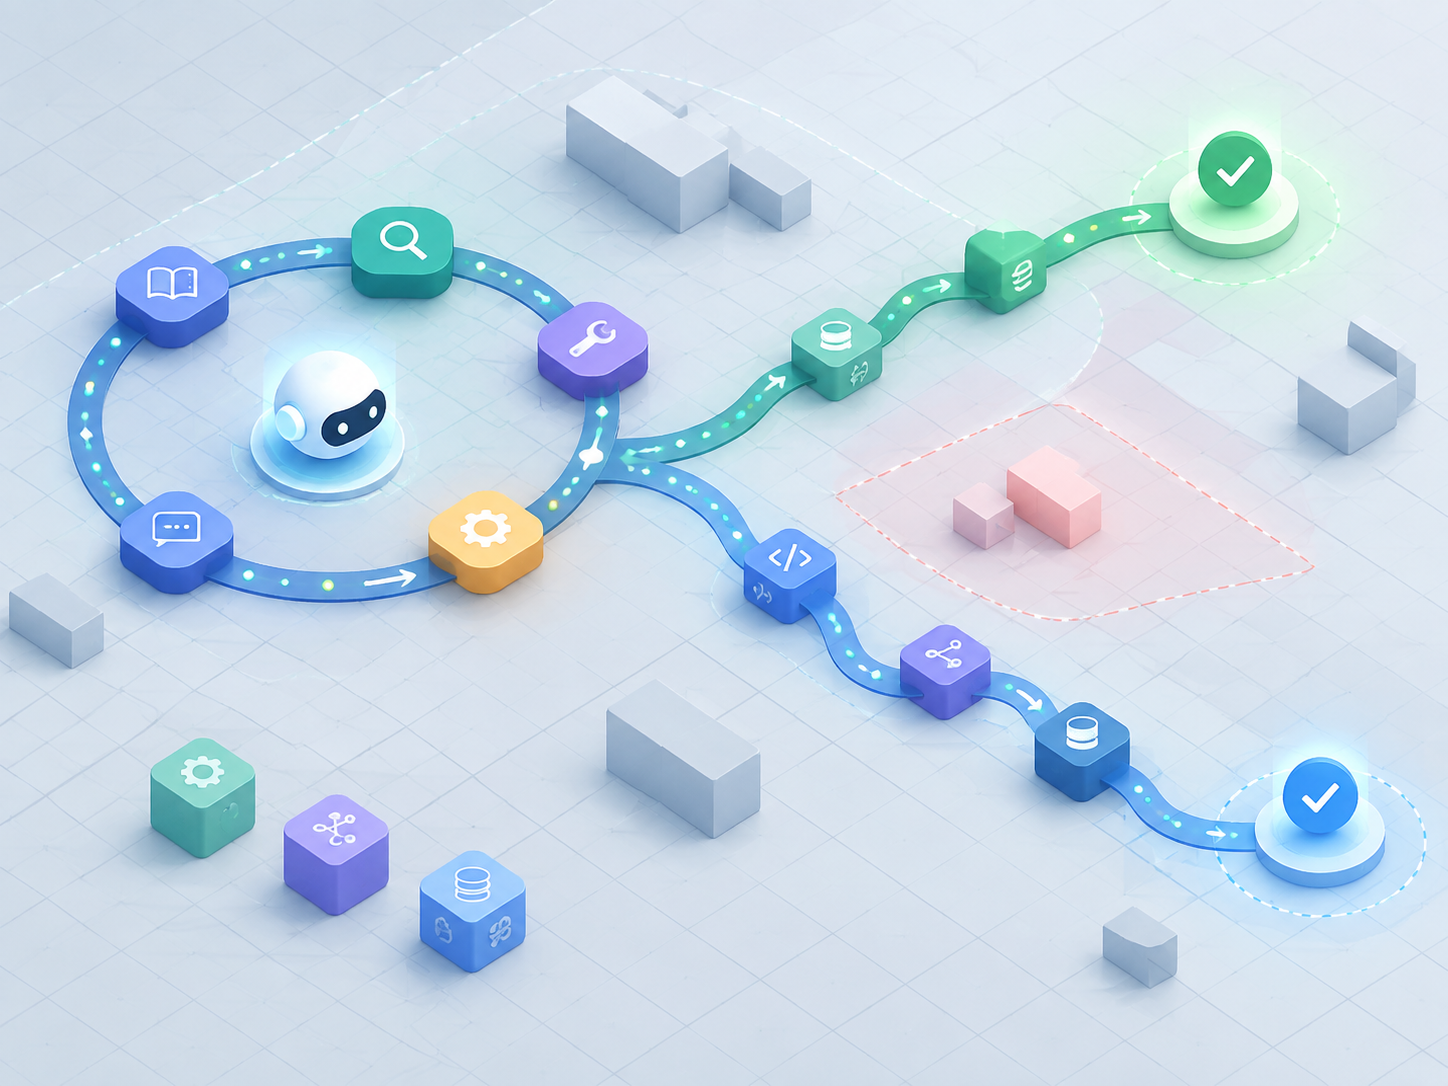
MiMo-V2.6 把代码、通用 Agent、视觉与网络安全任务放在同一套 RL 系统中,单次更新使用 1568 个 prompt,每个 prompt 生成 16 条 rollout,总计 25088 条轨迹。与传统“生成一段答案文本就结束”的模式不同,Agent 需要在环境中循环:读取→搜索→调用工具→执行→再根据反馈调整策略。训练对象从“最后答案”转向“整条行为轨迹”。
长轨迹带来两个直接挑战:
- 信号稀疏:仅靠“成功/失败”难以区分两条都完成任务的路径,哪一条更高效、更稳健。
- 授信困难:如何把最终奖励合理分配到中间关键决策与工具选择上。
因此,奖励机制必须重塑。更可行的做法包括:
- 引入密集/分段奖励,把关键中间指标(如测试通过率提升、搜索结果相关性、工具调用有效性)纳入信号;
- 设计轨迹层面的比较学习,让“同为成功”的路径也能按效率、稳定性、合规性分出高下;
- 利用环境反馈与安全约束作为负奖励项,抑制无效尝试与风险操作。
这类奖励设计,让模型不只学“能做成”,还学“怎么做更好、更安全”。
RL 像分布式生产系统:异步与长尾治理
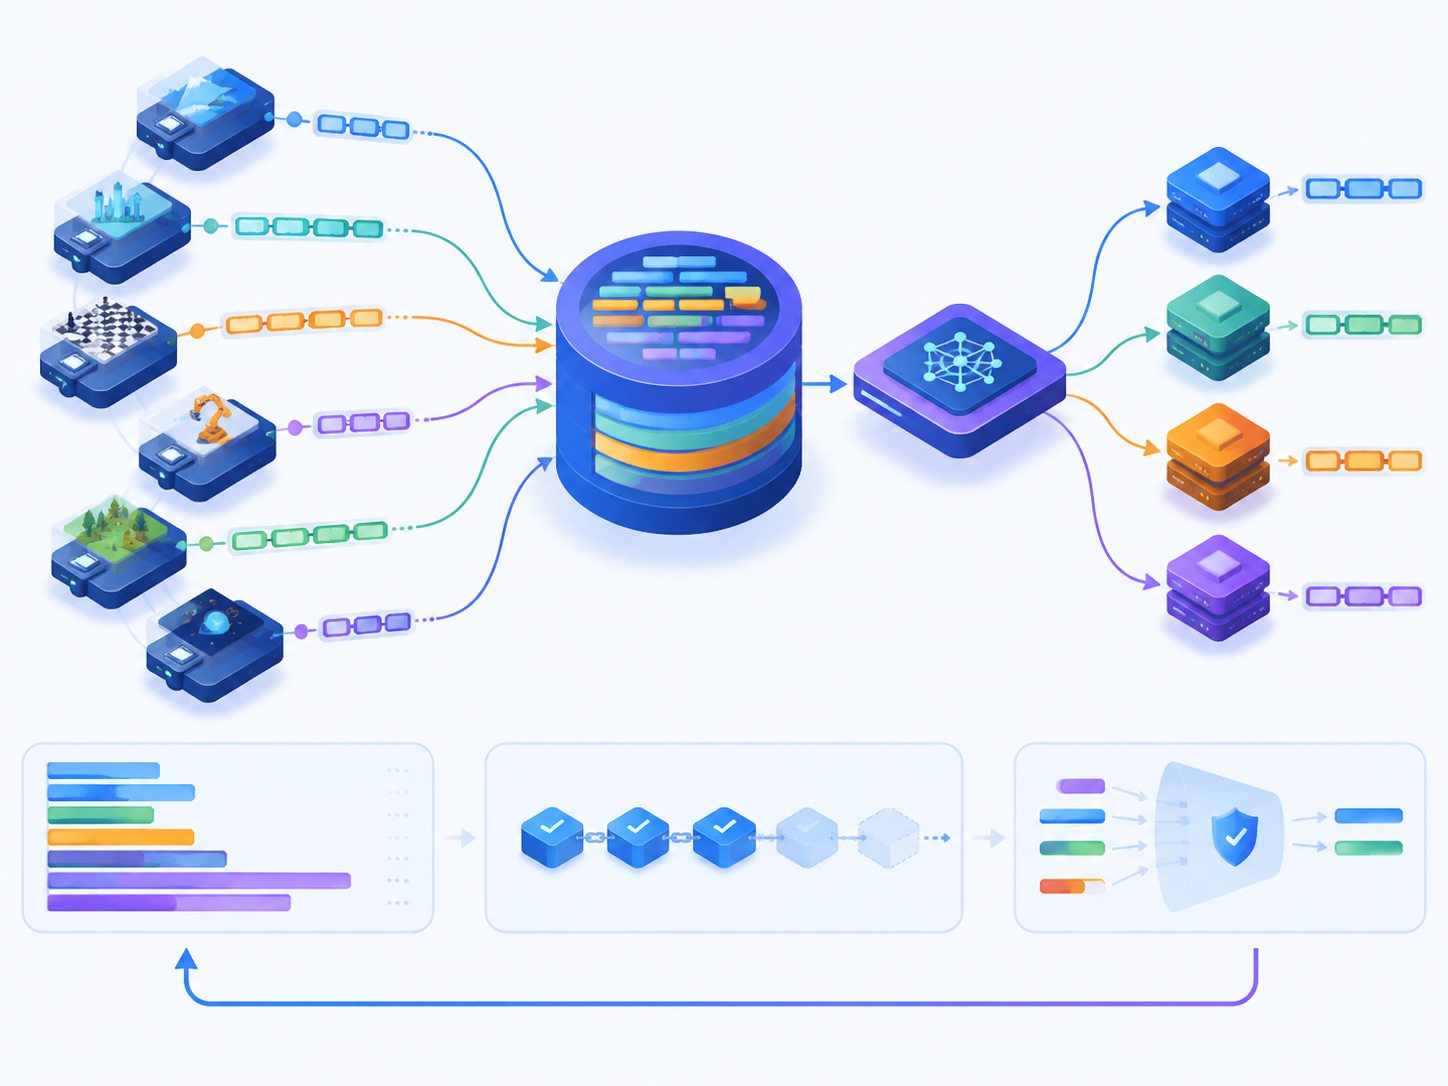
一次更新对应 2.5 万条轨迹,且不同任务的执行深度、环境延迟与工具链路差异巨大,长尾必然出现。如果采用严格同步,已完成的算力要等待少数“慢轨迹”,资源浪费严重。面向这种规模,训练系统需要具备“生产级”能力:
- 异步采样与更新:让已完成的轨迹先入池评估与更新,减少集群空转时间;
- 轨迹级调度与切片:对超长轨迹进行分段提交与检查点复用,缩短阻塞时间;
- 跨任务的负载均衡:按环境与工具响应特性动态分配 worker,避免某类任务拖慢整体进度;
- 在线质量控制:对回传的轨迹进行实时打分与过滤,优先消化高价值样本,抑制奖励欺骗与模式崩塌。
从这个角度看,MiMo-V2.6 的架构取舍与系统工程是一体两面:模型侧降低了单位步成本,系统侧则把异步与调度做成“吞吐放大器”,二者共同支撑了“用轨迹堆能力”的策略。
安全与多模态的一体化收益
把网络安全与多模态任务纳入统一 RL,不只是多加几个数据源,而是让“安全合规”与“有效行动”在同一个行为空间里博弈与收敛:
- 工具与权限约束可直接进入奖励或规则,形成可学习的红线;
- 视觉/视频/音频输入参与决策,使得真实世界感知与工具使用更紧密,减少“语言空间臆断”;
- 安全任务提供了对抗性场景,逼迫策略在高风险边界上也能稳定收敛。
这比单独做安全对齐更具实战意义:安全被嵌入任务本身,而非事后“加一道门”。
影响与展望
- 对行业范式的提示:参数量与上下文并非终局,后训练才是能力“成色”的决定因素。统一 RL、长轨迹与系统化奖励,正在替代“堆数据+微调”的旧路径。
- 对工程实践的启发:长上下文要与“局部高频、全局低频”的注意力结构相匹配;MoE 稀疏与推测解码不是锦上添花,而是 RL 可负担的前提。
- 对研发方向的挑战:如何在异步、多任务、长轨迹下保持稳定收敛,如何用轨迹层面的排序、密集奖励与安全红线抑制奖励黑客,是下一阶段的主战场。
- 对开发者生态的意义:以轨迹为核心的数据资产将更有价值;工具接口、环境模拟、日志与回放会成为新的“训练集”,催生一批面向 Agent 的数据与评测标准。
MiMo-V2.6 展示了一条更现实的路线:把模型做成一个能在环境里“长期工作”的系统,再用充足且高质量的轨迹去打磨策略。1M 上下文是入口,2.5 万条轨迹才是推动能力跃迁的真正杠杆。
标签: 大语言模型 强化学习 Agent 长上下文 MiMo
