10万亿参数赌局:大模型上限与代价
引言
“越大越聪明”的直觉正在把大模型推向一个新临界点:10万亿参数。阿里在云栖大会上将参数路线再次拉到聚光灯下,DeepSeek与字节也被曝正向同一门槛冲刺。这是技术路线的选择,更是资本、数据与算力的豪赌。问题是,10万亿参数究竟买到了什么?又会把行业带向哪里?
谁在加码10万亿:现状与动机
- 阿里公开规划:Qwen 4.5/5目标迈向5—10万亿参数,强调Scaling Law是通往更高智能的关键路径。
- DeepSeek据称已训练约2万亿参数的新模型,下一步瞄准8万亿。
- 字节据报道也在训练上限可达10万亿的模型。
已发布的国内模型里,Kimi K3总参数2.8万亿,阿里Qwen 3.8-Max约2.4万亿,DeepSeek V4-Pro约1.6万亿。对比海外估算,Anthropic头部模型已在5—8万亿区间。以10万亿为靶,国内现役旗舰普遍要再放大数倍。动因并不复杂:参数规模决定可达上限,上限决定排位与叙事权。尽管“好不好用”不等同“上限多高”,但下代平台门票往往由上限来裁定。
大不等于强:Scaling的前提与边界
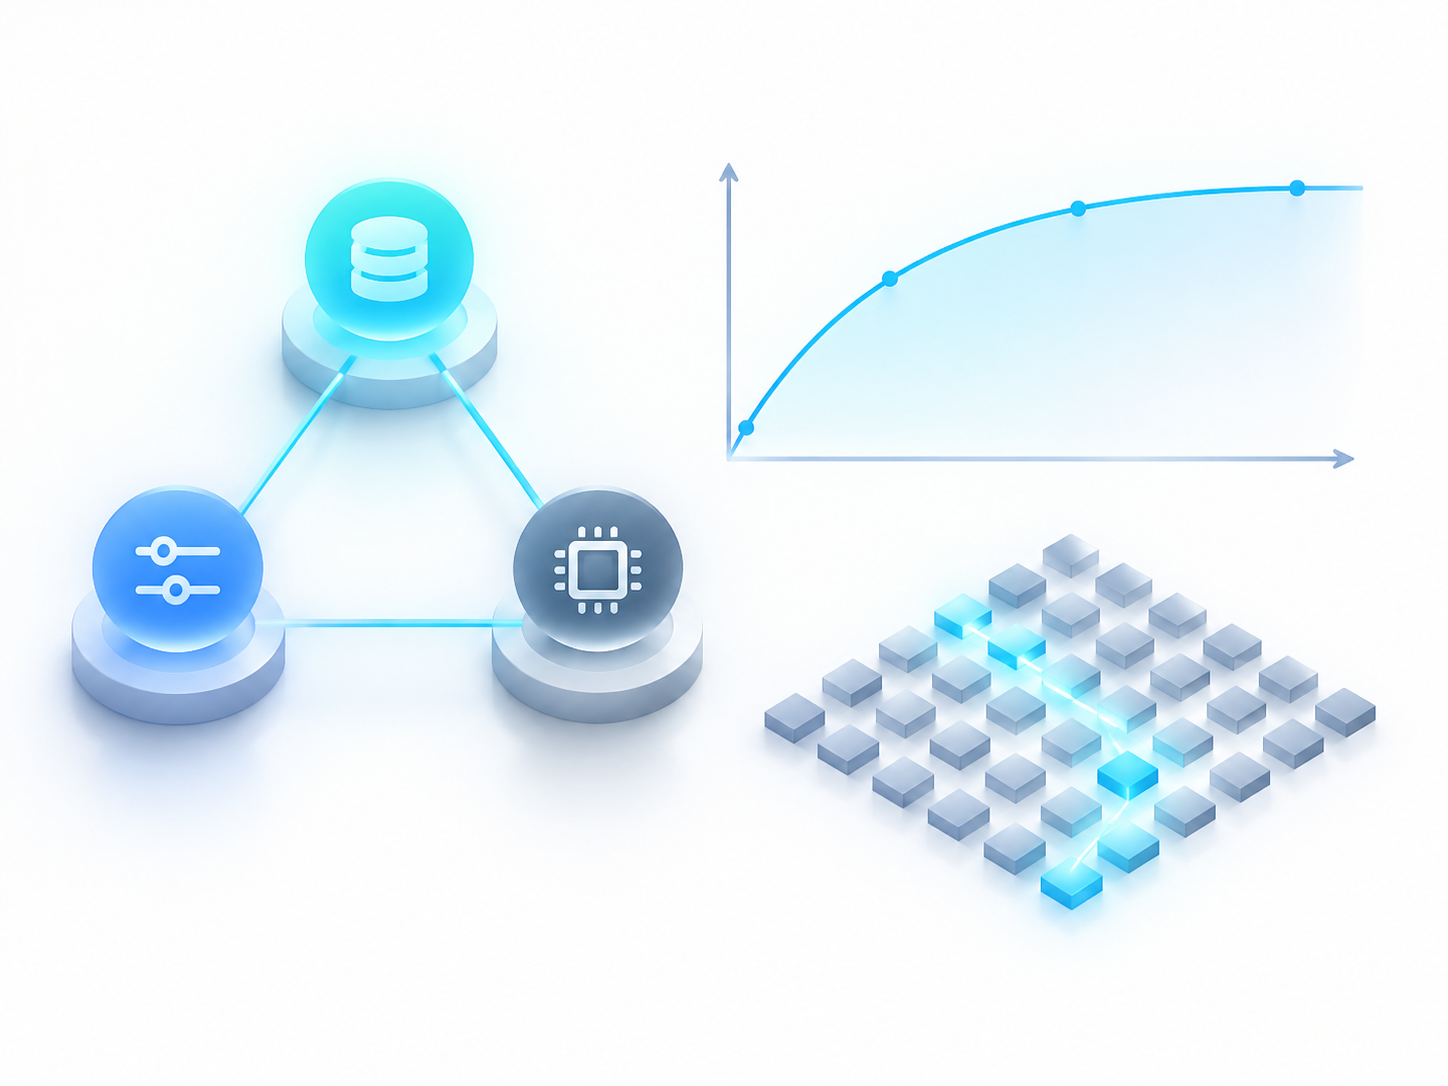
Scaling Law有效,但不是魔法。三要素必须同步放大:参数、数据与算力,且数据需要“足够多且足够好”。进入万亿级后,边际回报显著递减,数据质量与训练范式往往成为瓶颈。
- 架构差异很关键。Kimi K3采用MoE(混合专家),总参数2.8万亿,但一次只激活少量专家(例如896选16),实际激活约千亿级。这意味着“名义参数”与“推理时动用的参数”存在巨大差距。
- 训练配方同样影响巨大:指令微调、偏好对齐、过程奖励、检索增强、代码与工具使用等,常常能在不成比例扩容的前提下,带来可感知的跃升。
- 推理端体验是另一道门槛。参数越大,推理越慢,成本越高,延迟与价格会直击用户感受。对C端,响应时间和稳定性比“理论上限”更重要;对B端,TCO(总拥有成本)与可控性优先。
因此,“更大”是必要条件而非充分条件。10万亿的意义更多在于探索极限与能力天花板,而非立刻改善日常体验。
账本的真问题:算力效率与供给约束
10万亿参数带来的是真金白银的消耗:更长的训练时长、更密集的高端GPU集群、更高的电力与网络要求。海内外科技巨头的资本开支已快速抬升,国内大型厂商的投入同样激进。烧钱共识之下,真正决定胜负的是“单位算力能换回多少智能”。
可拆解为三条效率曲线:
- 训练效率:数据去重与蒸馏、分布式并行优化、混合精度、激活检查点、专家路由稳定性。
- 推理效率:MoE稀疏激活、KV缓存压缩、推测解码与并行采样、量化与编译器优化。
- 数据效率:高质量语料获取与合成、风格与领域覆盖、多轮推理链路的数据工程。
当这些“系统工程”做扎实,10万亿才不至于成为“昂贵的虚高”。反之,盲目扩参只会把成本曲线推向不可持续。
影响与展望
短期看,模型生态将分层清晰:
- 旗舰层:万亿级模型承担“能力上限”的探索与品牌制高点。
- 主力层:数千亿至低万亿、强MoE与强工具链,负责大多数商业工作负载。
- 端侧/边缘层:小模型与代理框架,强调隐私、低延迟与成本。
中期看,分水岭会从“参数数值”转向“能效与系统协同”:
- 以“每美元/每千瓦时的智能产出”作为新指标,优先级超越单一规模。
- 数据成为护城河:合成数据质量、过程监督与安全过滤决定微妙差距。
- 算法与工程并进:检索增强、程序化推理、工具与环境交互使“测试时算力”成为新变量。
长期看,10万亿是一把双刃剑。它为下一代智能打开门缝,也放大了能源、供应链与安全治理的压力。真正可持续的路径,可能是“大模型+小模型+工具链”的协同体:用旗舰探索上限,用工程把能力“折现”为可负担、可复制、可验证的生产力。
当尘埃落定,赢家不只是在参数上跑得更远的一方,更是把“规模红利”精准转化为“单位成本下的真实价值”的团队。
标签: 大模型 Scaling Law 算力 10万亿参数 MoE
