TPUv7逆袭GPU:巨核配DSpark揭秘
引言
同样是16片芯片、同样的vLLM推理引擎、同样的Kimi K3模型,换了底层硬件,速度却能差出57%。这一轮“逆袭”来自TPU v7,以及一家出自vLLM团队的创业公司 Inferact:通过自研的“megakernel”推理内核,叠加DeepSeek提出的DSpark推测解码,让TPU在Kimi与Qwen等模型上把性能拉到接近硬件极限。更有意思的是,TPU的HBM带宽甚至不占优,这次胜出的关键几乎完全在软件层。
为什么TPU能赢GPU:瓶颈在“搬数据”,胜负在“软件”
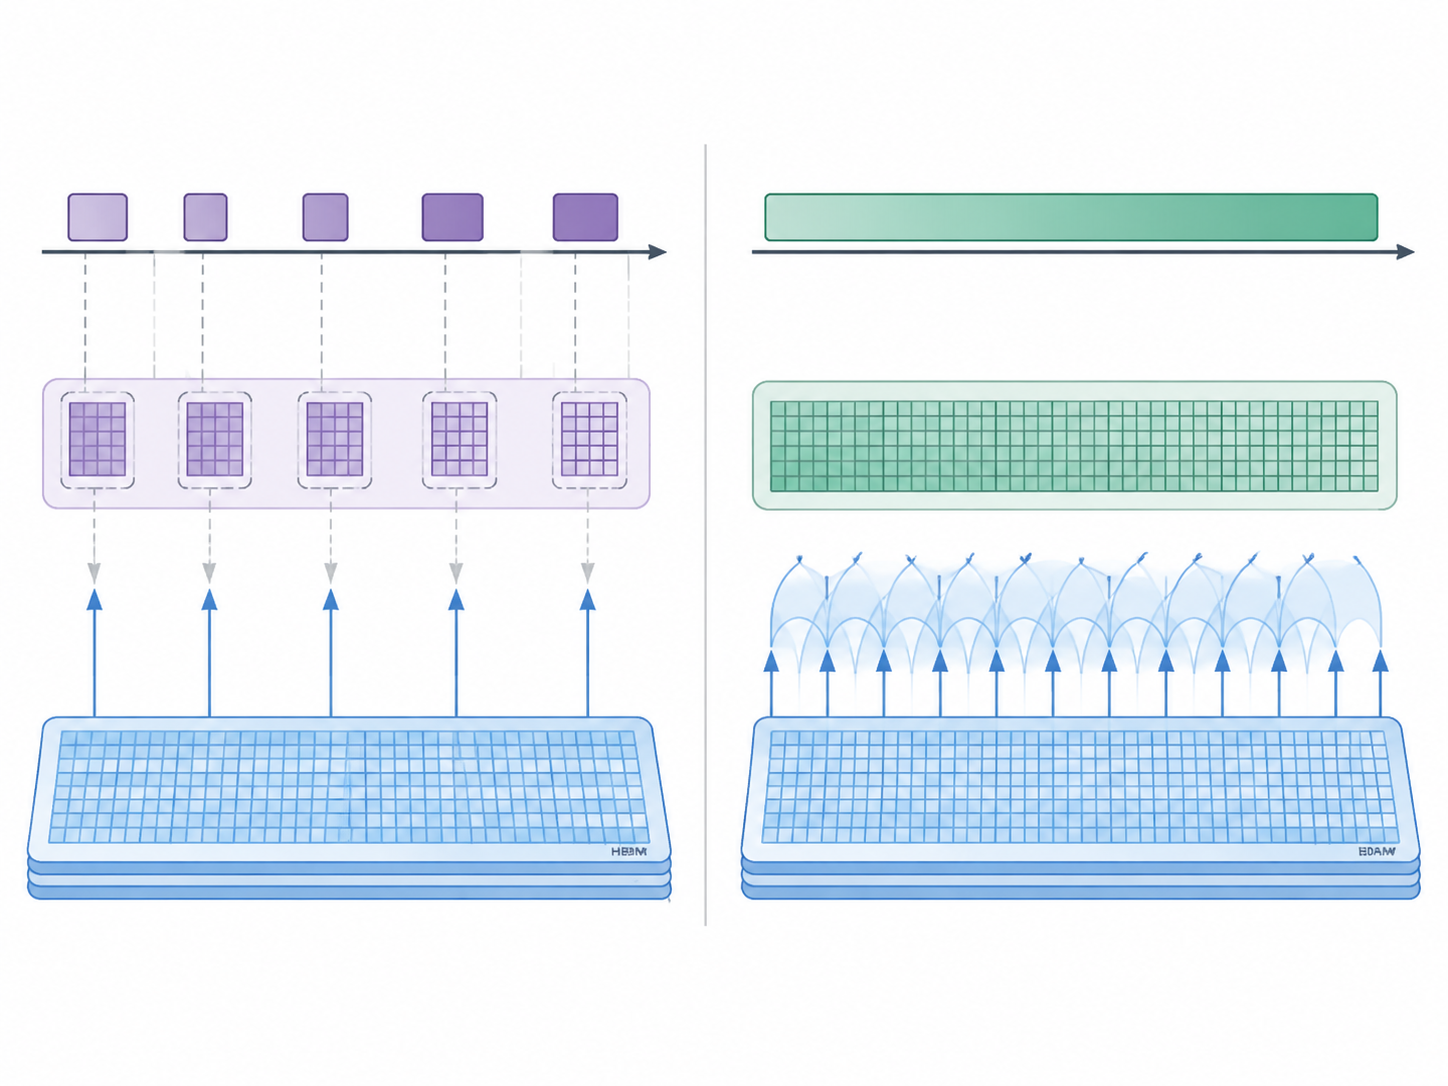
在大模型推理中,计算并非绝对主角,真正的瓶颈往往是从HBM把权重“搬”到片上缓存的过程。传统做法会把一次前向传播拆成数百个小kernel逐个调度,kernel之间的切换与等待使带宽周期被“撕裂”,形成大量空转。
Inferact的解法是把“碎片”焊成“整板”:用一个称为megakernel的大内核一次覆盖模型全路径。以Kimi K3为例,92层MoE被塞进一个Pallas程序里,单次调用贯通整个前向。这样一来:
- kernel边界被抹平,切换损耗接近消失;
- 可在层间做跨层权重预取:第N层计算未完,第N+1层权重已在路上;
- 片上内存与数据通路被连续“拉满”,带宽利用率逼近理论上限。
有趣之处在于,NVIDIA已在通过CUDA Graphs、PDL等技术缩短kernel间隙,但边界仍客观存在;而megakernel用“彻底融合”的路线,绕开了边界本身。这与TPU的片上内存与编译栈(XLA/Pallas)天然契合,形成了“软件定义内存效率”的优势。
关键对比数据也说明问题:TPU v7的HBM带宽约7380 GB/s,GB200约8000 GB/s,账面带宽并不落下风的反而没跑赢。换句话说,这次的领先来自调度与数据流组织,而非原始带宽。
DSpark推测解码:吞吐的“第二增压器”
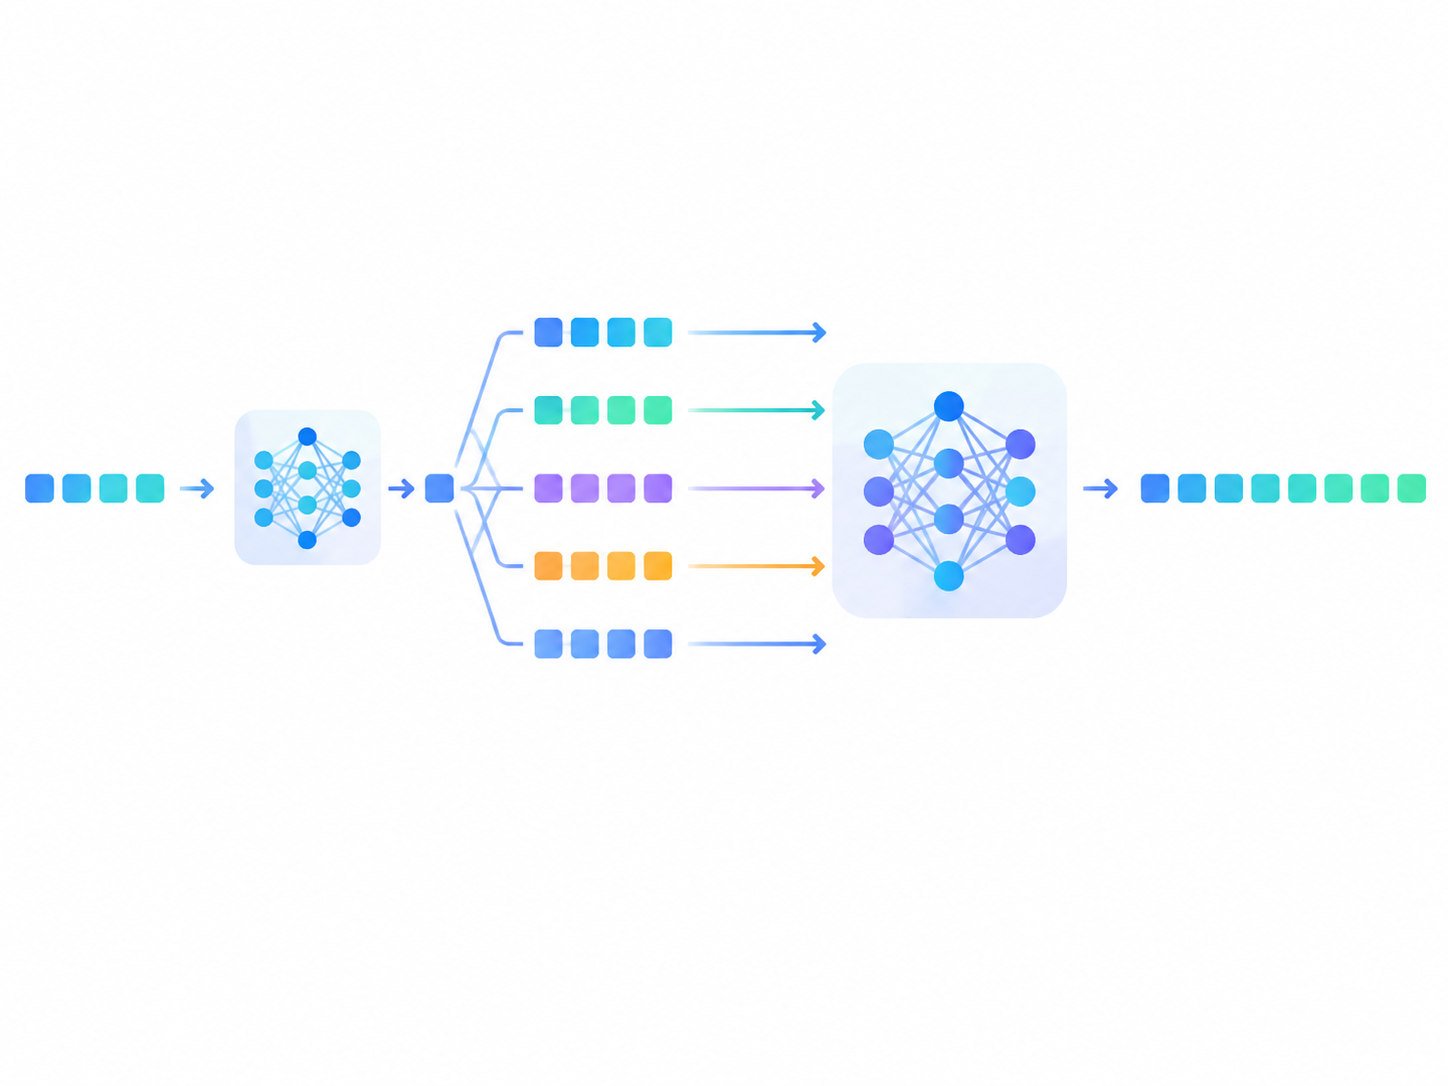
在megakernel打通底层后,Inferact又叠加了DeepSeek的DSpark推测解码。其基本思路是:
- 让小模型先“草拟”一串候选token;
- 大模型批量验证,命中则直接接受,错了再回退。
这带来的好处是把顺序依赖的解码转化为更“批”的验证过程,从而显著提升吞吐。在这次实践中:
- acceptance length≈6,即每轮平均有6个token被一次性接受;
- 单步decode延迟约8.5ms;
- 在16×TPU v7上,Kimi K3达到了709 token/s,对比16×GB200的452 token/s,提升57%。
更重要的是,即便关闭推测解码看“裸速”,TPU依旧占优:
- batch size=1:TPU 249 token/s,GB200 127 token/s;
- batch size=8:TPU 865 token/s,GB200 636 token/s。
在Qwen上差距更大:4×TPU v7跑Qwen 3.8 27B为1515 token/s,同配置的GB200为695 token/s。精度方面,使用greedy decoding在GPQA-Diamond、GSM8K等指标上与GPU一致,说明优化主要来自系统层与执行路径,而非“以精度换速度”。
来自vLLM系的系统工程胜利
Inferact由vLLM原班人马创办,拿到a16z领投的高额种子轮,本质上是把“推理即系统工程”的方法论推进到TPU生态:在编译器、内核、内存层次结构上联动设计,让调度逻辑为硬件拓扑服务。几个关键点值得关注:
- 内核融合程度加深到“整模级”,而非层内、块内的小范围fusion;
- 利用Pallas等DSL在TPU上构建跨层流水,持续填充片上资源;
- 在MoE结构下做面向专家路由与下一层预取的协同,避免因稀疏激活产生的带宽抖动;
- 保持与vLLM推理栈的接口一致,降低工程迁移成本。
从产业角度看,这是一场“软件先行”的样板:当软件足够理解硬件、并能重写执行路径时,账面峰值不再决定一切。
影响与展望
这次结果不只是一条性能新闻,更预示了几个趋势:
-
硬件竞赛将转向“软硬件联动”
带宽和算力只是地基,调度与数据流才是上层建筑。GPU阵营势必会以更激进的kernel融合、异步流水与编译器优化回应,Triton、PDL、图执行器以及“超大kernel”将成为主战场。 -
MoE与推测解码成为常态
稀疏激活+speculative decoding正在构成推理的“新默认”,吞吐与延迟的平衡点将被系统性上移。acceptance length、批量验证吞吐、回退代价等指标值得成为一线观测数据。 -
云端选型更看重“实测/成本比”
在同等芯片数量下,TPU的实测吞吐领先扩大了“以软换效”的筹码。企业在选择云上算力时,需要关注:可用的系统优化栈、开源程度、维护复杂度,以及能否在自身工作负载上复现实测数据。 -
工程挑战仍在
megakernel对模型结构、算子稳定性、编译栈健壮性提出更高要求,通用性与可维护性需时间检验。多模型、多租户场景下的资源隔离与服务质量保障,也需要匹配的新调度策略。
下一步可以预期:GPU侧将尝试把“整模级fusion”制度化;编译器/DSL层面会出现更多面向MoE与推测解码的原语;同时,模型设计会反向适配系统路径,在门控、KV缓存、位置编码等细节上为流水线与预取优化让路。
无论最终格局如何,这次TPU的领先已清晰表明:大模型推理的上限,很大程度上由“如何组织数据与执行”来决定。把碎片化内核变成一条高效“生产线”,正是打穿带宽天花板的现实路径。
标签: TPU 推理加速 DeepSeek vLLM megakernel
