Claude多智能体:真发现还是线索?
引言
人工智能走进实验室,正在改变科学研究的“发现流程”。最近,Anthropic 宣布其分子生物学实验室采用多智能体系统(Claude agents)筛读生物数据、提出猜想,由人类科学家执行实验,并声称完成了“首次发现”。具体而言,950 个智能体在 21 小时内并未找到全新的基因序列,而是捕捉到围绕某已知酶的重复序列模式,并将其类比为“让人联想起引领 CRISPR 的线索”。这一表述引发生物学界反弹:找到“奇怪的重复与基因簇”并不稀罕,真正的发现来自阐明其功能与可操控性。由此,一个关键问题被摆上台面:何时才可以说“AI 做出了科学发现”?
“发现”的边界:从看见到能用
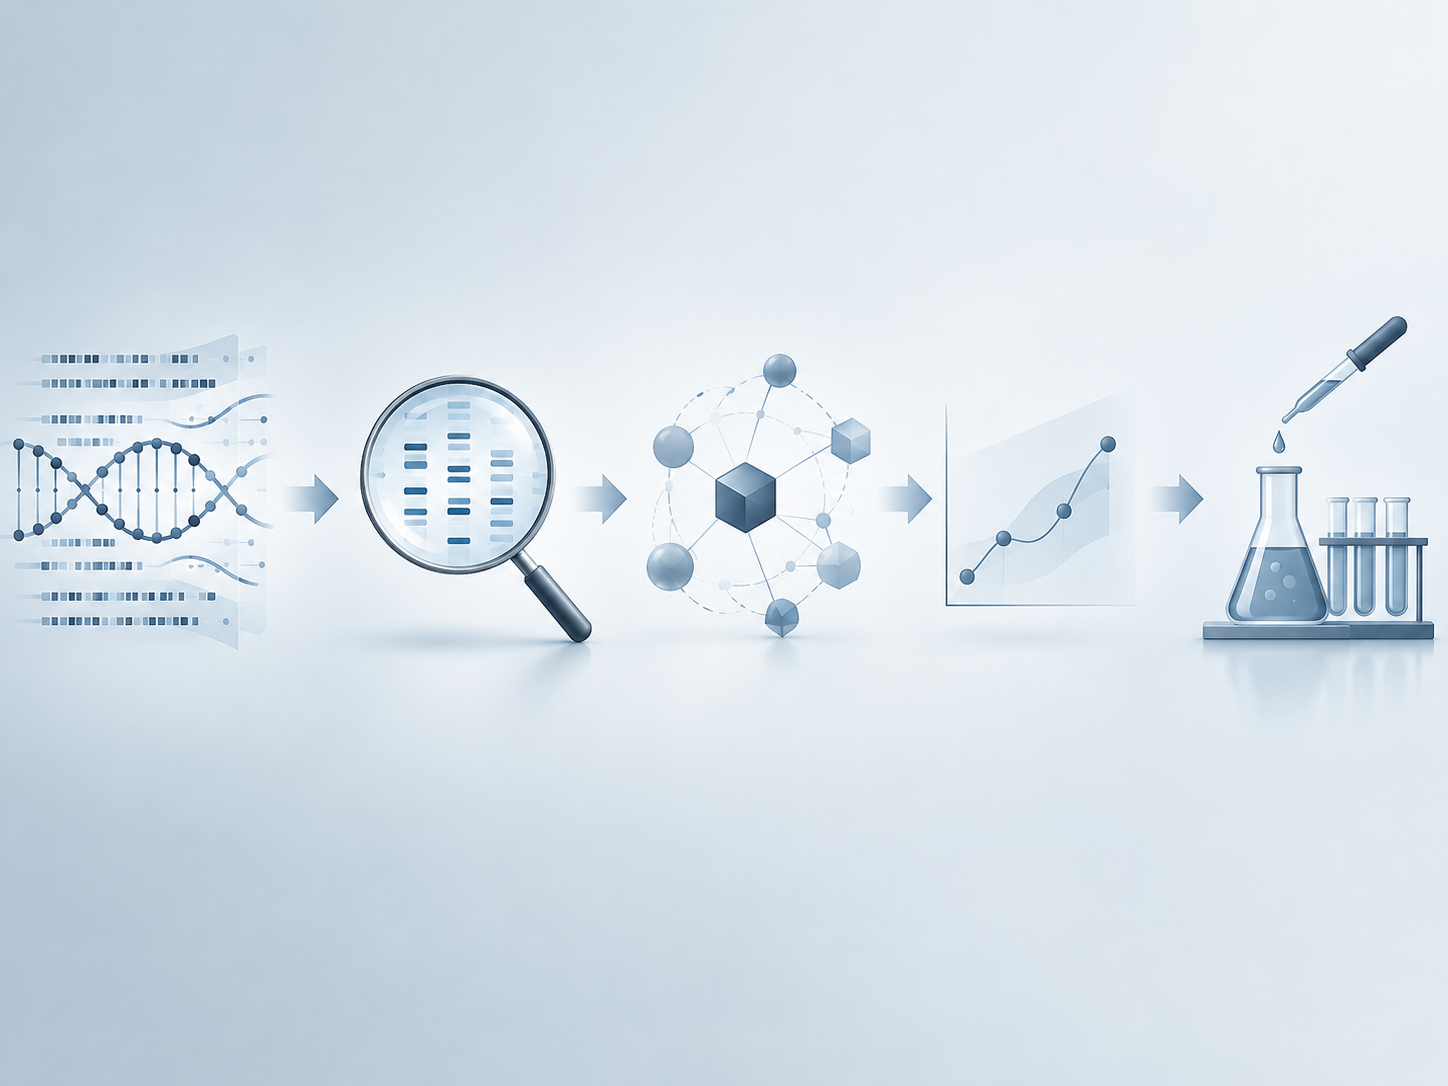
科学史告诉我们,发现并非单点事件,而是阶段性链条:
- 观察与检索:识别异常现象或模式(如重复序列、异常信号)。
- 假说与解释:提出可检验的机制性叙述,而非仅仅相似性比喻。
- 预测与验证:在未知样本或新条件中作出可被实验打败的预测,并被独立复现实证。
- 干预与应用:能被操控以实现可重复、可迁移的效用(工具、方法或新原理)。
以 CRISPR 的历程为例,早期的重复序列观察只是起点;关键是阐明细菌免疫机制、验证 Cas 蛋白的作用,并将其转化为通用编辑工具。由此衡量,多智能体指出“可疑模式”属于第一阶段的“线索发现”,距离“科学发现”的充分条件尚有数步之遥。
AI 在实验闭环中的角色与局限
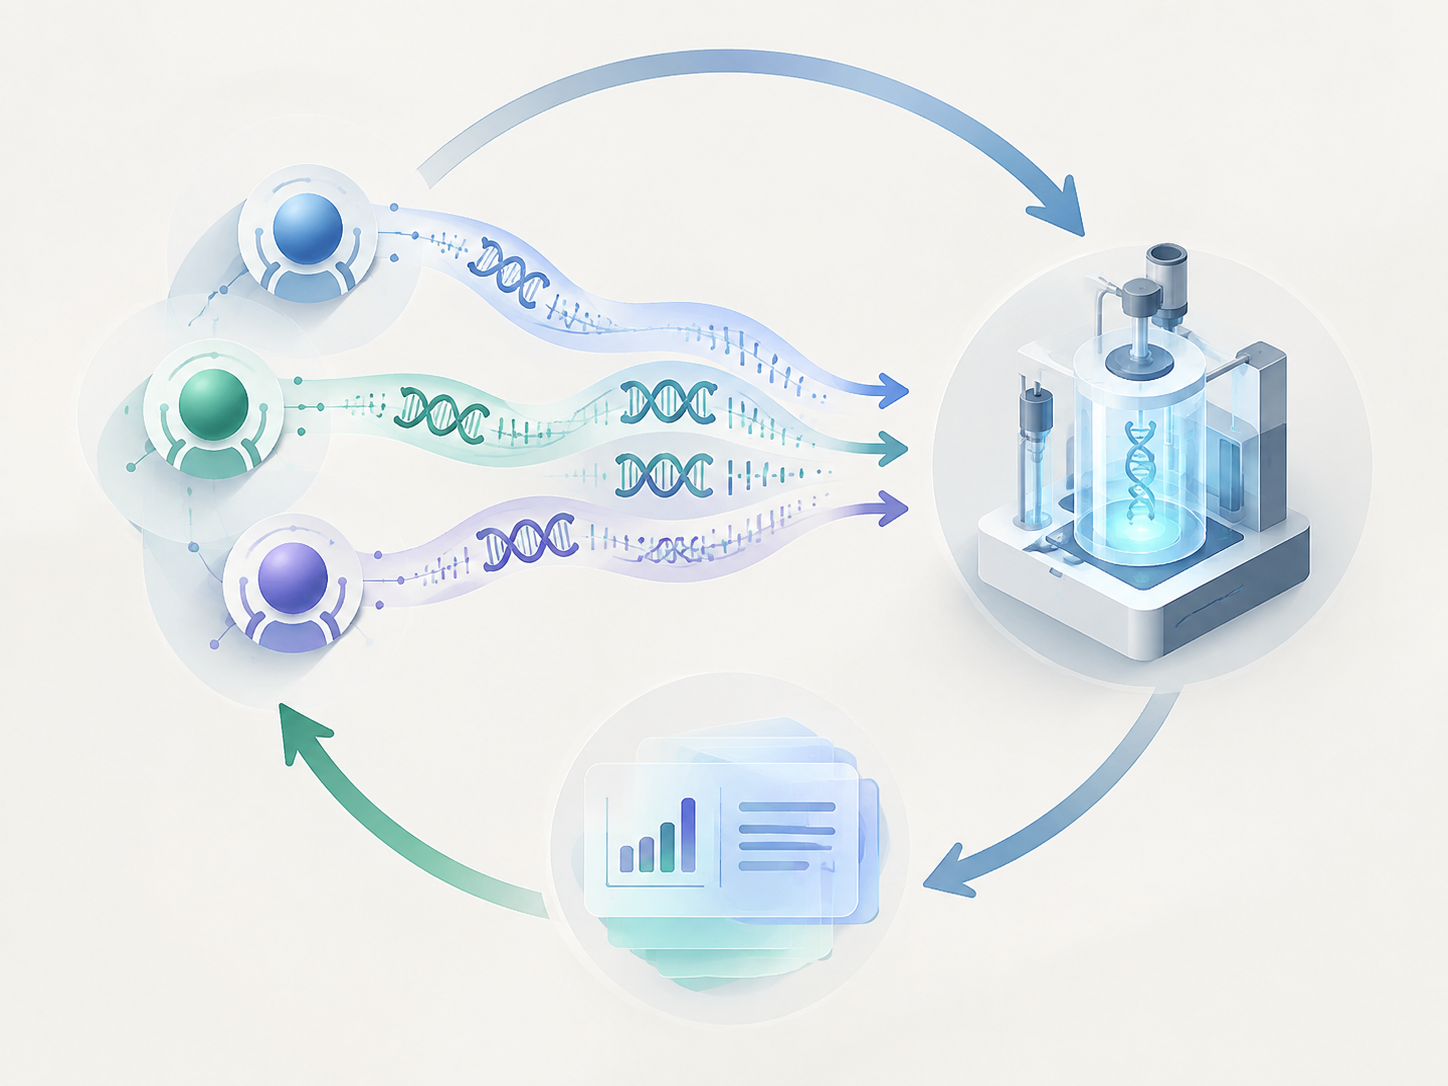
多智能体在大规模序列库中寻找模式,具备明显优势:
- 广度与速度:高通量筛查、跨物种对比、组合式搜索。
- 假说生成:将文本、生物序列、文献证据拼接成候选假说列表。
- 试验优先级:结合统计与先验知识,优化实验资源配置。
但也面临先天局限:
- 语境与因果:从相关性模式跳到机制解释,往往需要生物学语义与因果证据支撑。
- 模式幻觉与多重比较:在海量数据里容易“看花”;若无严谨校正,假阳性激增。
- 信赖与可追溯:黑箱式推理链难以被同行审查、难以复用或复现。
在“人—机—实验”闭环中,表述与归功应更细化。建议以标准化术语区分:
- 线索检测(AI):从数据中提出异常或模式。
- 假说形成(人/机):明确机制路径与可证伪预测。
- 证据确立(实验):完成对照、盲测、独立复现。
只有当 AI 的贡献跨越假说形成与预测成功,并经独立复现支撑时,“AI 完成发现”的说法才更稳健。
可操作的判据:给“AI 发现”立规矩
为避免“词藻领先证据”,可以采用几条试金石:
1) 新颖性与可检验性
- 明确指向此前文献未报道的关系或效应,并附带可操作的检验方案。
- 提供可证伪预测,而非事后解释或类比渲染。
2) 预测与干预成功
- 在未参与训练的数据或新体系中,预测得到验证。
- 通过干预改变系统行为,显示因果链条(不仅是共现)。
3) 复现与同行评议
- 独立团队在独立平台复现核心结果(包括负结果披露)。
- 经过严格评审,并公开必要的计算与实验记录以供审计。
4) 归属与透明
- 清晰注明 AI 在流程中的具体作用与人类贡献,避免将“线索”包装成“发现”。
- 记录推理轨迹与数据版本,保证可追溯性与责任边界。
对企业与研究机构,还可引入“发现卡片”(Discovery Card)制度:以统一模版披露新颖点、证据等级、验证状态、可复现实验清单与风险评估,降低公众沟通中的夸大倾向。
影响与展望
正面来看,AI 正把科研从“匠人式试错”推进到“算法化探索”。多智能体可作为高通量的假说引擎,显著缩短从数据到实验的路径。这意味着真正的突破可能不在“AI 一次性发现了什么”,而在“AI—实验闭环”持续迭代中累积出的可验证增量。
然而,若宣传过度,把“模式线索”描述为“重大发现”,会带来三重负效应:
- 侵蚀信任:公众与学界对 AI 科研声明的信噪比下滑。
- 资源错配:跟风投入围绕“热词”的项目,挤压严谨验证所需的时间与资金。
- 安全与伦理盲区:在生物领域尤其敏感,缺乏审查的自动化探索可能触碰双重用途风险。
更健康的路径,是向 AlphaFold 所代表的“工具型里程碑”学习:不是宣称“发现了蛋白质”,而是提供可靠的预测能力,赋能社区去完成真正的机理与应用发现。未来,随着可编程实验平台、自动化实验室与可审计的多智能体系统成熟,AI 有望在从“发现模式”到“阐明机制”的跨越上发挥更直接的作用。但前提是建立清晰的判据、透明的流程与可复现的标准,把“发现”的话语权交还给证据本身。
标签: AI科研 科学发现 多智能体 生物信息学 学术规范
