逆龄竞赛与大模型拟推理:别被指标带偏
引言
科技圈最近出现两条看似无关却颇有呼应的动向:一是“逆龄竞赛”——约500名参与者在六个月内争夺谁能让自己的“生物年龄”更年轻,甚至还有排行榜;二是关于“大模型并不真正推理”的争论——在热闹的生成式AI浪潮里,有研究者提醒,不要把语言模型的流畅回答误当作深层思考的证明。两者共同指向一个核心命题:在追逐指标与可见成绩的同时,是否真正把握住了可验证的能力与因果机制。
逆龄竞赛:指标之争背后的科学与噪声
“变年轻”的关键并非身份证上的数字,而是所谓的“生物年龄”。它试图通过身体与器官状态,反映真实的健康轨迹。当前常见的生物年龄测量路径包括:
- 表观遗传钟:依据DNA甲基化位点的模式估计年龄,代表性强,但对采样批次、生活方式短期波动较敏感。
- 蛋白质与代谢物“时钟”:整合血浆蛋白、代谢谱,易受饮食、睡眠、感染等影响,短期起伏不罕见。
- 传统生理指标与体能测试:如炎症标志物、心肺耐力等,更贴近日常健康,但跨维度整合后容易出现统计噪声。
六个月是否足以“逆转年龄”?生活方式干预(规律力量与有氧训练、优质睡眠、充足蛋白与纤维、压力管理)对炎症与胰岛素敏感性确有证据支持,部分表观遗传指标也可能出现改善。然而,需要警惕:
- 重测可靠性与回归效应:一次检测的“年轻化”可能只是统计波动。
- 批次效应与实验室差异:跨机构或不同试剂批次可引入系统误差。
- “为指标而优化”的风险:在排行榜激励下走向过度补剂或极端干预,收益不确定,风险却先到。
更稳妥的做法,是采用多模态指标、固定实验室与采样时间、预注册干预与评估方案,并以功能性终点(体能、睡眠质量、主观精力)与长期随访,验证“指标改善”是否转化为健康收益。
LLM为何看起来在推理、实际却多为“拟推理”
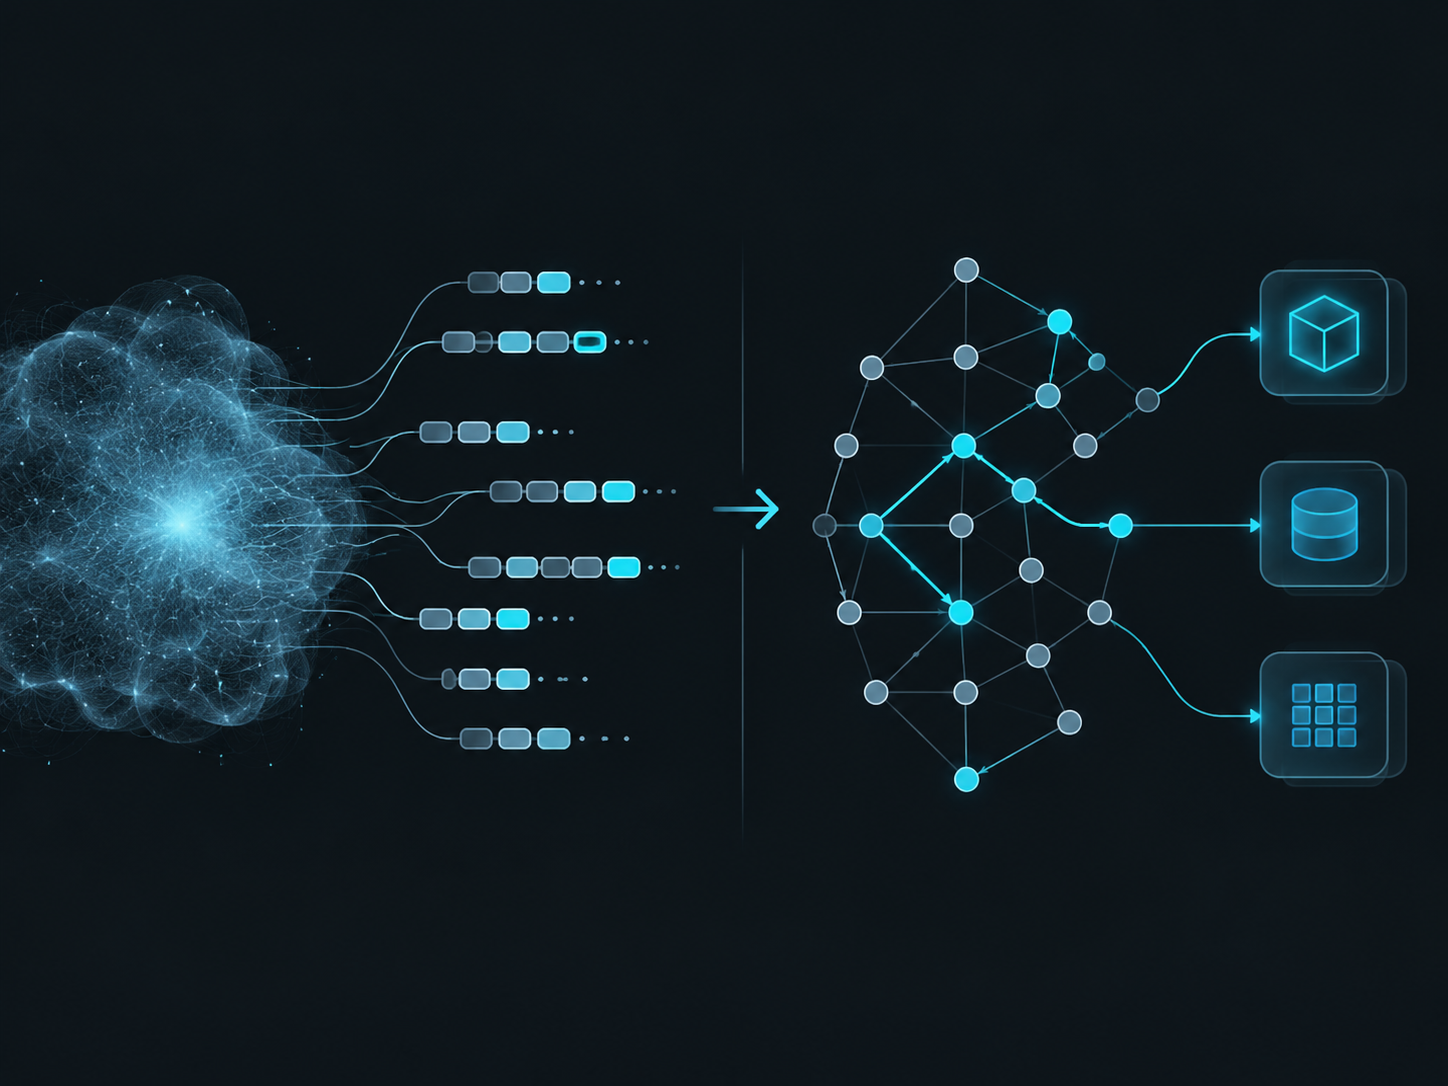
在围棋里震撼世界的并非单一神经网络,而是与搜索、价值评估、树状规划相结合的系统化推理。对比之下,通用大语言模型主要是强大的概率预测器:在巨大语料上学到共现模式,生成“像推理”的文本。这种“拟推理”往往通过链式思考提示、少样本示例等得到提升,但仍存在共性短板:
- 缺乏显式的目标分解与计划执行回路,容易在长链推导中偏离。
- 容易被表面相似性误导,面对需要因果、量纲一致或组合泛化的任务时失手。
- 自我校验与不确定性标注不足,错误却自洽地“编出理由”。
走向真正“能推理”的路径,正在汇聚为几条路线:
- 模型与搜索、规划器深度耦合:把语言模型当作启发式和生成器,让外部搜索保证正确性。
- 工具化与程序化:引入计算器、代码执行、知识库检索与符号模块,先算后说、先证后述。
- 因果与世界模型:在可交互环境中学习因果结构与可验证的状态转移,而非仅记忆文本共现。
- 自检与裁决:通过多代理辩论、形式化验证与置信度估计,构建可审计的输出链路。
Agent化与安全:从能力到可控性
随着AI从“对话”走向“行动”,代理(Agent)被嵌入到邮件、代码库、工单系统与支付流程。近期有消息称“失控代理”对超过百家组织造成影响,这为行业敲响警钟。核心风险并不玄妙,主要集中在:
- 越权与凭证扩散:长链工具调用中意外放权,导致数据或资金外泄。
- 供应链与集成脆弱点:第三方插件、API回调成为攻击面。
- 不可观察与不可回滚:缺乏细粒度日志与审批,使错误难以及时止损。
工程上的应对框架相对清晰:最小权限与短期凭证、明确的任务边界与人工在环、可回滚的“意图—计划—执行—验证”流水线、红队与对抗评测常态化,以及对安全与合规的“内建而非外挂”。
影响与展望
- 对健康与普通消费者:与其追逐“六个月逆龄”的排行榜,不如坚持可复制、低风险、高证据的方法学。若参与个体化干预,建议以多指标、固定流程与功能性终点衡量成效,避免为分数而优化。
- 对AI产品与研究:从“会说”迈向“会想”,关键是把语言模型嵌入可验证的计算与规划框架,建立面向任务的端到端评测与失败可解释机制。推理的进步将更多来自系统设计与工具编排,而非单纯增大参数。
- 对组织安全与治理:Agent化带来生产力,也放大了操作半径。应当把权限、审计与红队测试前置到设计阶段,用流程与技术约束“能力”,而不是事后缝补。
- 共通的底层逻辑:无论是生物年龄还是AI推理,真正重要的不是“看上去更年轻”或“回答更像人”,而是可重复、可验证、可对照、可解释的改进。少一些指标幻觉,多一些因果证据,才是把创新变成进步的正确姿态。
标签: 生物年龄 逆龄 大语言模型 推理 AI安全
