大模型一体机为何缩水?AI BOX崛起
引言
过去一年,大模型一体机从“高举高打”的满血配置,迅速转向“精打细算”的轻量方案。最早一波热潮中,很多机构以百万元级预算抢购能跑超大参数模型的设备,期待“一机在手,万事不愁”。但随着模型形态、供给价格与真实需求的变化,市场迅速冷却,一体机开始“缩水”。这不是简单的降配,而是一轮围绕场景与性价比的产业重构。
一体机何以“缩水”:四个主因
需求端从“追大”到“求稳”
- 大量落地场景集中在知识库问答、公文与业务文案等,蒸馏后的小模型就能覆盖八成以上需求。
- 对多数企业,瓶颈在流程与数据治理而非算力极限,追求671B的“满血”意味着长期闲置的能力冗余与较高的TCO。
模型能力密度提升
- MoE稀疏激活、蒸馏、量化等技术成熟,让“更小模型,接近同效能”的路径成为可行。
- 新一代框架更重并发与延迟优化,“单位参数的有效产出”提升,极大弱化“参数即能力”的直觉。
高端芯片供给与生态掣肘
- 高端GPU供给波动,国产加速卡虽在显存与吞吐上进步,但单卡跑超大MoE仍吃力,需要多机并联,带来调试复杂度与软件生态适配成本。
- 满血一体机普遍8卡起步,集群效应无法发挥,算力效率不如云端或专用集群。
成本侧压力叠加
- 内存、SSD等关键部件涨价,抬高本地满血部署成本。
- Token价格走高,倒逼企业优化推理链路与并发管理,倾向“以小搏效”的工程实践。
市场被劈成两半:AI BOX走量,满血机守特定场景
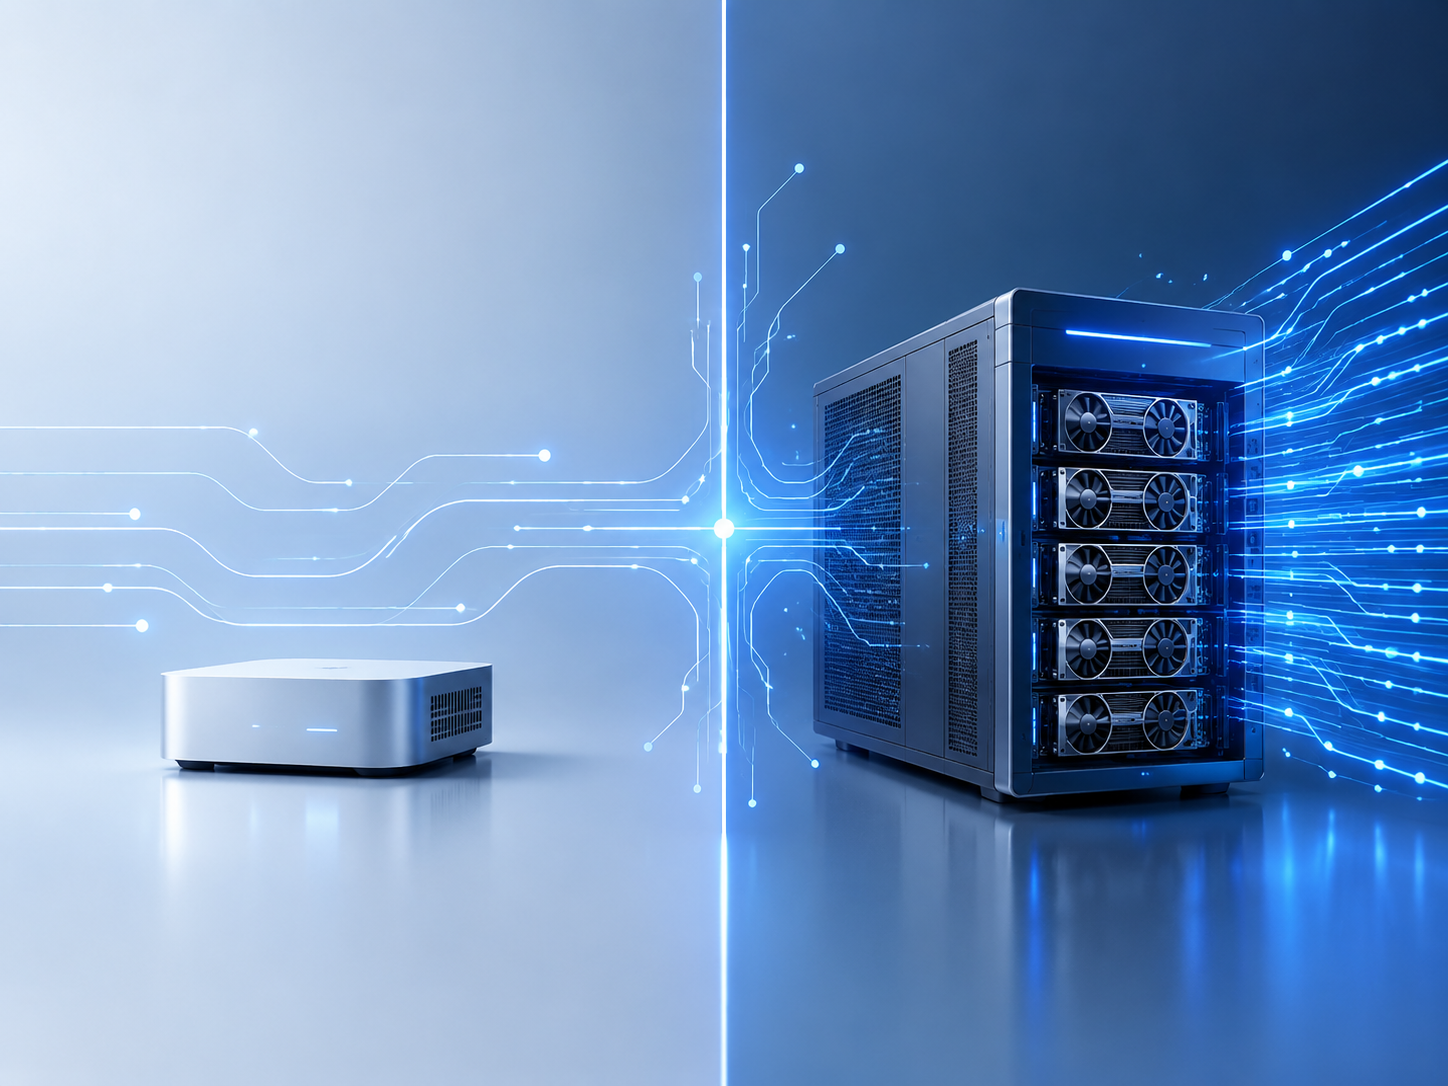
轻量化的“AI BOX”撑起出货大盘
- 主流配置面向32B/70B级模型,强调即插即用、低功耗、低噪音、易运维。
- 核心卖点从“能跑多大模型”转向“并发能力、稳定性、场景集成与运维服务”,产品化程度明显提升。
- 此类设备成为知识员工具、行业Copilot、私有知识检索与小型Agent的基础设施。
满血高端机缩量但不消失
- 采购集中在强合规行业与核心生产场景,如央国企、金融、能源等。
- 典型应用包括:长链路Agent执行、Vibe Coding等工程级研发、专业视频生成与多模态复杂推理,这些任务对延迟预算、上下文深度与推理稳定性要求更高。
- 高端机更多与集群、专线存储与企业安全体系耦合,呈“少量、定制、深集成”的形态。
二手设备“账面升值”的冷思考
- 在部件涨价周期,早期购入的一体机出现二手溢价并不罕见,甚至有项目组靠转卖设备“止损为盈”的案例。
- 但二手硬件常见保修失效、固件兼容、功耗过高等问题;要跑新一代MoE/Flash类模型,多需框架改造与驱动升级,隐性成本不低。
高端一体机的现实价值:三类“非它不可”的任务
长链路与强约束Agent
- 任务链条长、需要跨工具与跨系统协同,且要求低延迟与高稳定性时,本地高端机能减少网络不确定性并保障敏感数据合规。
- 支撑更长上下文、更精细计划与回溯机制,降低复杂Agent在云端的Token开销。
工程级代码与复杂检索
- 大规模代码库、跨服务依赖分析与安全审计,需要强推理深度与高吞吐的本地推理以提升迭代效率。
- 与内部CI/CD、制品库与私有知识图谱深度连通时,本地满血部署的工程价值更明显。
专业视频与多模态生成
- 高分辨率、多镜头、多约束的视频生成与编辑,对显存、带宽与IO提出更苛刻要求,云端成本与延迟难以优化时,本地高端机更具可控性。
采购与落地建议:从“堆参数”到“算场景”
以场景-模型-硬件协同为中心
- 明确核心任务:问答/撰写、Agent执行、代码开发、视频生成分别匹配不同模型规模与硬件配置。
- 以并发与延迟指标取代“参数崇拜”,选择支持多租户、限流与弹性调度的一体机软件栈。
做好TCO与演进规划
- 比较“云端调用+缓存/蒸馏”与“本地推理”的单位请求成本,结合Token价格波动进行敏感性分析。
- 关注框架与驱动的生命周期服务、在线热更新与模型迭代支持,避免“交付即停更”。
采用分层与混合部署
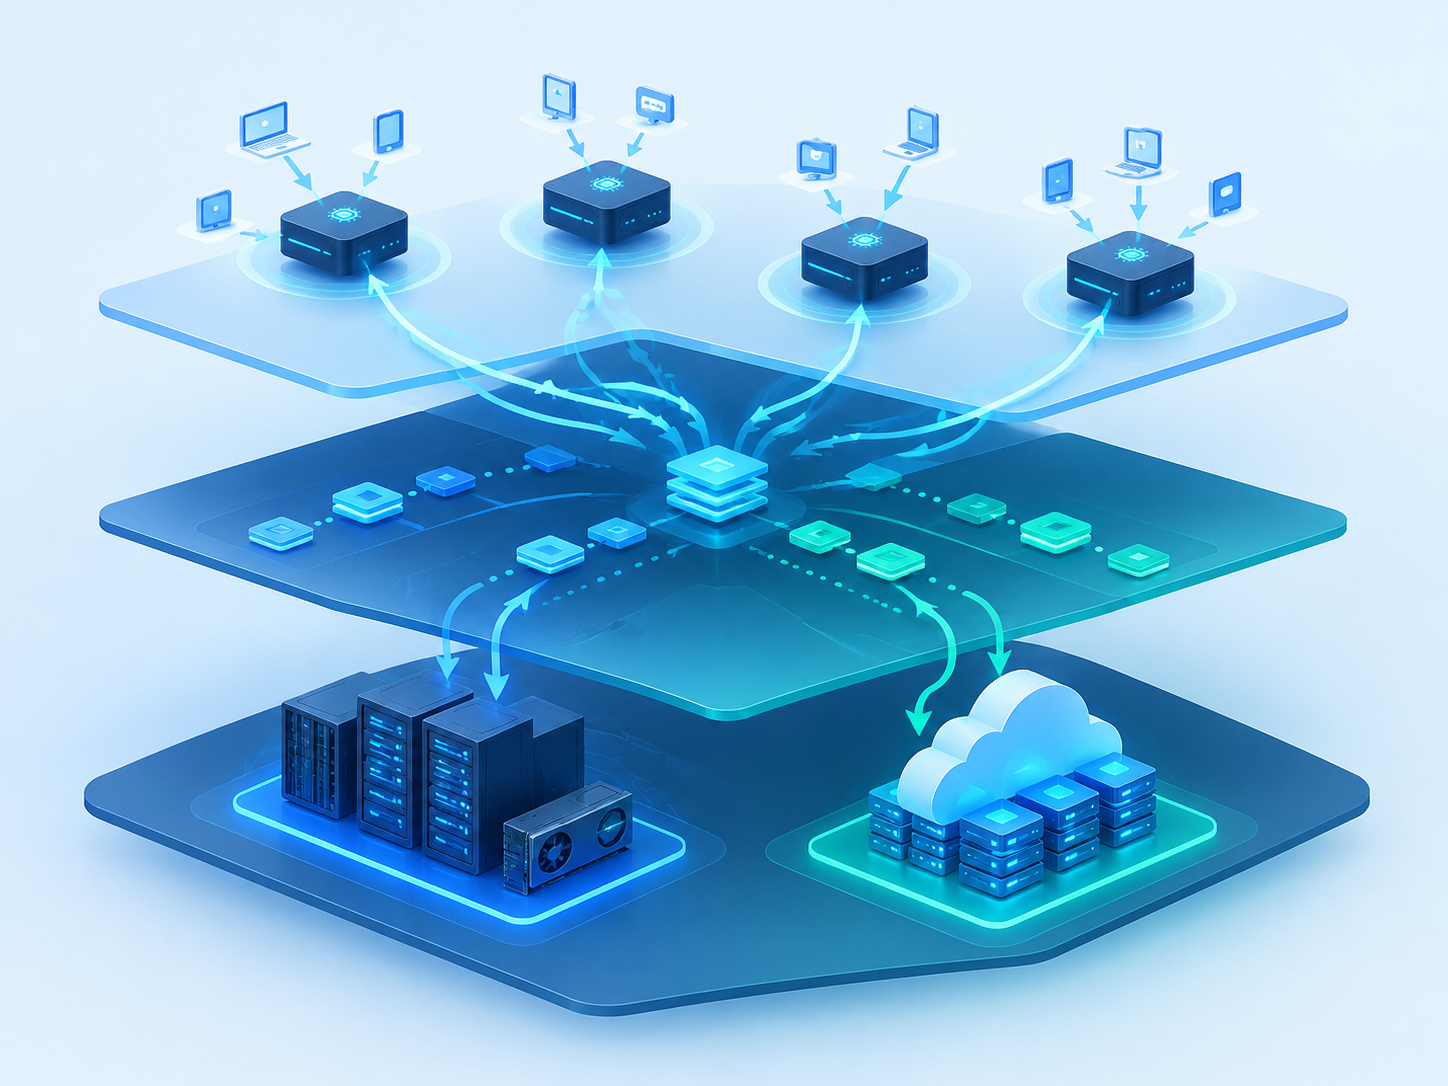
- 将通用问答下沉至AI BOX,复杂任务走高端机或云端专用集群,形成“轻重分层”的算力架构。
- 对国产加速卡,优先选择生态成熟、工具链完善的组合,减少多机并联带来的集成风险。
二手设备的使用边界
- 将其作为开发与测试环境可控使用,避免直接承载核心生产;提前核验保修、功耗与兼容性,预留改造预算。
影响与展望
一体机的“缩水”并非退步,而是产业理性回归:用更小的硬件配比,满足更明确的业务场景;用更成熟的软件栈,把算力转化为稳定的并发与可控的延迟。市场将长期维持“两极态”:
- 轻量设备成为组织级AI能力的“电器化”载体,走向标准化、低运维。
- 满血设备守住高价值、强合规与高复杂度场景,以小批量、深集成为主。
同时,Token与内存价格的波动将继续塑造部署决策,混合与分层架构成为默认选项。随着MoE、蒸馏、检索增强与Agent编排框架的成熟,评价体系也会从“参数与峰值算力”,转向“单位成本的有效产出”“用户体验的稳定性”“迭代速度”。在这套新坐标系里,谁能把“场景-模型-系统”三者协同做到极致,谁就能在新一轮一体机竞争中占据优势。
标签: 大模型一体机 本地部署 MoE Agent TCO
