斜跃智能完成数亿天使+轮,押注家庭机器人
引言
斜跃智能宣布完成数亿元天使+轮融资,线性资本、钧山资本、弘颐资本、隐山资本等参与。资金将用于具身基础模型训练、算力与数据基础设施建设、核心团队扩充,以及家庭机器人本体研发与场景验证。由前理想系核心高管联合创立的斜跃,将“家庭”作为第一落地场景,并提出以 Duplex Reasoning 为核心的新范式,瞄准通用具身智能的长期路线。
核心内容
为什么选择“家庭”作为首场景
家庭是开放且高频的真实物理环境,任务形态复杂多变,天然融合感知、理解、规划、操作与交互,既包含脑力任务(决策、对话、规则理解),也包含体力任务(抓取、搬运、清洁)。与传统工业或仓储的结构化环境不同,家庭需求具有模糊性、连续性和个性化,要求机器人具备可中断、可修正、可接管的行动智能。这既是验证通用具身智能的理想试炼场,也是形成高价值数据闭环的土壤。
Duplex Reasoning:交互与行动一体化的新范式
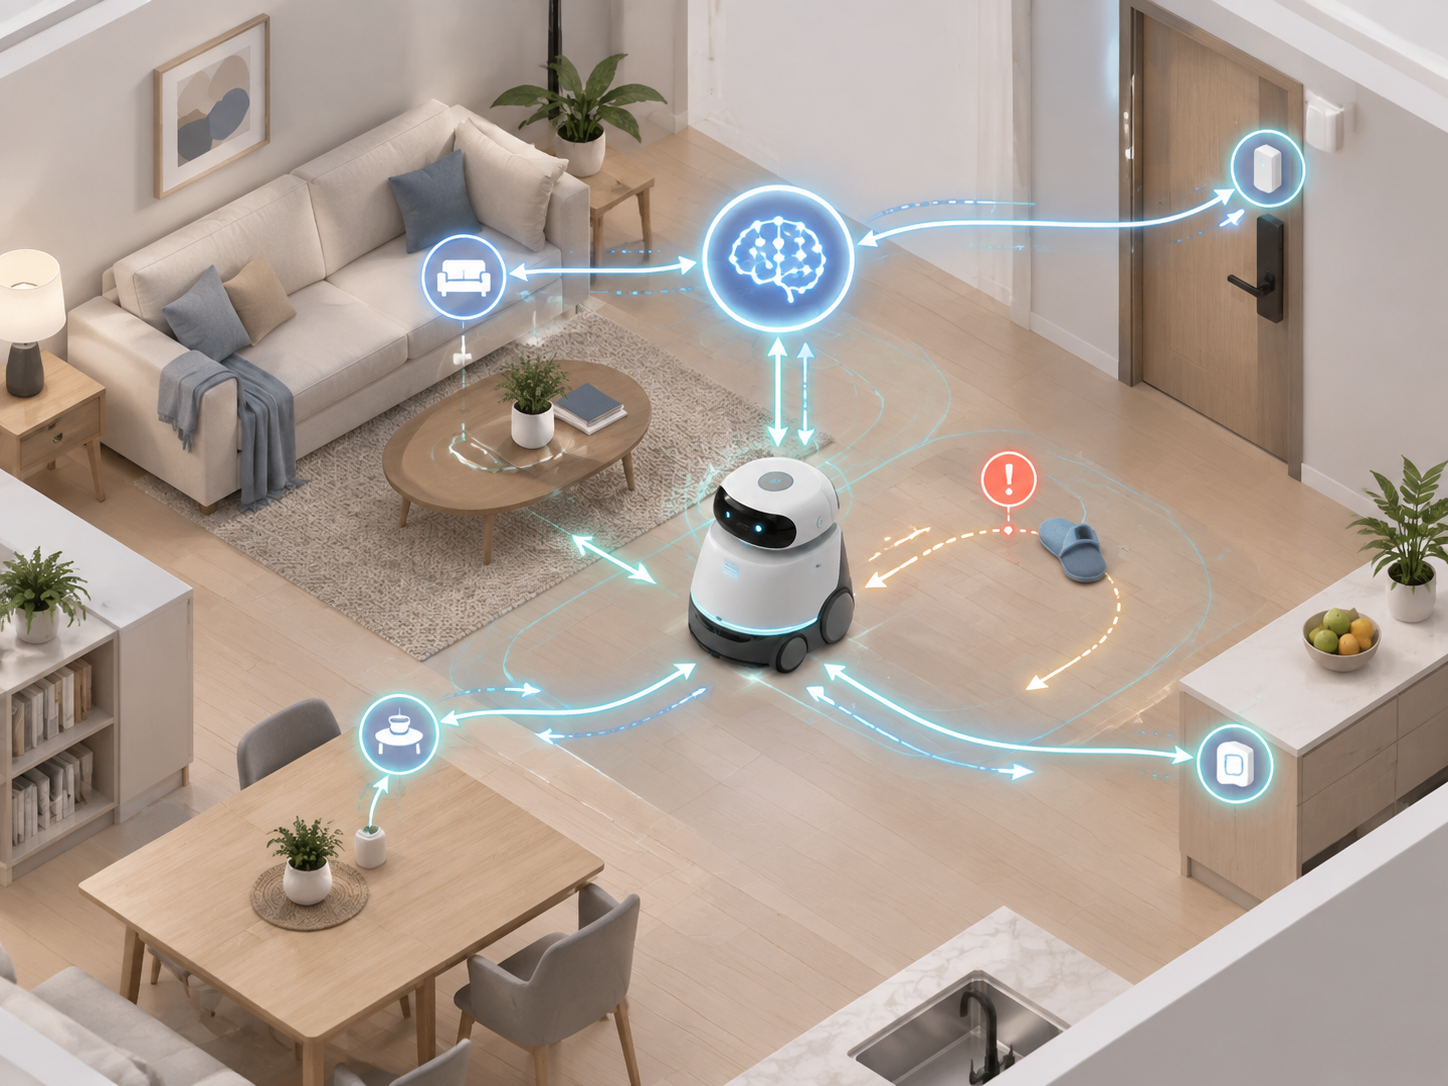
过去的机器人多遵循“接收指令—执行动作—返回结果”的单工或半双工流程,强调执行正确性,却难以应对家庭场景中持续变化与即时纠偏的需求。Duplex Reasoning 的核心是在人机之间保持持续的双向通道,让对话、环境反馈与安全信号在任务执行过程中实时介入,从而动态调整目标与计划。
- 持续可纠偏:行动可被用户随时打断、修正或接管,避免“一条路走到黑”的错误累积。
- 交互与行动同模同训:在数据、模型结构与训练流程层面一体化建模交互与行动,不再把对话和控制割裂。
- VLA + 世界模型协同:以 VLA 为主干,语言把视觉、语音与环境变化压缩为可迁移的高层语义;世界模型预测动作的未来结果,为长程任务提供事前约束。
- 目标函数现实化:以可控算力成本提升开放环境中的理解、决策与行动成功率。
这相当于把“人机协同控制”和“长程规划”前置为模型的训练目标,而非仅依赖推理链或工程规则拼接。关键不在更大的参数,而在可持续的闭环与同构的训练设计。
从模型到系统:Infra 与数据的“硬实力”
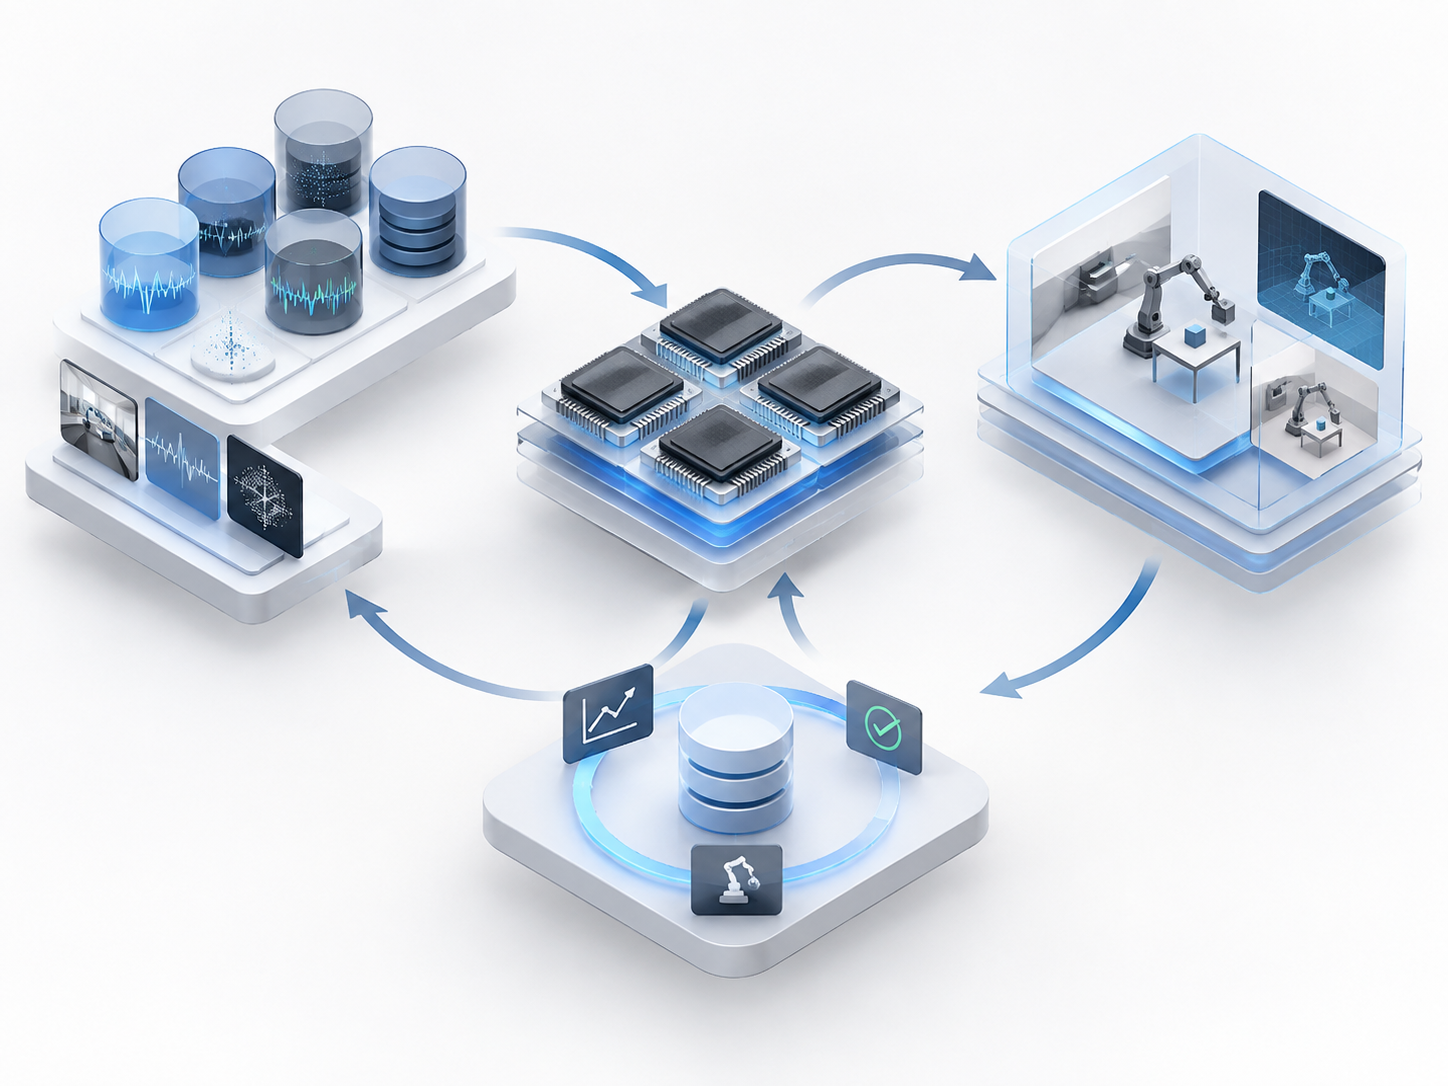
斜跃将能力建设拆解为训练与数据双轮驱动,并强调评估闭环:
- 训练 Infra:围绕预训练、后训练与强化学习构建可复用、可扩展的训练体系,充分释放高质量数据价值。
- 数据 Infra:聚焦信号同步、任务设计与标注质量,优先高代表性与高信息密度数据,而非盲目堆叠时长。
- 评估与仿真闭环:持续、客观地测量模型进步,减少“演示效应”的偏差。
- Ego 数据与分层体系:自研第一视角采集设备与平台,分层整合无本体数据与与本体相关数据,兼顾泛化与落地微调。
与其只追逐参数规模,不如把“数据—算力—评测”打造成可复用流水线,这决定长期爬坡的斜率与边际成本。
路线图:本体策略与场景验证
- 单一本体、全栈闭环:阶段性控制硬件构型与传感器一致性,降低研发变量,再把经验证的能力导入面向 C 端的家庭本体。
- Home-native 形态:在空间通过性、交互方式、安全边界与家庭审美之间求平衡,避免“为了技术而技术”。
- 商业节奏“先验证,再进家”:先在酒店、养老院等半结构化场景验证跨空间泛化、任务完成率与单位经济性,再逐步进入家庭。
- 任务优先级:洗衣、收纳、清洁等高频、长程且标准清晰的任务作为突破口,有助于建立可衡量的产品力与成本模型。
影响与展望
如果 Duplex Reasoning 得以跑通,家庭机器人将从“流程自动机”迈向“可协同的行动智能”,交互体验与任务可靠性同步提升,用户信任与采用曲线有望被加速拉直。真正的挑战在于三件事:稳定的安全边界、对家庭差异的快速适配能力、在可控算力下的长程任务可靠性与可解释性。
值得关注的观察指标包括:
- 半结构化场景中的跨空间泛化曲线与任务成功率
- 可中断/可接管交互的恢复时间与失败后的自愈能力
- 数据密度与算力消耗下的单位经济性变化
- 评估与仿真闭环对真实世界表现的预测一致性
随着资金、团队与基础设施到位,具身智能的“Scaling Law”将从口号走向实证。行业拐点不会来自单一炫技 Demo,而是来自持续通过评测闭环、在真实业务中形成复利的系统性能力累积。对家庭机器人而言,Duplex Reasoning 提供了一条更贴近人、贴近环境、也更可工程化的上行路径。
标签: 具身智能 家庭机器人 基础模型 Duplex Reasoning AI基础设施
