200瓦差距:Arm AGI CPU重塑智能体时代
引言
“智能体开发员”成为新职业,意味着AI正从“会答”走向“会做”。当模型开始以工具调用、检索—行动—反馈的循环方式与世界互动,系统的瓶颈从纯算力转向端到端延迟、数据搬运与功耗约束。数据中心最稀缺的不再是芯片数量,而是每机架的电力与散热预算。以200瓦TDP差距为代表的“能效新战场”,正在重塑算力平台的优先级。Arm在此节点抛出两记组合拳:Arm AGI CPU与Neoverse CSS N4,直指智能体时代的系统级效率。
从“唯算力论”到“系统敏捷”的转向
智能体推理的关键不只是每秒多少TOPS,而是“每一步动作”的往返延迟与尾延迟。频繁的外部调用、细粒度任务编排、小批量推理与上下文拼接,让系统更像一个高并发、强IO的在线服务:
- 延迟敏感:等待外部结果的时间常常决定用户体验,尾延迟优化比峰值算力更重要。
- 数据搬运密集:内存带宽、PCIe链路、网络与存储IO成为一等公民。
- 能效优先:在固定机架功耗下,谁能装下更多可用“工作线程”,谁就更经济。
这正是“200瓦差距”的含义:同等性能下,x86方案常见500W TDP,而Arm AGI CPU约300W。以数据中心视角展开,意味着在相同电力预算内可以部署更多计算核心,降低每请求成本并提升并行服务能力。IDC的最新信号也指向这一趋势:基于Arm架构的机架级服务器已在加速计算场景中占优。
两条路径、一个底座:AGI CPU与统一体验
Arm选择同时做“产品”和“平台”。
- 产品路径(AGI CPU):作为可直接部署的通用CPU,面向云与本地的一致体验诉求。其公布的核心指标包括136个Neoverse V3核心、96条PCIe Gen6通道、12通道DDR5内存,以300W TDP交付与500W方案等效的性能。在企业实践中,云上广泛使用Arm实例,而本地私有云却可能仍是其他架构,导致工具链与运维割裂。AGI CPU试图打通这一断层,让开发—部署—运维在多环境中保持一致,降低迁移与规模化成本。
- 生态路径(不与客户“抢饭碗”):AGI CPU补齐Arm此前未覆盖的本地场景,属于市场空间外延,而非对已有IP授权客户的替代。超大规模云厂商的表态支持,本质是押注能效红利与更广的软件适配,让应用无缝跑在Arm生态之上。
在智能体时代,CPU的角色愈发像“编排中枢”:负责调度、前后处理、内存管理与跨设备协同,把加速器的峰值能力按需释放。
CSS N4:把“数据搬运”变成第一性优化
2026年,仅仅增加核心数已不再新鲜。Neoverse CSS N4的亮点不止“8—128核、最高3.8GHz”的宽配置,更在于系统级的数据通路升级:
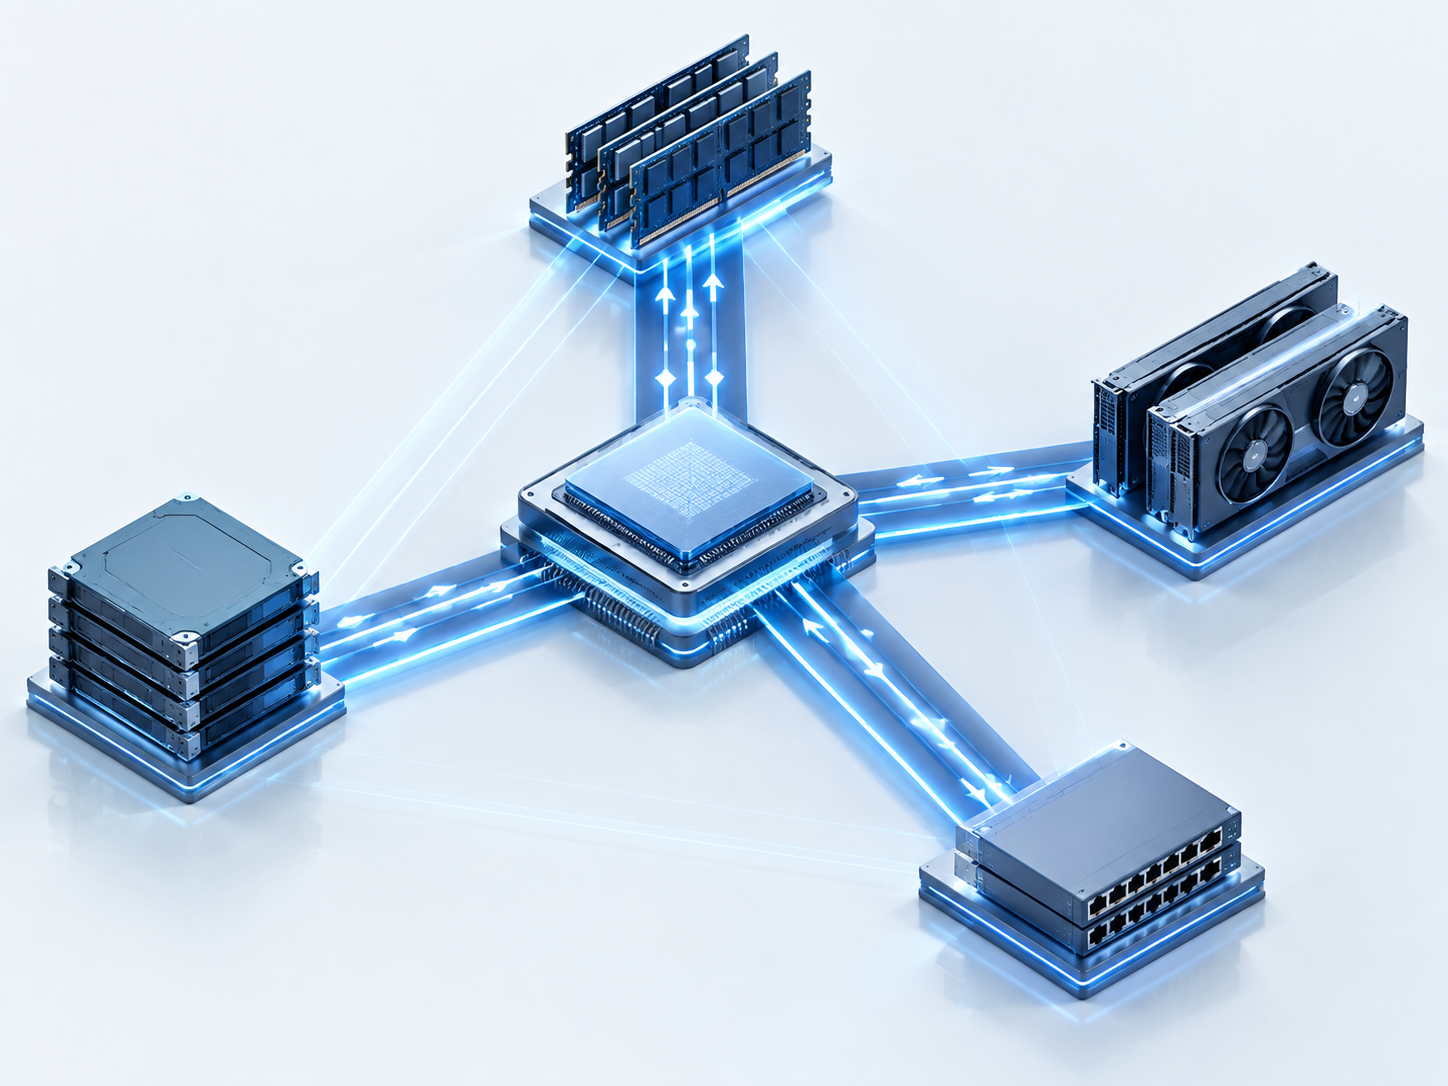
- 内存代际跃迁:引入LPDDR6,相比主流DDR5具备更低功耗、更小面积占用与更高能效带宽,契合大规模并发下的内存访问模式。
- 外设带宽前移:支持PCIe Gen7,把“芯片到外设”的数据高速公路再拓宽一代,有利于与GPU、NPU、存储与高速网络的协同。
- 可配置CSS平台:从IP到“参考系统”的跃迁,加速整机与SoC设计,缩短面向特定场景(例如高并发推理、检索增强、工具编排)的落地周期。
核心洞察在于:智能体的性能上限,更多由数据流动效率而非单点峰值决定。Arm试图用“内存—IO—核心”的组合拳,系统性削弱数据搬运瓶颈。
影响与展望
- 能效成为决定性指标:电力与空间是硬约束,200W级TDP差异按机架/机房规模放大,直接影响TCO、碳排与扩容速度。
- 生态一致性降低摩擦:云—本地统一的平台体验,使企业能以更低成本把智能体从试验田推向生产系统,维护与监控栈也更易标准化。
- 架构演进方向明确:异构协同将成为常态,CPU从“算力主角”转为“调度与数据中枢”;高带宽IO、低延迟内存与细粒度电源管理,成为下一阶段的护城河。
- 关键观察点:
- LPDDR6在服务器侧的容量密度与稳定性表现
- PCIe Gen7的产业链成熟度与整机协同优化
- 300W热设计在高密度机架内的工程化落地与维护成本
- 软件栈对智能体工作负载(工具调用、RAG、函数执行)的端到端优化
不止一颗CPU,真正的竞争是“系统工程力”。Arm把平台的重心从单核性能转向数据路径与能效的整体最优,这与智能体经济的需求高度同频。接下来胜负手,将来自生态执行速度与整机层面的持续优化。
标签: Arm AGI CPU 智能体 数据中心 算力架构
