FAME框架:破解持续强化学习遗忘
引言
在现实世界中,智能体必须在不断变化的任务与环境中持续学习:今天学会拧瓶盖,明天要学抓杯子,后天可能面对全新工具与材质。传统强化学习的假设是“环境不变”,而真实世界则恰恰相反。由此导致的“学新忘旧”(灾难性遗忘)是持续学习中的核心难题,也是具身智能与 LLM-Agent 在落地时绕不过的坎。
阿尔伯塔大学强化学习团队提出了一个值得关注的解法:FAME(Principled Fast and Meta Knowledge Learners)框架。其思路不再止于经验性修补,而是将“任务差异”和“遗忘量化”纳入一个可优化的原则性公式,并通过“快学系统 + 元学习系统”的双轨协同来平衡可塑性与稳定性。这为持续强化学习提供了一把可操作的“总钥匙”。
核心内容
从经验修补到原则化框架
过去的持续强化学习研究,多采用经验回放、参数正则化、网络扩展、策略蒸馏等手段缓解遗忘。这些方法在局部有效,但缺少统一的理论刻度与优化目标:何时该迁移、迁移多少、如何在保持旧能力的同时学习新能力,往往凭经验调参。
FAME的价值在于,将持续强化学习的核心矛盾——“可塑性(快速适应)”与“稳定性(不遗忘)”——写入一个明确的优化范式。这样,工程上常见的“试错调参”便有了上位原则的约束:不再是补丁式改良,而是围绕可度量的目标有序迭代。
简言之,FAME将“持续学习”转化为“持续优化”:以理论可度量的差异与遗忘作为目标函数,指导算法该记住什么、该忘掉什么、该如何融合。
两个关键指标:任务差异与遗忘量化
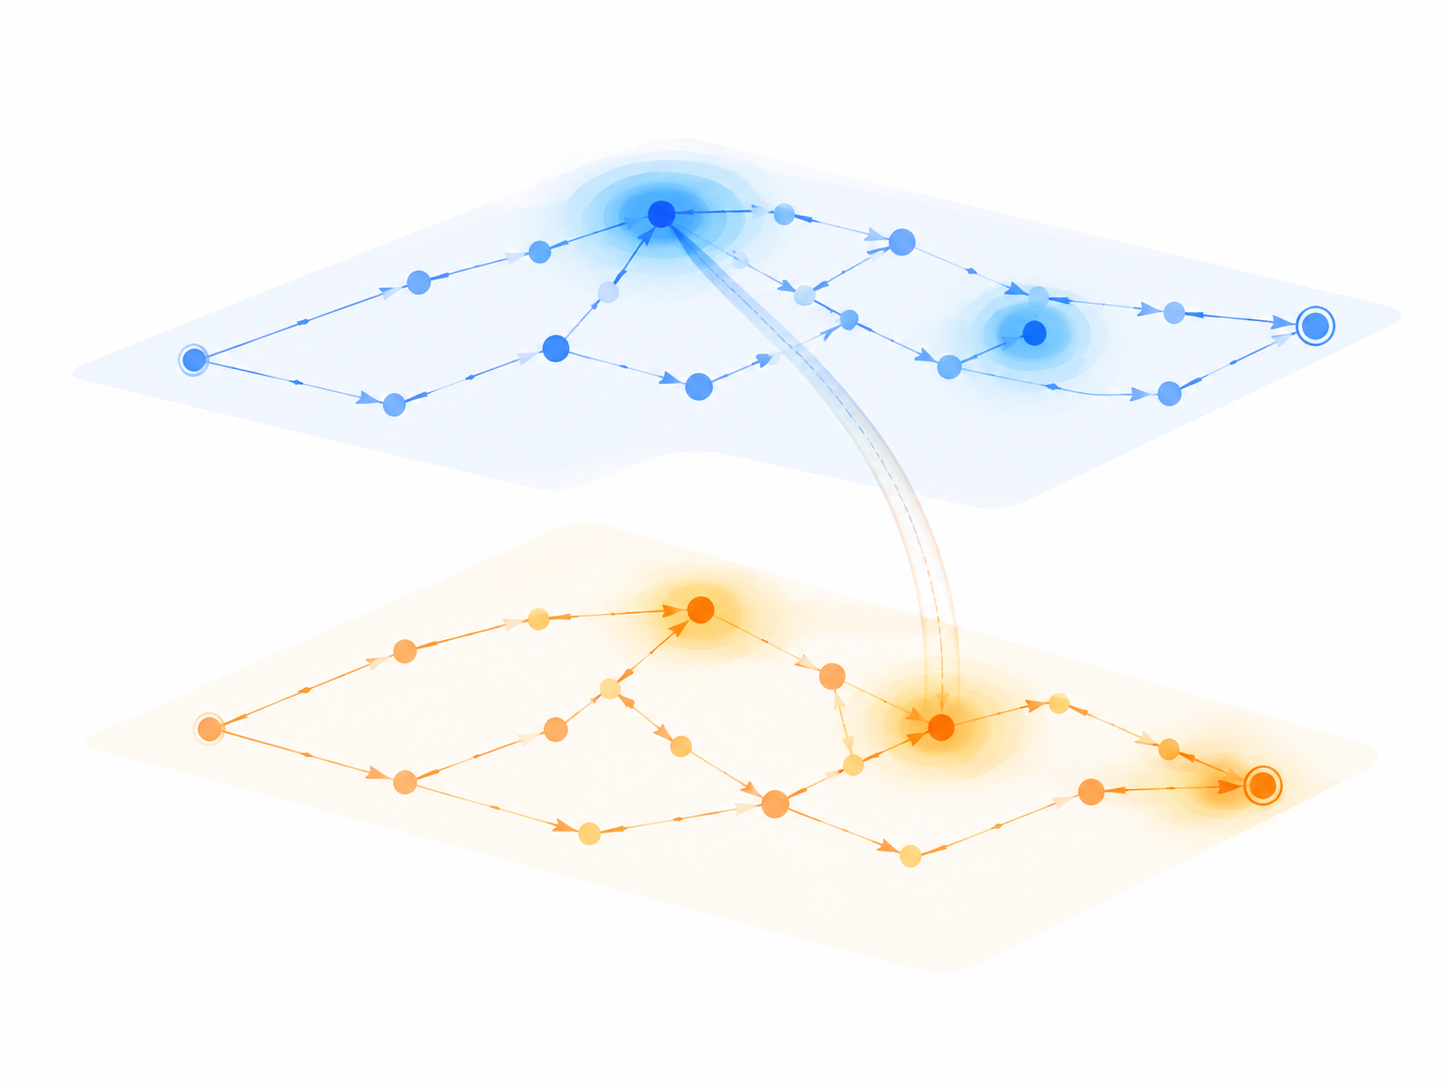
原则性框架必须有“刻度”。FAME提出两项基础度量,使得“任务如何不同”和“究竟忘了多少”可以被计算。
-
任务差异:以马尔可夫决策过程为基,直接度量两个环境的最优值函数或最优策略之间的距离。该定义天然囊括了奖励函数与状态转移的差异,避免仅看奖励或仅看动态带来的偏差。好处在于,迁移策略不再只看表面相似(比如奖励形状),而是对“最优行为”的差异进行衡量,从而更贴近决策本质。
-
遗忘量化:强化学习中数据分布由策略决定,简单比较网络参数变化并不可靠。FAME建议用策略或值函数在历史任务下的表现来衡量遗忘,并使用过往任务的状态访问分布进行加权。直观含义是:是否遗忘,应聚焦于过去“真正重要、频繁访问”的状态-动作,而非对全状态空间一视同仁。这让遗忘度量与任务实际需求对齐,避免过度保留无关知识。
有了差异与遗忘的度量,知识整合便可写成“在保持遗忘最小化的同时提升新任务表现”的优化问题,为下游算法提供统一目标。
FAME双系统:快学与元学的分工协同
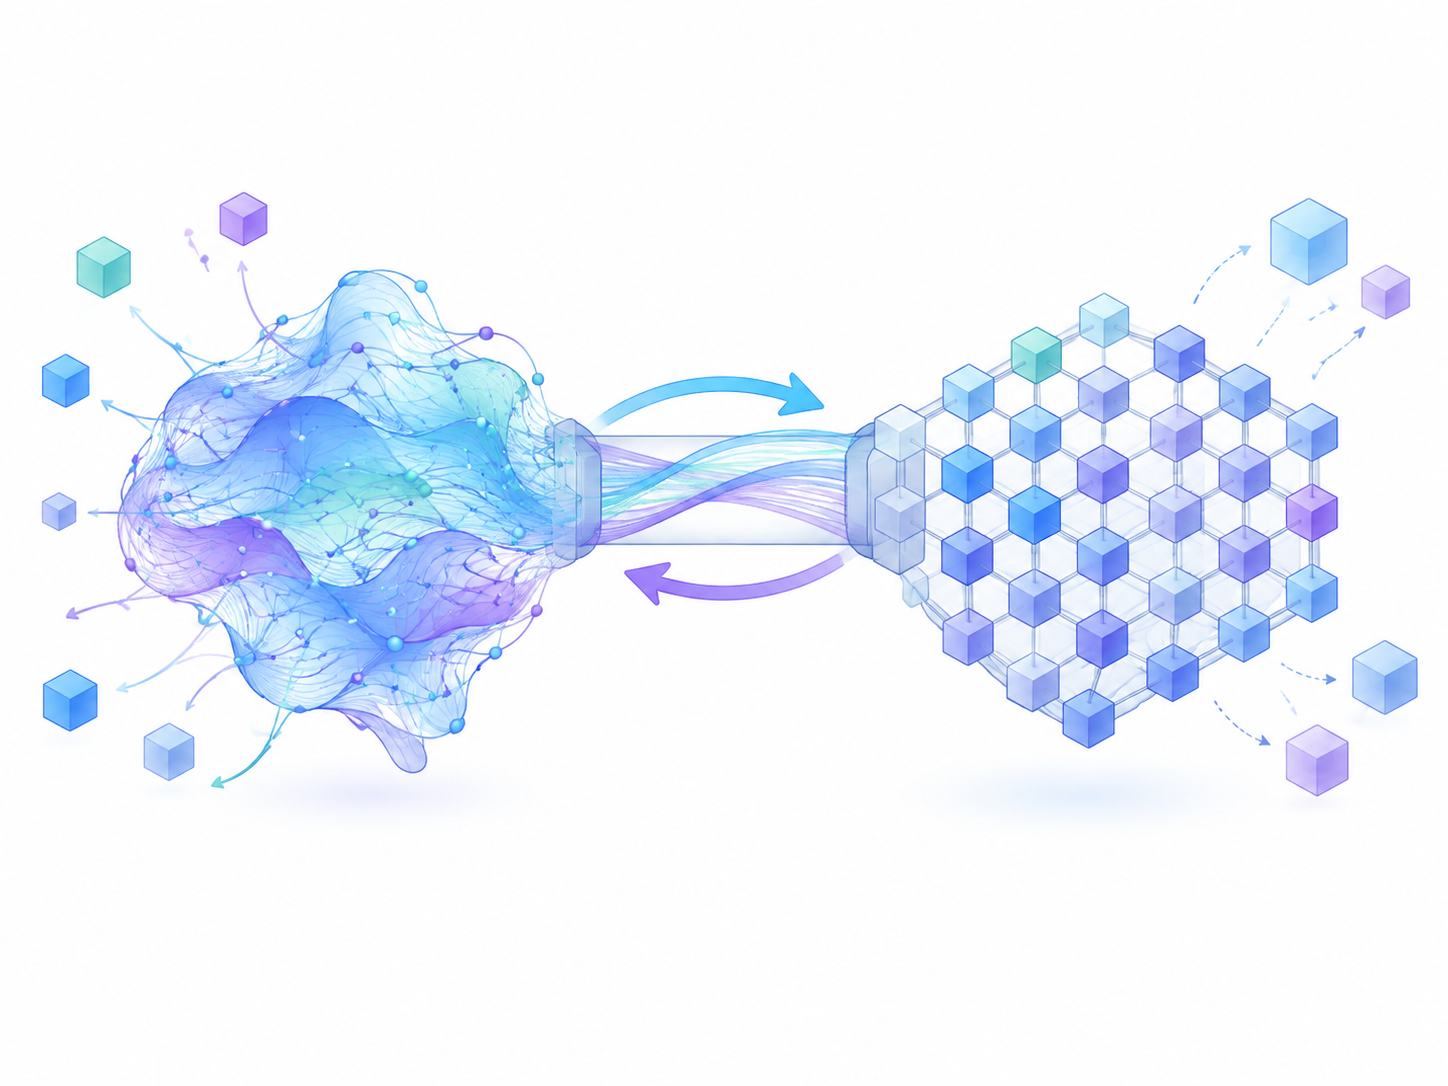
FAME的设计受人类记忆系统启发:海马体负责快速记忆,大脑皮层负责长期整合。对应到算法层面:
- 快学系统(Fast Learner)
- 目标:在检测到新任务或分布漂移时迅速适应,通过参数高可塑性、轻量适配层、上下文条件化策略等方式,尽快达到可用性能。
-
手段:借助过往知识进行温启动(warm start),在任务差异较小时,复用更多旧策略组件;差异较大时,降低复用比例,避免“旧知识干扰新学习”。
-
元学习系统(Meta Learner)
- 目标:将新学到的知识与既有能力整合为稳定的长期表征,最小化对历史任务的遗忘。
- 手段:围绕“遗忘最小化”的目标函数进行更新,使用加权回放或策略约束,对历史关键状态-动作赋更高权重;当差异较大时,适度扩展表示能力或引入模块化结构,避免一锅烩。
为什么需要两个系统而非一个“大而全”的模型?统计学视角下,快速适应要求高可塑性(偏向低偏高方差),而长期稳健则偏向低方差低漂移。将二者硬塞进一个优化目标,往往在复杂任务序列中顾此失彼。通过功能分离再协同优化,FAME在偏差-方差与稳定-可塑之间给出了更清晰的折中路径。
工程落地的几个要点
- 任务切换与差异评估:利用策略行为变化、回报分布漂移或环境指标变化检测“新任务”,并以最优策略/值函数距离作为迁移强度的调节器。
- 记忆的“重权样本”选择:按照历史状态访问分布选取关键经验,聚焦高价值轨迹,减少无关回放带来的资源浪费。
- 模块化与扩容策略:当差异超过阈值时,采用可插拔的子策略或表示模块,避免“全局参数”一次性覆盖,降低干扰。
- 统一目标驱动训练:以“新任务性能 + 遗忘最小化”作为联合损失,兼顾短期适应与长期稳定。
影响与展望
FAME的提出,对三个方向具有直接意义:
- 具身智能:现实环境强非平稳,任务队列长且多变。FAME的差异度量与双系统协同,为“边干边学”的机器人提供了可扩展路径,避免频繁回炉重训,降低运维成本。
- LLM-Agent:即便具备长上下文能力,若无法将经验固化进模型本体,仍容易“会时会、不会时不会”。通过元学习层面的整合与遗忘最小化约束,智能体可在部署中积累稳定技能库。
- 算法研究:将持续学习从“技巧堆叠”拉回“原则优化”。在此之上,可进一步探索部分可观测环境、长时延信用分配、安全约束(如风险敏感目标)与计算预算受限场景下的变体。
仍有挑战有待攻克:如何在大规模、长时序、多模态任务中高效估计最优策略/值函数距离;如何在极端分布漂移下稳定地选择模块化扩容;如何构建社区认可的评测基准,衡量“学得快且记得牢”的综合能力。这些开放问题,将决定FAME在更广泛场景中的上限。
从经验主义走向原则主义,是持续强化学习迈向可靠工程化的关键一步。FAME提供了一个清晰起点:让智能体既能在变化中迅速成长,又不轻易遗忘曾经掌握的本领。
标签: 强化学习 持续学习 灾难性遗忘 元学习 具身智能
