天玑9600Pro:2nm AI原生重构旗舰SoC
引言
移动端正在从“把AI搬上手机”,迈向“为AI重构手机”。新近发布的天玑9600 Pro,将旗舰SoC的焦点从单核性能推到了系统级协同:以2nm制程为底座,首创AI原生架构,把CPU、GPU、NPU、ISP等异构单元通过软硬融合打通,指向一个关键命题——在生成式AI与消费者智能体崛起的时代,旗舰芯片的竞争不再是某个核心的极限,而是整颗SoC的融合效率。
核心内容
2nm与Pro级基础:性能与能效的“底座升级”
台积电2nm带来的不仅是晶体管密度提升(集成超过330亿),更是设计-工艺协同优化后的能效上限。天玑9600 Pro在此基础上采用2+3+3全大核CPU架构:2颗C2-Ultra超大核至4.55GHz,3颗C2-Pro大核至4.35GHz,另3颗大核至3.1GHz,辅以34.5MB多级缓存、LPDDR6与UFS 5.0。结果是短跑与长跑兼顾:单核提升约17%,多核提升约15%,而超大核与多核功耗分别下降约37%与61%,为持续高负载和复杂AI场景留出充足的热与能耗空间。
这类“底座升级”的价值在于:当模型规模、并发任务、渲染与感知叠加时,内存带宽与缓存命中率决定了延迟与续航的上限。换言之,Pro不仅是频率更高,更是让性能可持续、可调度。
AI原生架构与融合计算:从“堆算力”到“用好算力”
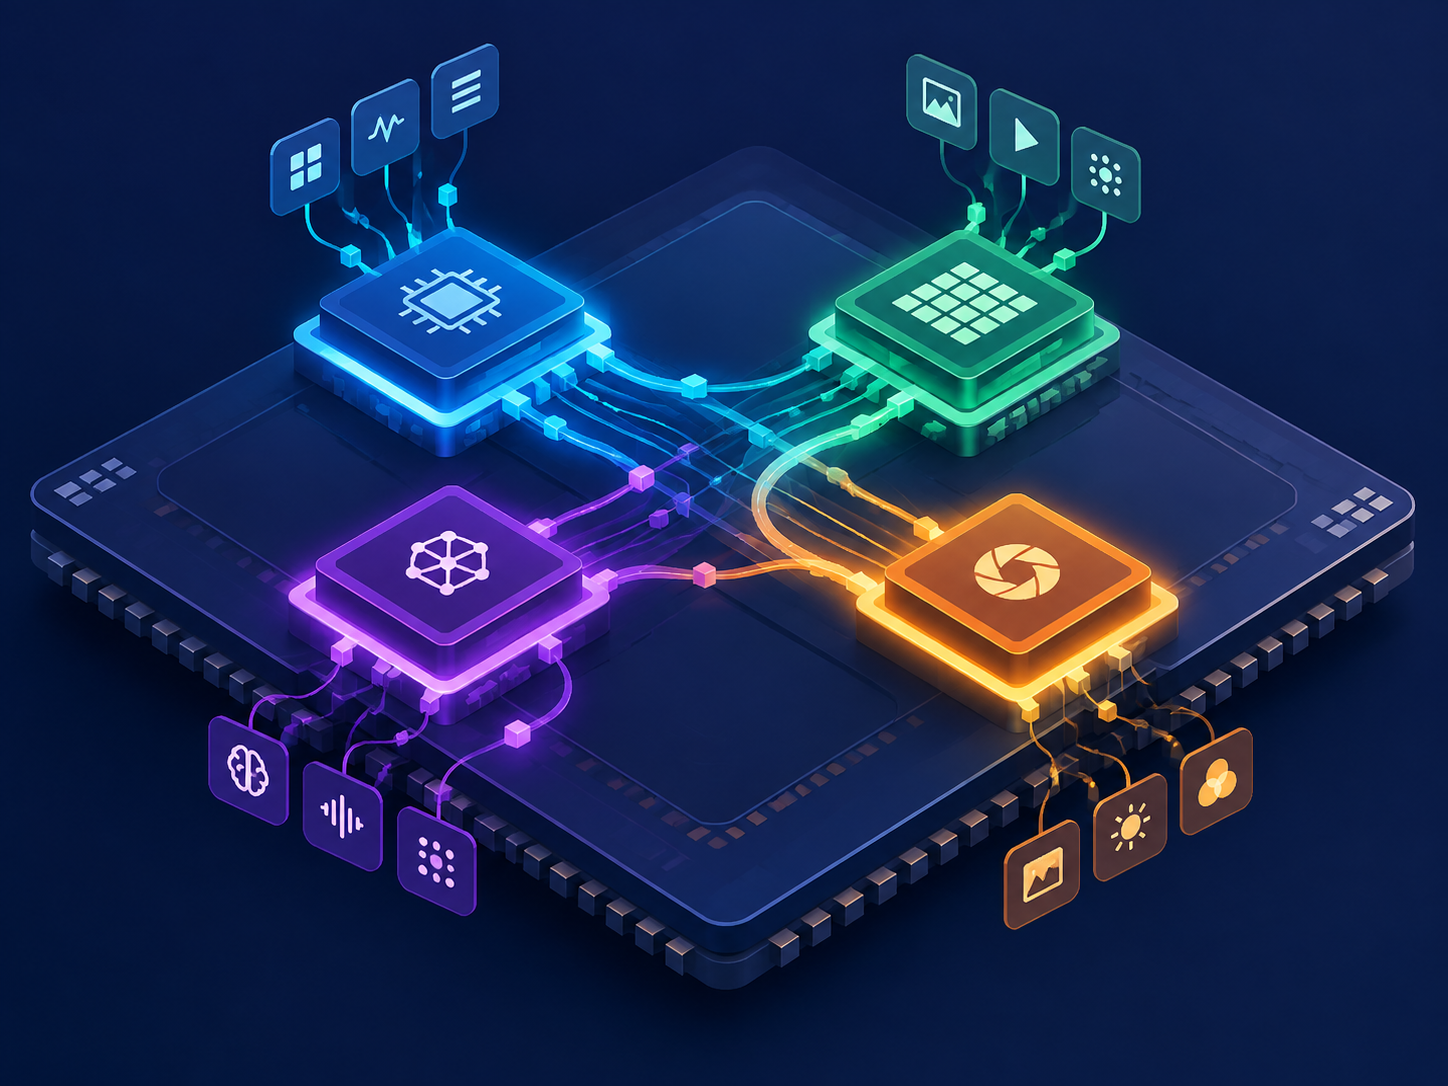
AI原生的要点在于:让AI成为系统资源调度的第一类公民。天玑智算融合架构通过软硬协同,把CPU/GPU/NPU/ISP按任务图谱动态编排,尽量让最合适的单元承接最合适的工作,减少搬运与上下文切换的成本。对终端AI典型负载——多模态理解、神经网络渲染、智能影像——这种编排带来的收益往往超过单独提升某一核心。
例如,神经网络渲染可由NPU进行特征推理、GPU负责光栅/光线阶段,CPU承担场景管理与调度;智能影像则让ISP与NPU在低延迟路径上协同完成降噪、语义分割与风格化。架构层面的“融合”把曾经绕不开的带宽与延迟瓶颈转化为可控的调度问题,旗舰评判标准也随之升级为“全栈协同效率”。
双NPU重构:AI从被动响应到主动智能
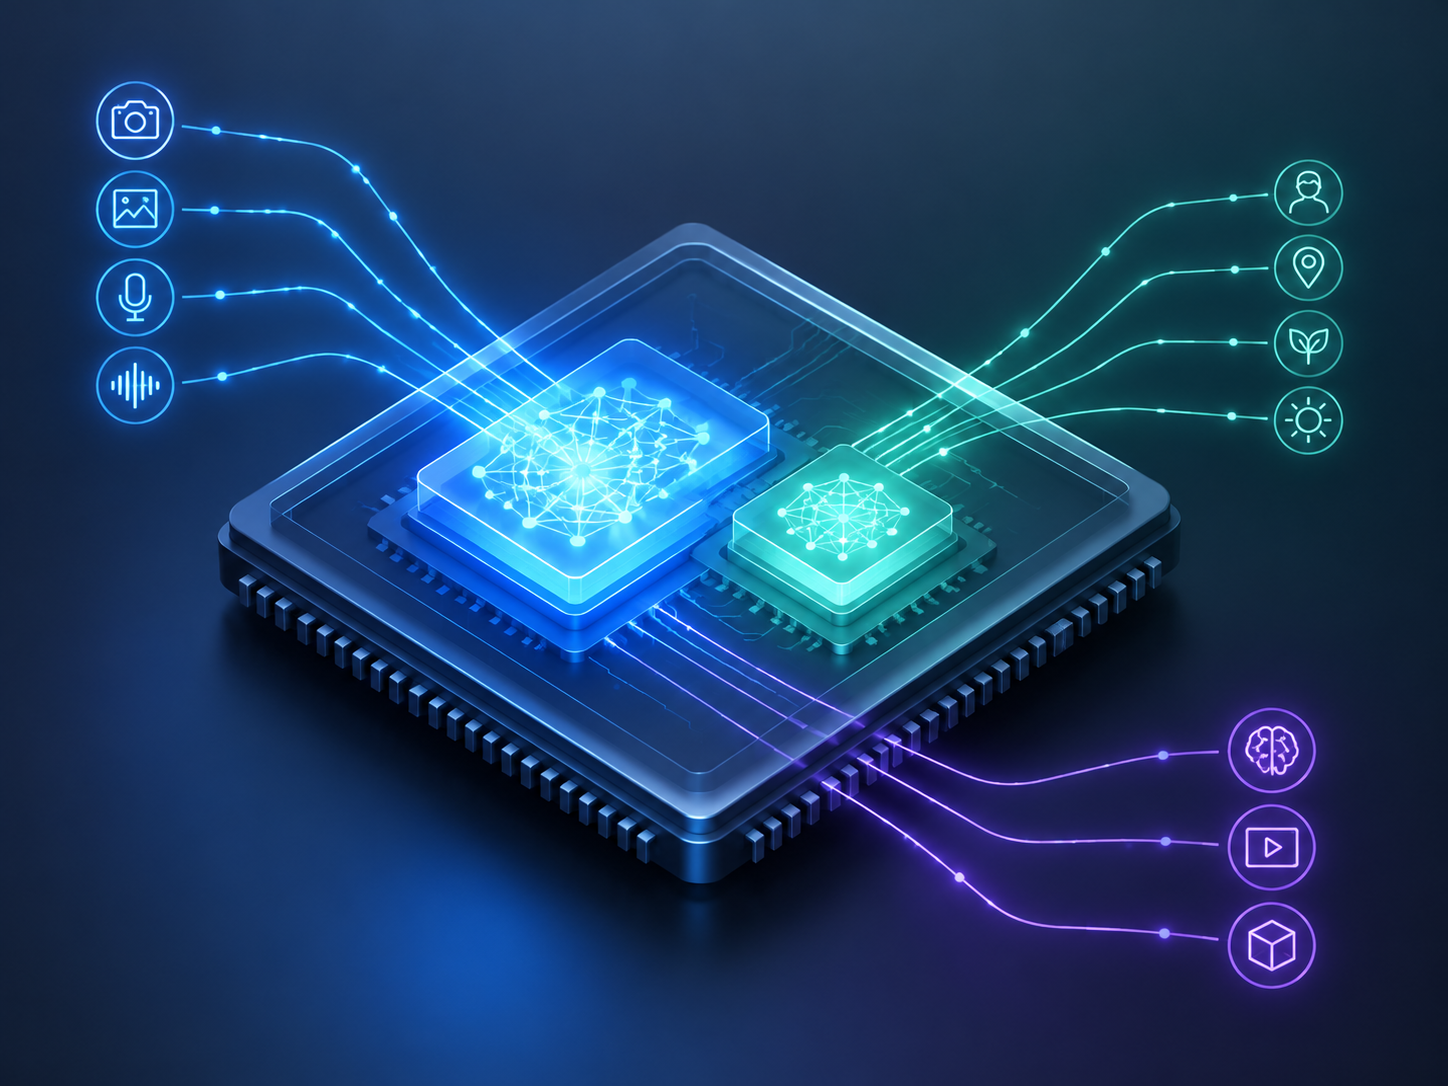
双NPU的设计,对终端AI形态是一次直击需求的重构。一方面,超性能NPU 1090提升端侧推理效率,每瓦生成词元数提升约55%,适配大模型与多模态任务;另一方面,第二代超能效NPU面向全时运行优化,功耗下降约40%,支持持续感知声音、动作与环境,实现低成本“常在线”。
这意味着AI不再等待指令,而是在合适的时机主动理解上下文并提供服务。例如与终端厂商合作的相机助手,通过超能效NPU长期守候取景画面,识别场景并给出拍摄建议,把复杂摄影“前置”为自然的实时辅助。更重要的是,这类主动智能在端侧完成,兼顾隐私与低延迟。
调度与内存:让AI真正落地的关键细节
真实使用中,多个App并行、AI模型随时唤醒、前后台频繁切换,瓶颈往往出在调度与内存。天玑智算融合架构在AI算力智能调度与内存管理上做了系统级优化:对3B级别语言模型,出词速度最高可提升约40%;通过并发运行、内存压缩与动态调度,模型启动加速约27%,并发保活可达25个应用。在用户感知层面,这意味着AI常驻不再“拖慢一切”,而是与日常切换、游戏、影像共存。
这类优化的意义在于:当AI成为系统常态负载,内存占用、带宽分配与功耗预算必须被精细化管理。没有这些“看不见的工程”,大核与大模型的纸面优势难以转化为体验。
影响与展望
天玑9600 Pro释放的信号清晰:旗舰SoC进入“融合计算”主导的新拐点。面向消费者智能体,端侧AI需要三件事同时成立:可持续的能效、可编排的异构算力、可常驻的系统资源。AI原生架构正是将三者合一的路径。
面向产业,这一趋势意味着:
- 开发生态需要更统一的AI运行时与图编译工具链,跨CPU/GPU/NPU的任务划分应更透明、可控。
- 系统层要更深度参与,从内存压力预估到模型热启策略,OS与芯片的协同成为差异化关键。
- 能效与热设计仍是天花板,如何在长时任务、复杂交互与高帧游戏中平衡体验,将决定“AI常在线”的实际落地速度。
面向用户,主动式智能将从单点功能走向系统能力:相机、语音、输入法、助手、游戏渲染都可能被AI重写。端侧与云侧的分工也将更清晰——隐私敏感、低延迟任务在本地完成,重训练与大规模检索交给云端。谁能把融合计算的工程价值转化为稳定、顺滑、低耗的体验,谁就能定义下一代旗舰的标准。
最后需要强调,AI原生不仅是一次硬件跃迁,更是计算范式的迁移。随着2nm工艺、双NPU与系统级调度共同成熟,旗舰SoC的竞争将从“参数对比”转向“协同能力”,而这一变化,正是移动AI进入新阶段的标志。
标签: 天玑9600Pro 移动SoC 融合计算 生成式AI 2nm
