三维几何让生成式模型跨视角自洽
引言
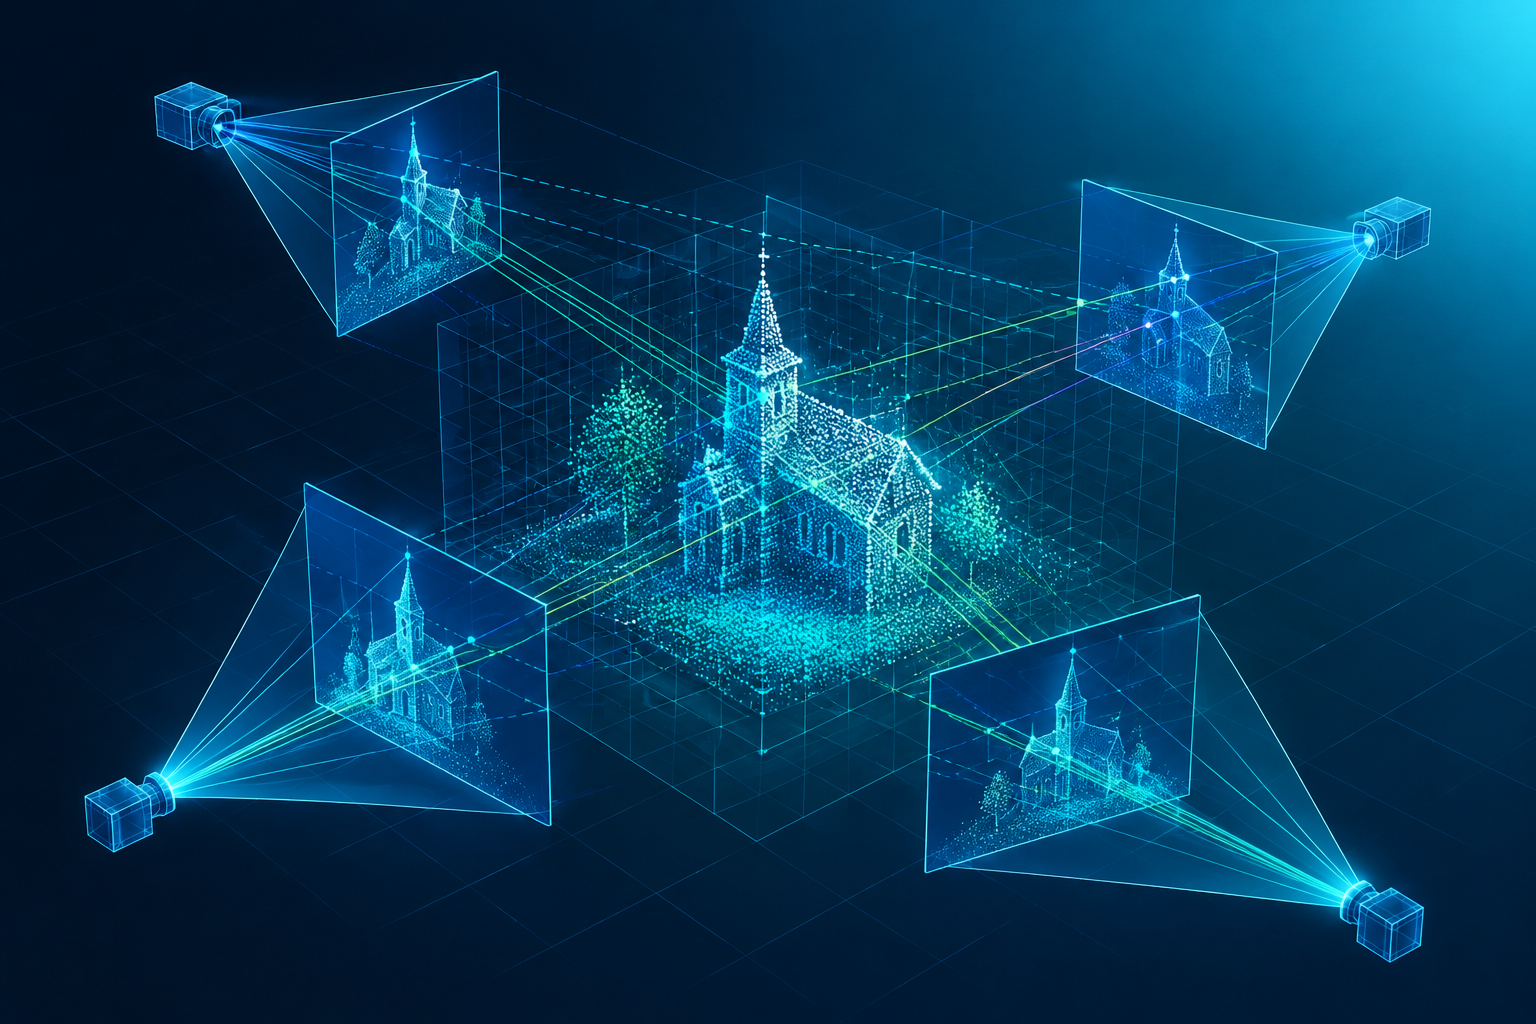
生成式模型在大规模二维数据上练就了强大的“局部先验”:一帧图像的纹理、光影、语义都能以惊人的逼真度还原。然而,一旦涉及跨视角、长距离漫游与三维一致性,问题立刻暴露:多视角下结构对不上、物体数量忽多忽少、建筑随镜头位移逐渐“扭曲”。这不是美学品味之争,而是缺少显式三维约束的系统性偏差。几何正在“反攻”——通过把学习得到的局部预测组织成受三维结构管束的整体,从而把“好看的一帧”升级为“自洽的世界”。
在近期的欧洲计算机视觉会议上,香港科技大学谭平教授团队强调:学习方法提供丰富的局部表达力,三维几何负责跨视角的全局一致性与可扩展性。两者并非二选一,而是互补协同。
局部先验的边界:每帧自洽不等于世界自洽
- 训练数据多为短时、局部视野,模型更善于“片段拟合”而非“全局约束”。
- 没有显式相机位姿与场景拓扑的约束,物体计数、尺度与布局容易漂移。
- 扩散与大模型可生成细腻外观,但缺少可微的、可验证的三维结构一致性目标,导致“看似合理、跨视角崩溃”。
根因在于:局部先验只回答“这一帧应当像什么”,三维几何必须回答“所有视角共同对应哪一个世界”。
重建视角:神经表示 + 关键帧 + 全局优化
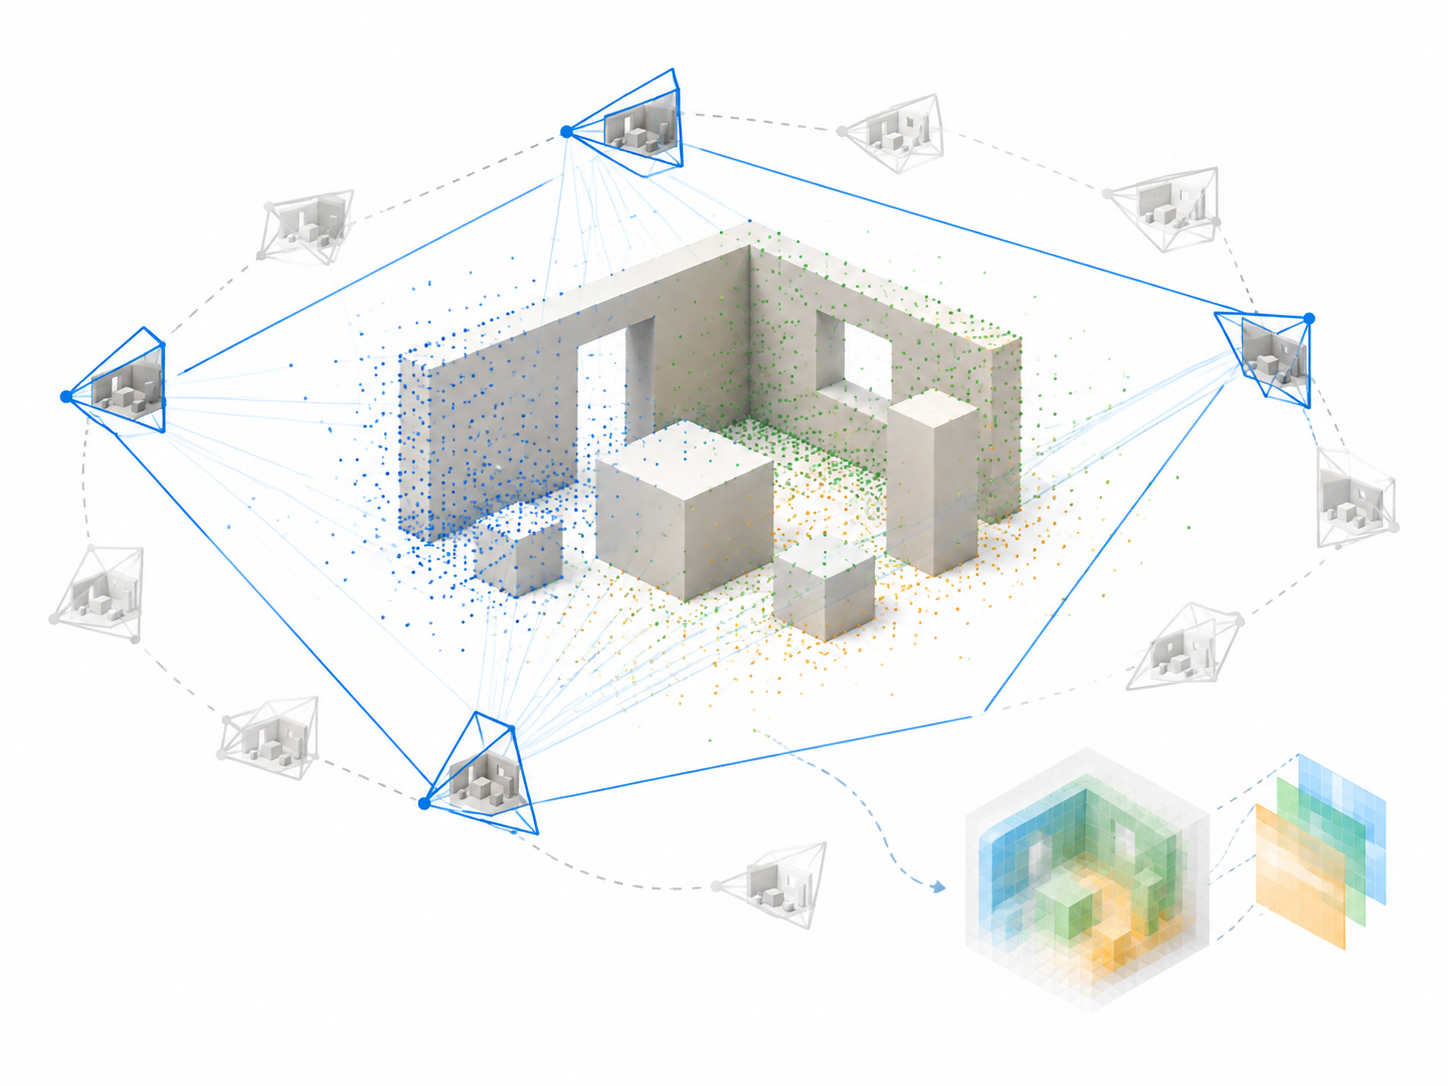
以大型 Transformer 前馈的SfM风格方法为例(如近年兴起的端到端位姿与深度预测),单次处理上百张图像就会遭遇显存与计算瓶颈,且全局一致性依赖网络隐式学习,难以保证。
几何的“反攻”做法是把传统SLAM/SfM的思想现代化:
- 关键帧建图:仅在少量关键帧上构建紧凑的“神经场景表示”(如特征体素、三平面、GS等),既保留结构要点,又降低内存消耗。
- 非关键帧定位:其余帧只做轻量位姿估计,避免全量参与全局优化。
- 全局一致性:引入位姿图与集束调整(Bundle Adjustment),把相机与稀疏/稠密结构放入同一优化图中,抑制漂移。
- 可扩展性:神经地图作为中间层,支持分块、分层更新与回环校正,规模从房间扩展到街区。
优势在于以几何优化兜底一致性,以神经表示兜住表达力与效率;代价是需要更复杂的系统工程与不间断的不确定性管理。
生成视角:结构先行,细节随后
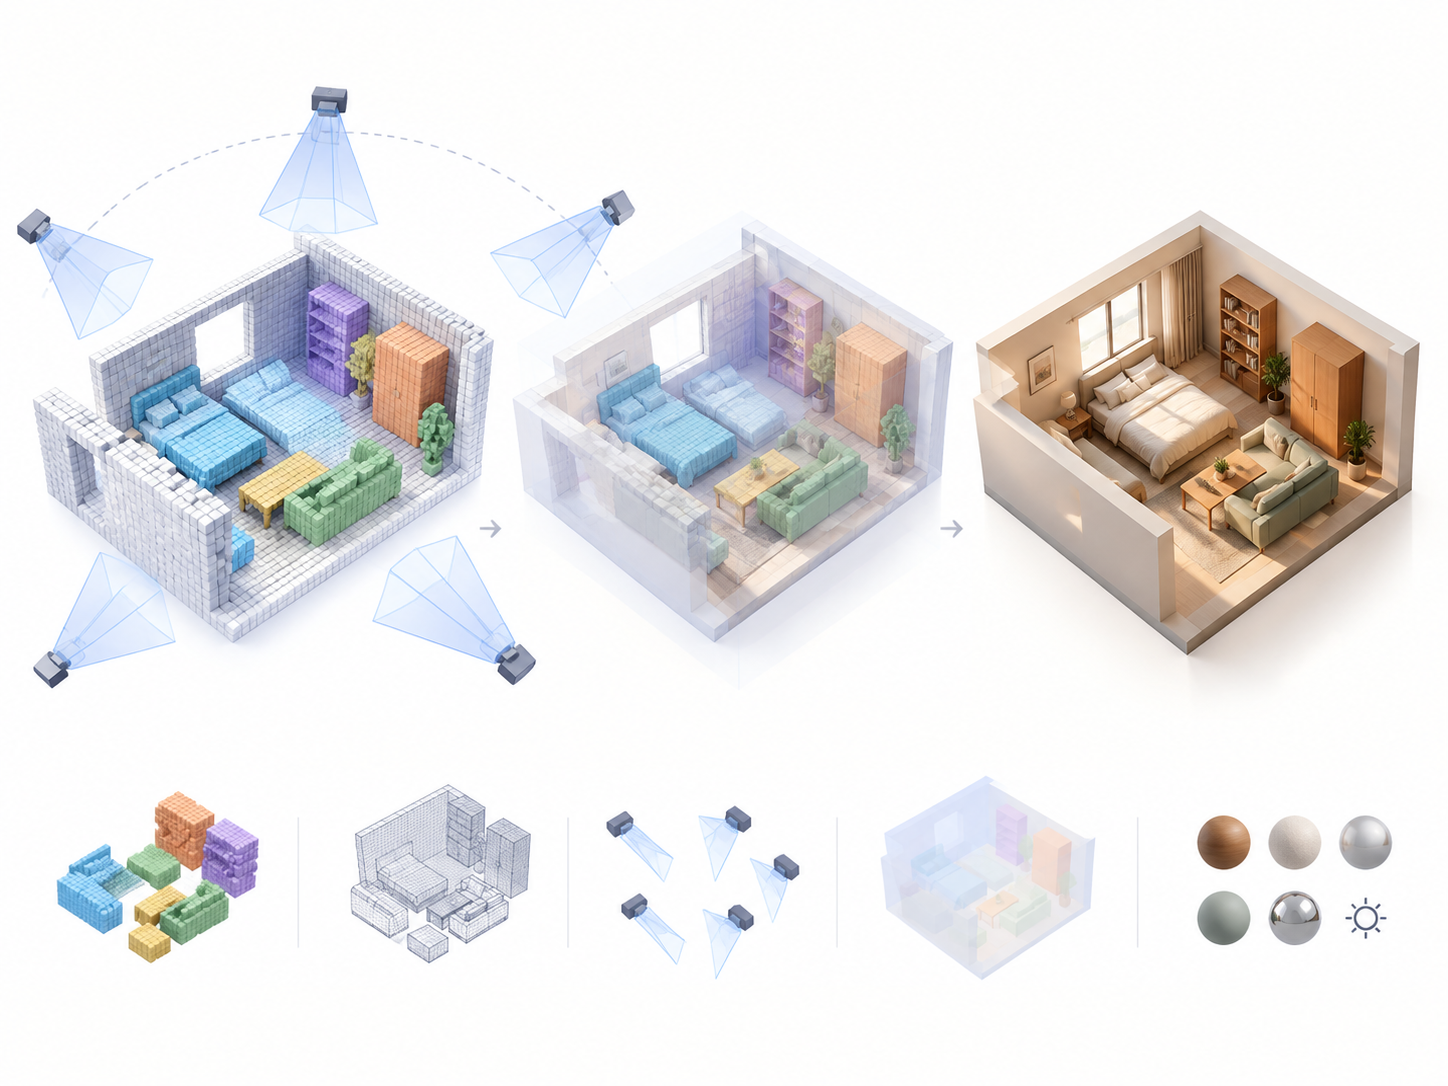
在三维场景生成中,单纯用扩散从随机噪声“长出一个世界”容易失控。更稳健的范式是“先搭骨架,再贴皮肤”:
- 结构约束:先给出可编辑的三维代理,如室内布局、语义体素、粗网格/隐式场或高斯点。它规定了相机可漫游的可行空间与物体关系。
- 可微一致性:把代理渲染到多视角,作为扩散或译码器的约束,要求不同视角的像素归因于同一三维原因,显著减少“多床”“错位”的现象。
- 外观补全:生成模型在结构之上合成材质、细节与照明,保留美学灵活性。
- 约束注入:结合曼哈顿世界、尺寸先验、拓扑连续性等,可在长距离漫游中保持稳定。
这类“结构先行”的路线,把自由度最高、最易走偏的部分先几何化;再把高维细节交给学习模型,兼顾控制力与多样性。
统一框架:从重建到生成的“世界模型”
重建与生成其实在同一条轴线上:前者从观测中反演世界,后者从文本/草图中生成世界。统一视角下的关键是“学习先验 × 几何约束”的分工协作:
- 学习侧:提供局部可信的深度、法线、语义、材质与光照先验。
- 几何侧:通过位姿图、体素/网格/隐式场与可微渲染,把局部预测拼成全局可验证的世界。
- 优化层:以不确定性为权重做跨视角一致性校正,让网络“说了算”的地方与几何“说了算”的地方各就其位。
影响与展望
- 应用落地:机器人导航、AR/VR、数字孪生与影视制作将直接受益于长距离一致的三维场景;内容创作能在“可编辑几何”上叠加“高质量外观”,提升可控性与效率。
- 评测演进:单帧逼真度不再充分,跨视角结构一致性、漫游稳定性与可编辑性将成为新核心指标。
- 技术挑战:
- 动态场景与非朗伯材质的物理一致性建模
- 大规模数据下的分块优化与内存管理
- 尺度/单位歧义与相机自标定
- 几何—语义—外观三者的联合不确定性估计
- 研究方向:
- 几何感知的扩散采样器与跨视角得分蒸馏
- 面向生成的可编辑神经地图与回环一致性损失
- 学习先验驱动的自监督SfM/SLAM,推动重建与生成共享表征
几何的“反攻”不是回到纯几何时代,而是在学习范式之上补齐结构性的最后一公里。当局部先验与全局约束真正握手,三维视觉与空间智能才算站稳地基。
标签: 3D视觉 多视图几何 扩散模型 世界模型 空间计算
