Gemini3.8Live与扩展思考:告别语音沉默
引言
语音 Agent 最大的尴尬不在“不会说”,而在“沉默”——用户一句“帮我订机酒”后,助手往往陷入数秒无声,直到所有接口返回才开口。这种在语音通话中被放大的空白,让人难以判断系统是在思考、在执行,还是已经掉线。谷歌最新发布的 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking,正是为攻克这一“沉默时刻”而来:一边说话一边推理,一边聊天一边调用工具,将对话从线性问答,变成并行协作。
两款模型都面向实时语音交互,但定位不同:Gemini 3.8 Live 强调低延迟、易部署的主流选择;Extended Thinking 面向多步骤推理、跨多工具的复杂任务,在后台“思考+执行”的同时持续与用户互动。目前已通过 Gemini API 与 Google AI Studio 面向开发者开放。
核心内容
攻克“沉默时刻”:并行推理与异步工具调用
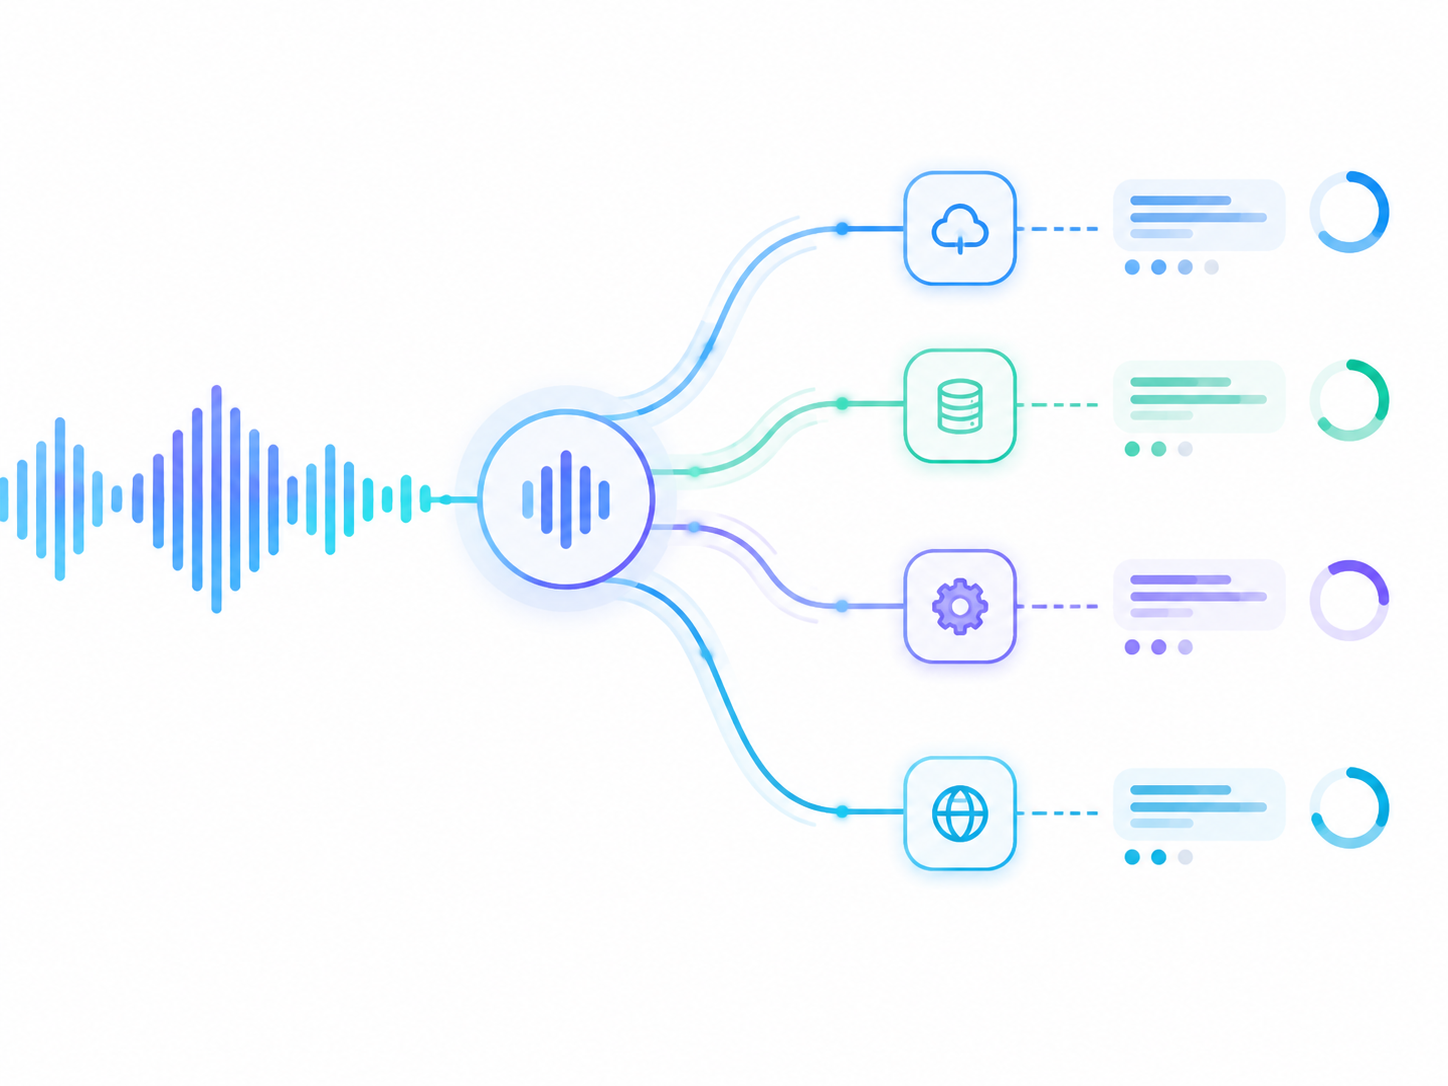
传统语音模型的响应是“说完=这一轮结束”。Extended Thinking 打破这一隐含规则:它可以先用自然语音反馈“我先查一下”,随后在后台规划任务、异步调用多个工具,并在执行中口头通报进度,最终汇总结果。这要求客户端从“音频流结束”转向“状态驱动”的会话控制——根据 Live API 的 IN_PROGRESS 与 IDLE 判断任务是否真正完成。
几个关键变化:
- 非阻塞工具调用是硬性要求:模型说话不停,工具后台跑,避免全局阻塞。
- 可调“思考深度”档位(低/中/高):深度越高,适合更复杂的多步任务,但可能牺牲部分时延与成本。
- Gemini 3.8 Live 也支持异步工具调用,但默认聚焦“低延迟、低复杂度”的语音场景,是更稳妥的基线选项。
用户体验的本质改进在于“连续感”:信息检索、比价、排障等流程不再是“一问一停”的回合制,而是“边说边做”的并行制。对话节奏被进度提示与阶段性结果填满,信任感与可控感随之提升。
从“能听会说”到“看得懂”:实时视觉与业务落地
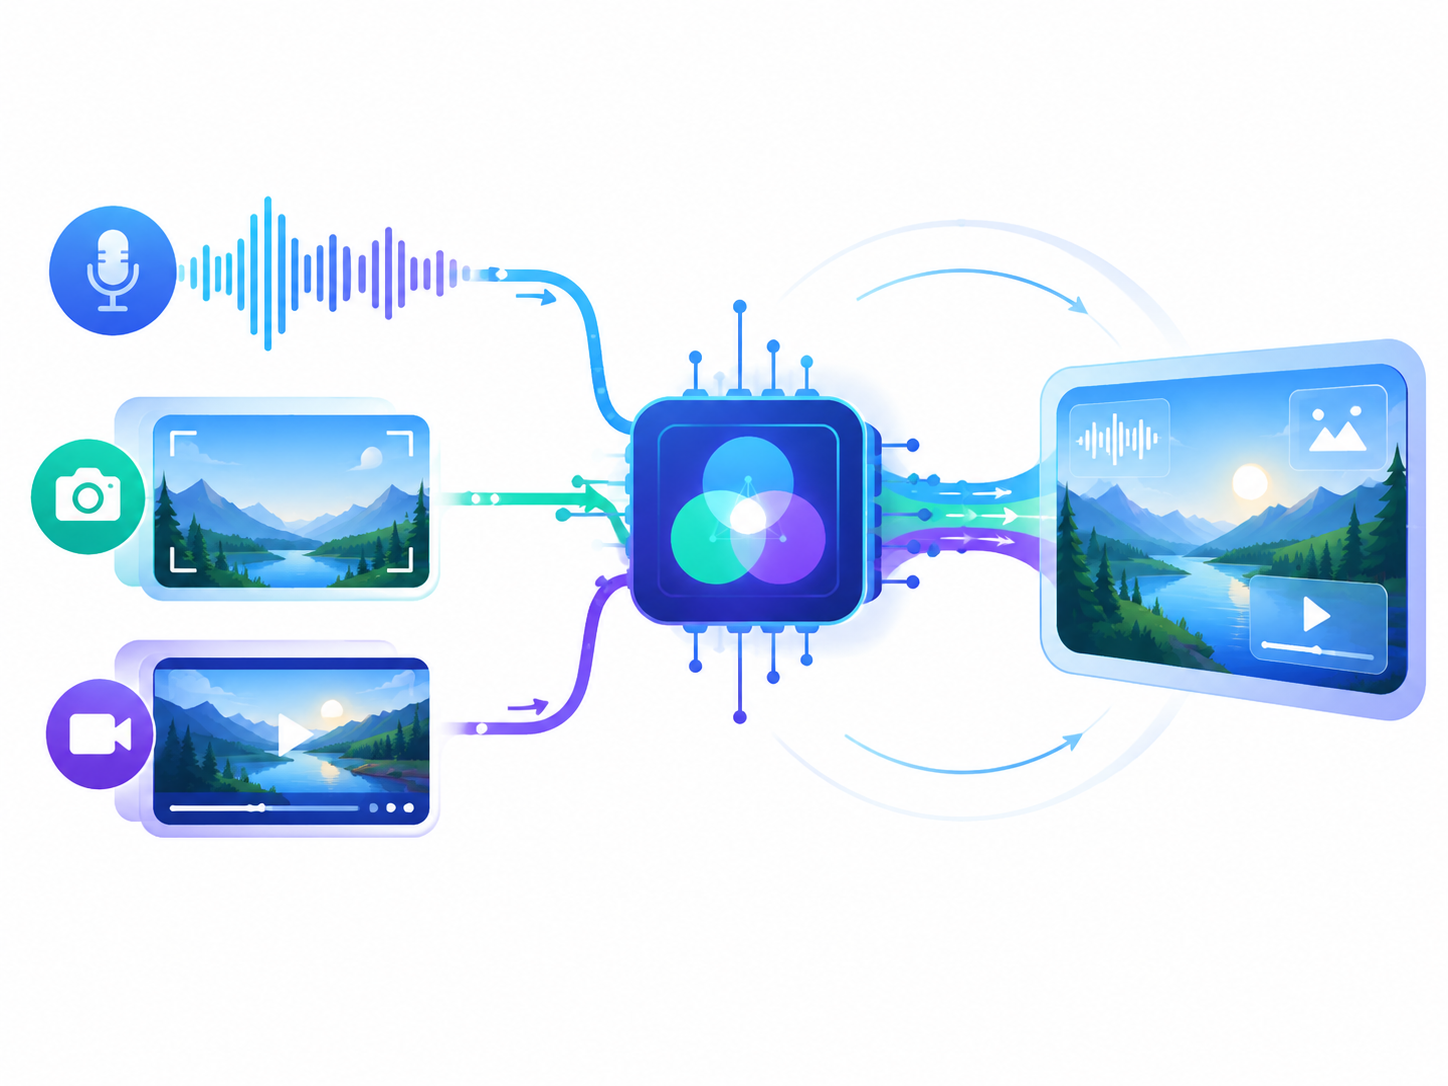
这次升级的另一核心是视觉输入。Gemini 3.8 Live 能在近乎实时的对话中处理来自摄像头或共享屏幕的画面,结合语音问题给出回答。这种多模态理解将语音 Agent 拉进真实世界的复杂情境。
典型落地场景包括:
- 现场支持:读取设备序列号、确认码、理赔编号等字母数字混合信息;在持续输出语音的同时调用企业 API。
- 培训与入职:基于屏幕或摄像头画面提供逐步指导与即时答疑。
- 实时决策辅助:如观察棋盘局面、一边交流一边推演策略。
- 多语言协作:支持在对话中识别并切换 97 种语言,降低跨语种沟通门槛。
工程侧需要注意“输入量治理”:视频帧默认会发送到模型,必须根据场景控制画面频率与分辨率,以平衡上下文占用与费用。两款模型均支持文字、图像、音频、视频输入,模型页面列出的输入上限为 131072 Token;支持函数调用,但文档未将代码执行、文件搜索或结构化输出列为支持能力。
版本取舍与开发者心智模型的重塑
Extended Thinking 不是“豪华版=永远更好”。选择哪一款,应从三维评估:
- 响应速度:电话客服、短问短答优先低延迟,Gemini 3.8 Live 更合适。
- 任务复杂度:跨多个接口、需要规划与溯因的任务更适合 Extended Thinking。
- 客户端能力:能否正确处理状态、并发与错误恢复,决定了并行执行的可用性。
对开发者而言,心智模型从“串行对话”转向“事件驱动协作”:
- 将“说话结束”与“任务结束”解耦,改用 IN_PROGRESS/IDLE 管理回合。
- 设计进度语句与阶段性回报,避免“假忙碌”或误导性反馈。
- 采用非阻塞工具编排,考虑超时、重试、幂等与回滚。
- 建立成本与时延监控,按需动态调整思考深度与视频帧率。
- 预设“降级路径”:从 Extended Thinking 回落到 Live,或从多工具回落到单工具,保证鲁棒性。
跑分与短板:语音智能的竞争焦点
在第三方评测中,Gemini 3.8 Live Extended Thinking(High 配置)拿到 82.6 的综合指数;在 τ-Voice Agent 任务测试中为 68.6%,在 Big Bench Audio 语音推理测试中为 97.7%。谷歌也披露其在 τ-Voice-banking 银行业务测试中为 35.1%。基础版 Gemini 3.8 Live 则在用户偏好榜中排名第二。
这些数字释放了三点信号:
- 竞争焦点已超越“说得自然”,转向“音频中的推理与任务完成率”。Big Bench Audio 的高分说明其音频推理扎实。
- 行业纵深任务仍具挑战,特别是银行等强约束、强合规的流程性场景(35.1% 提示仍有改进空间)。
- “High” 思考深度带来更强的多步能力,但意味着更高资源与潜在时延,产品化需要明确取舍。
影响与展望
实时语音 Agent 正在从“语音版搜索框”走向“对话态协作系统”。Gemini 3.8 Live 系列给出了清晰的工程范式:用并行推理与非阻塞工具打破沉默,用视觉上下文连接真实世界,用状态机管理长事务。这将直接影响三个方向:
- 业务流程重构:呼叫中心、现场支持、金融客服、运维排障等将以对话为中枢,串联后台系统,减少等待时间与人为转接。
- 交互设计升级:从“回答”转向“过程可见”,把进度、部分结果与不确定性透明化,提升信任与效率。
- 工程与治理并重:并发带来的复杂度上升,要求在编排、监控、合规与隐私保护上同步加强,尤其在视频与语音的连续上传场景。
展望来看,“语音+视觉+工具”的组合会成为智能 Agent 的新基线。下一阶段的竞争,将围绕三条主线展开:更低的端到端时延(含语音合成)、更高的任务完成率(尤其在合规敏感行业),以及更强的多语言与多模态稳健性。谁能把并行推理的能力产品化到可控成本、可解释过程与可运营闭环,谁就更接近“真正可用的语音 Agent”。
标签: 语音Agent 实时对话 多模态AI 工具调用
