具身智能的终局:从被训练到自我进化
引言
在大模型火热的几年里,人们习惯用“数据规模”来衡量智能的上限。然而一旦把智能从屏幕搬到现实世界,叙事就变了:机器人并不缺数据,缺的是“经验”。经验意味着在真实环境里试错、总结、抽象和迁移,是连续决策、长期目标和安全约束交织下的能力沉淀。围绕这一点,SeeAct AI创始人穆尧提出了一个尖锐判断:具身智能的终局,一定会从“被训练”走向“自我进化”,且核心机制将是奖励驱动。
这并非一句口号。从无标准数据集、无公认基准的荒芜期,到RoboTwin成为国内具身智能的重要参照,再到押注“具身自我进化”的创业实践,这条路径折射出一个更大的趋势:从离线监督走向在线学习,从静态标注走向动态奖励,从单点模型走向系统性的“经验工程”。
从数据到经验:具身智能的范式转向
在互联网文本上预训练的通用模型,面对现实世界会遭遇三类差距:
- 回馈闭环差距:文本是一次性输入输出,现实需要连续互动,动作会改变环境,反馈延迟且噪声大。
- 不确定性差距:物理世界不可完美建模,摩擦、柔性、遮挡、器具差异让“同一任务”每次都不相同。
- 目标耦合差距:任务不仅是“做成”,还要兼顾效率、安全、能耗、合规等多重指标。
这决定了具身智能必须以“经验”为核心资产。经验不是简单的数据堆叠,而是包含了情境、因果、回报的结构化沉淀。它需要:
- 在真实或高保真模拟中不断尝试;
- 通过奖励或偏好信号筛选值得保留的行为;
- 将成功的策略抽象为可复用的技能,并在新环境中组合迁移。
离线大模型仍然重要,但更多充当“知识库”和“先验”,最终性能取决于系统如何把知识转化为可执行、可复用、可累积的经验。
自我进化的技术底座:奖励、世界模型与技能库
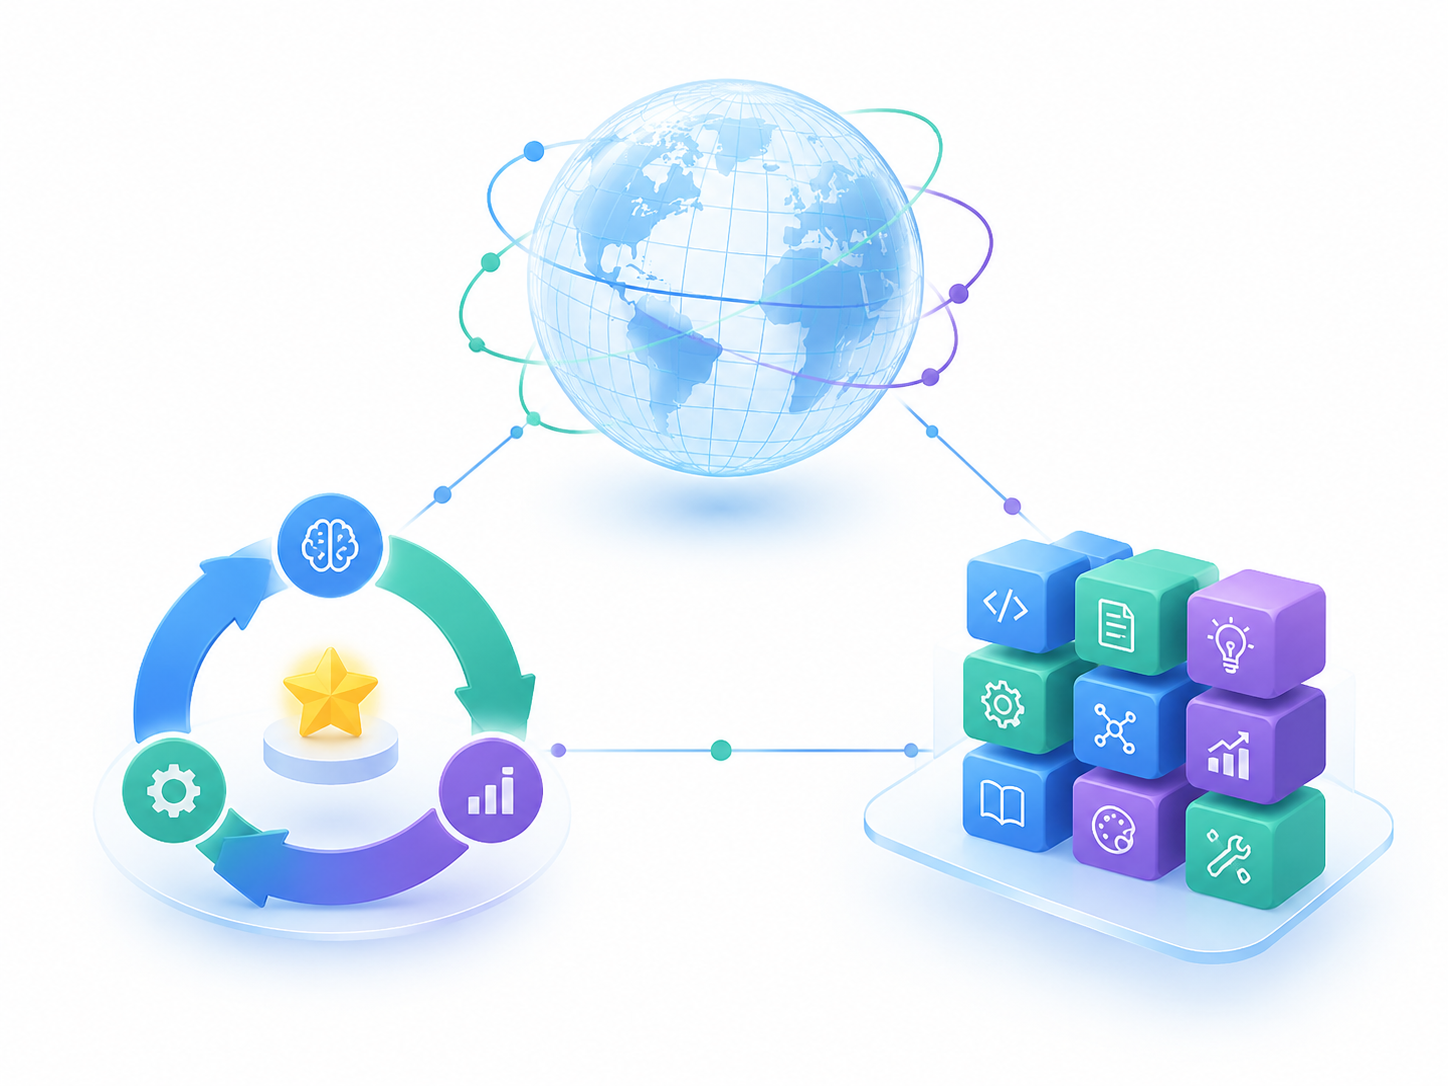
要让机器人从“被训练”走向“自我进化”,至少需要三块基石:
- 奖励驱动的学习循环
- 从手工奖励到偏好/对比学习,再到多目标加权,用“价值”而非“标签”驱动学习;
- 课程自动生成与难度自适应,让系统持续处在“可学但非平庸”的边界;
-
在线/近线更新,缩短经验吸收的闭环时延。
-
世界模型与不确定性管理
- 通过世界模型在模拟中“快进试错”,降低真实试验风险与成本;
- 明确模型置信度,遇到高不确定性时切换保守策略或人类介入;
-
将感知、预测与控制对齐,减少“看得懂但做不到”的割裂。
-
技能库与组合执行
- 把长任务拆为可验证的原子技能,构建层级策略;
- 以检索、条件生成或规划器进行技能组合,支持跨任务迁移;
- 动态维护技能的“版本”和“适用域”,防止遗忘与误用。
在这一框架下,“大模型+强化/偏好学习+仿真现实闭环”的混合范式,成为具身智能可落地的现实解法:大模型提供通用先验与语言接口,奖励机制负责价值对齐与目标分解,世界模型与技能库则让经验沉淀与复用成为可能。
标准与系统:从RoboTwin到产业化的“经验工程”
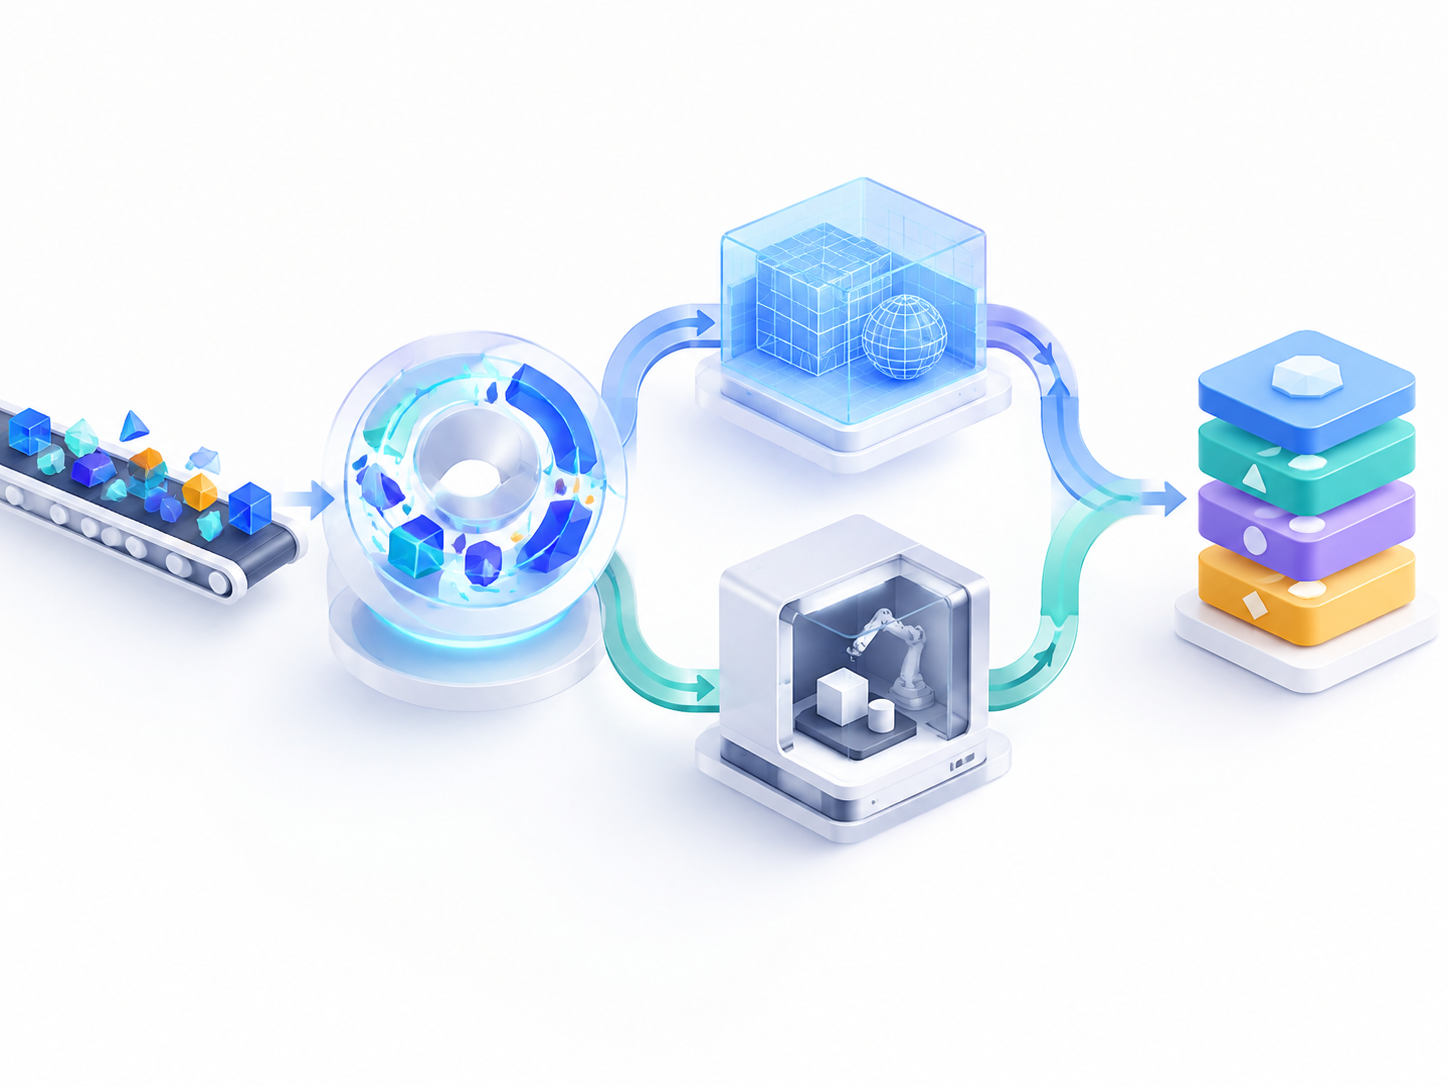
没有标准,就没有可复用的经验。RoboTwin之所以被广泛采用,不仅因为给出了一套可比较的任务与指标,更因为它把“如何收集、重放、评测经验”的流程工程化,成为社区可以共享的“经验基建”。在此基础上,工业界的系统不断刷新结果,本质上是把经验的采集、筛选和迁移做得更快、更稳、更广。
经验工程的要义在于“端到端的闭环”:
- 低摩擦数据引擎:遥操作、仿真合成、自动标注与偏好采集,形成可扩展的数据/经验管线;
- Sim2Real一致性:在动力学、视觉、材质上的对齐策略,让模拟经验可迁移;
- 安全与合规:在闭环中插入约束、监控和“急停”,把风险显式化;
- 评测文化:从单一成功率转向“演化速度”“适应跨度”“安全代价”等复合指标。
当这些环节被系统化,企业可以把具身智能当作“经验工厂”来迭代:不断生产新经验、筛选优质经验、沉淀通用技能,形成自我强化的护城河。
从实验室到公司:SeeAct的下注意味着什么
SeeAct这一下注,指向一个更明确的架构取向:把“看”(See)的通用表征与“做”(Act)的可复用技能用奖励管道焊接起来,让机器人在长时间尺度上自行积累能力。这种路线的商业意义在于:
- 降低标注与脚本成本:用偏好/奖励替代海量细粒度标签,避免规则爆炸;
- 提升长尾适应性:面对环境漂移与任务变化,通过在线进化维持性能;
- 可解释的安全边界:技能层级、置信度管理与人机共驾,为大规模部署提供底线。
当然,自我进化并非灵药。奖励设计、目标冲突、灾难性遗忘和算力成本都是真问题;如何在开放世界中持续学习而不破坏已学能力,需要更强的监控、评估与回滚机制。这些恰恰是下一阶段的竞争焦点:谁能把“学习能力”做成可靠的工程系统,谁就有机会把具身智能推过拐点。
影响与展望
奖励驱动的自我进化,如果在工业可控场景中跑通,将改变机器人研发的生产关系:研发从“模型交付”转向“系统迭代”,数据团队变成“经验运营”,评测部门升级为“演化审计”。更重要的是,用户与机器人之间会形成新的契约——不是一次性买断的能力,而是可持续成长的服务。
中短期看,混合范式会成为主流:以大模型作为通用先验,以偏好/强化学习实现价值对齐,以世界模型与技能库进行经验沉淀;在安全与合规上,坚持“人机共驾”的渐进式部署。长期看,一旦经验闭环足够高效,具身智能将从“被训练”自然过渡到“自我进化”,真正迈入能动的智能时代。
标签: 具身智能 强化学习 世界模型 机器人学习 自我进化
