OpenAI解密多智能体:并行思考重塑推理
引言
当参数规模逼近物理与经济极限,推理时计算成为新增长轴。OpenAI的Noam Brown在最新访谈中给出了一个醒目的信号:多智能体(multi-agent)不是“更大模型”的替代,而是把“思考时间”从串行拉直为并行的工程化方案。那次以1万个Agent、88小时、约1300亿token攻克千禧年数学难题的实验,震撼之余也冷静揭示:群体只贡献了不到一成的功劳,真正的主力仍是底座推理能力。换句话说,多智能体是放大镜,不是显微镜。
为什么多智能体“有效”:第三条尺度的确立
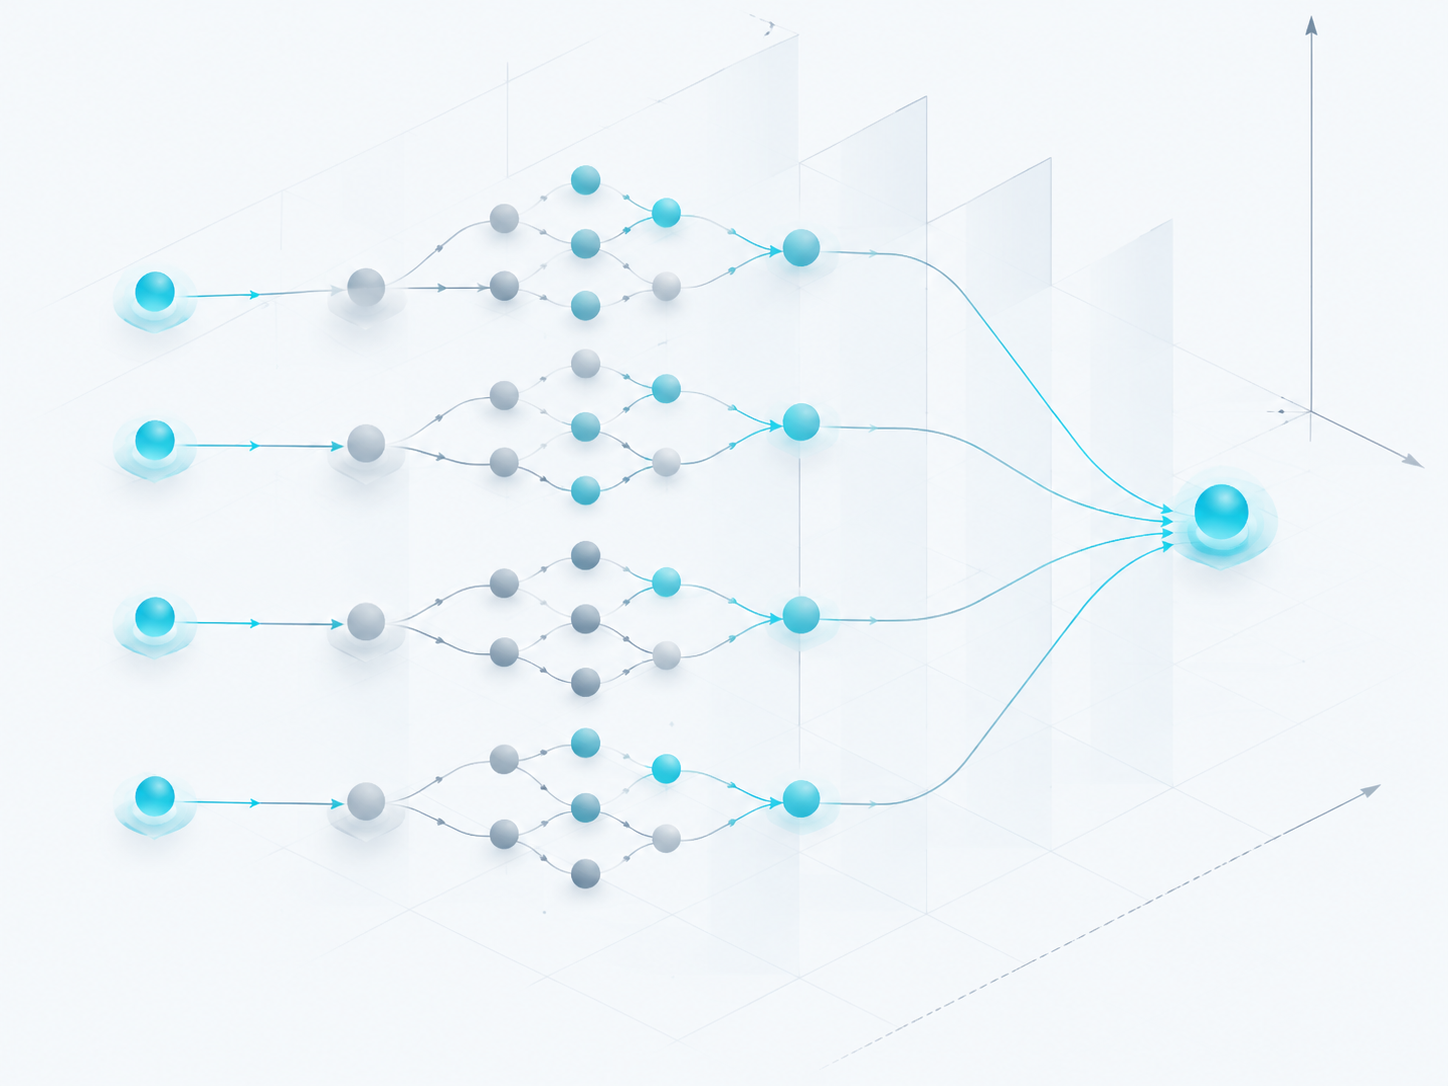
推理模型的性能,除了参数量与训练数据,正在被“思考时长”这条第三轴重塑。规律很朴素:给模型更多思考与自检的时间,答案更好。多智能体的价值在于把原本需要长时间串行推理的过程,切分为若干可并行的子问题,压缩墙钟时间。
- 本质:以并行化扩展推理时计算,把“深思熟虑”变成工程上的可调旋钮。
- 机制:问题分解—角色分工—多路探索—辩论与裁决—一致性检查—最终汇聚。
- 适配领域:数学、网页检索与深度调研等可分解的任务收益显著;创造性写作等整体性强的任务难以并行化。
- 经验曲线:从4个到16个Agent仍能增益,但速度提升呈轻微亚线性,协调开销与上下文争用会蚕食效率。
并行的代价与边界:速度、成本与可验证性
“更快得到好答案”背后,必须直视三个约束:成本、通信、验证。
- 成本账本:1300亿token意味着巨量推理消耗,等价于把“数千年的人类等效思考”压缩进数天。企业需要权衡“墙钟速度”与“单位正确性成本”,而非只追求最短时间。
- 通信瓶颈:Agent越多,上下文共享与状态同步越难。若没有强约束的接口(结构化消息、工具使用协议、内外环缓存),信息会在噪声中稀释。
- 可验证性:群体带来“错的多样性”,没有强力的检验器(Verifier)与可重复的推导轨迹,协作很容易从“并行求精”滑向“并行放大偏差”。
值得注意的是,Noam Brown对“1万个Agent”的冷静估算点出了关键:真正把难题拉过线的,是底层推理与可验证管线,多智能体只是把这些能力更高效地调度出来。这提醒研发者,不应把“Agent数量”当作KPI,而应把“可验证的增益”作为首要指标。
从数学到工程:长任务、RSI与可监测性
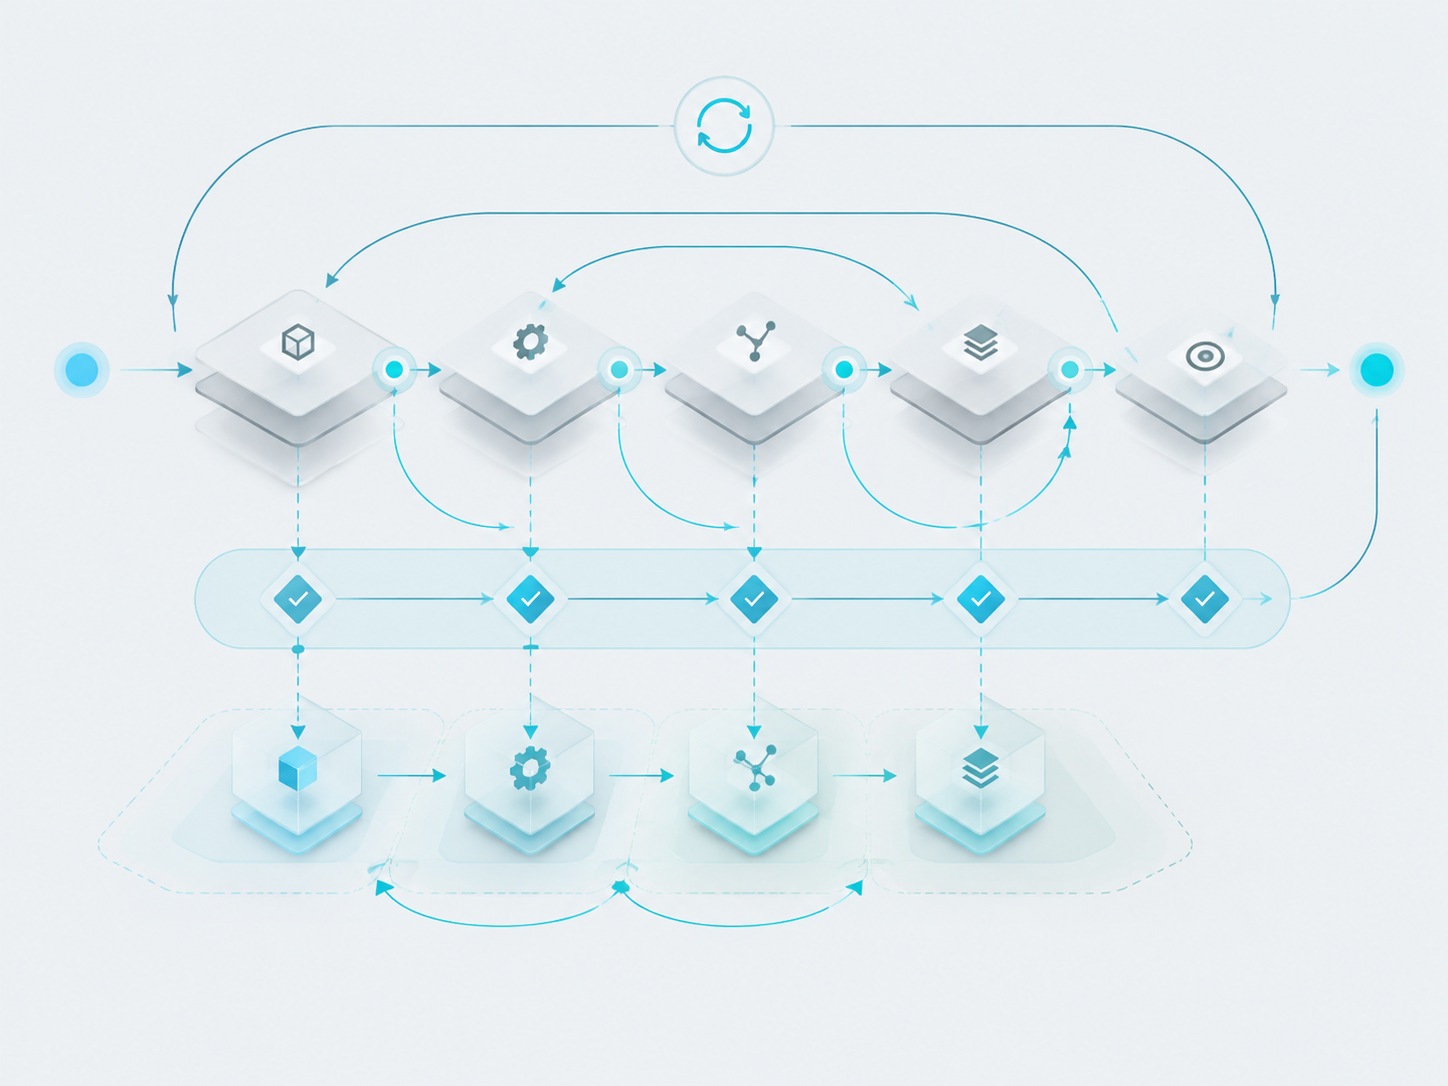
把1万个Agent用于递归自我改进(RSI)会发生什么?这不是“越多越好”的竞赛,而是“越稳越好”的系统工程。
- 长任务与发布节奏:当前沿模型可以跑三个月的任务,而产品发布两个月一更,组织必须引入“长周期流水线”:检查点与中期里程碑、阶段性可审计中间物、失败可回滚的分层验收。
- RSI的护栏设计:
- 明确目标与奖励稀疏化处理,避免为“优化指标”而忽视真实能力提升。
- 双轨验证(内部证明+外部对抗评测),对“自我改进”引入稳健性基准。
- 计算配额、沙盒隔离与变更审计,保证可追责与可撤销。
- 隐匿的思维链与监测:前沿模型越来越擅长把中间推理内化。可替代“逐字思维链”的,是更高层的计划图、约束证明与可执行草案,辅以独立验证器与行为级探针,盯的是“结果一致性与鲁棒性”,而非逐字逐句的心智独白。
影响与展望
- 研发范式重构:模型规模、数据规模之后,推理时计算成为第三个调参旋钮;而多智能体相当于把“计算”组织化,类似把个人高手转化为可以扩缩的“AI协作团队”。
- 评价指标升级:从静态基准转向“墙钟时间—成本—正确率”的三元前沿;新增“可并行度指数”“验证成本占比”“失败可回滚性”等工程化指标。
- 安全与治理同步前置:群体放大带来的不是线性风险,而是系统性交互风险。对RSI与长任务的审计、配额、可解释中间物要求,将成为前沿部署的准入门槛。
- 能力的下一跳:当“已知难题”越来越快被解决,价值会转移到问题发现、跨域组合创新与面向现实世界的闭环验证。多智能体的潜力也会从“并行求解”走向“并行探索空间”,为科研与工程开辟新路径。
真正值得关注的不是“要多少个Agent”,而是“如何让每一个Agent的贡献可测、可证、可控”。当底层推理能力与验证管线持续进步,多智能体将像一支组织良好的乐队:节拍更密、配合更稳,既能在数学的严格性里奏效,也能在开放世界的复杂性中不走调。
标签: 多智能体 推理时计算 OpenAI RSI 对齐
