工业级语义记忆:受治理让AI更准更稳
引言
从“构建 AI”到“驾驭 AI”的转向,正在把企业工程的重心从模型能力拉向系统化落地。即将在上海举行的 QCon 2026 聚焦 Harness AI 的工程实践,其中关于 Agent 记忆的讨论格外关键:工业与企业级场景真正需要的,并不是“跨会话记住用户说过什么”,而是把数仓、代码和工艺文档中零散而严苛的业务语义沉淀为可治理的共享记忆。对话式记忆固然重要,但在工厂和企业运营里,记错业务口径比忘记更危险,错误的“记忆”会被反复沿用,放大为系统性偏差。
核心内容
为什么对话式记忆搬不进工厂
主流记忆框架(如跨会话用户画像、时序知识图谱等)擅长记住“人机交互中的事实”,但工业 Agent 更关心“企业数据的语义一致性”。典型需求包括:
- 指标定义的分子分母与口径约束
- 同一工单/设备在不同表中的异名与映射
- 表结构缺少外键、命名晦涩下的隐式关联
这些知识并不产生于对话流,而埋在数据表、建表脚本与流程文档里。更棘手的是“记忆污染”:只注入半截语义(例如实体与关系但缺指标口径)会让模型更自信地选错表,正确率甚至低于完全不注入。对工业场景而言,这意味着错账、错控和错判。
结论很清晰:企业语义记忆不是松散的“提示词集合”,而是一项需要治理的资产,必须具备可裁决、可追溯、可撤销的能力。
受治理的语义记忆:写入、分层与纠错
要把数仓沉淀成多 Agent 共享的语义记忆,关键在“写入受控、证据分层、冲突可解”。
- 结构与置信分层
- 六要素:对象、关系、事件、指标、动作、场景
- 证据等级:verified(数据验证)、asserted(人工断言)、gap(知识缺口)
-
差异点在于置信由真实数据裁决产生,而非模型自评
-
写入把关:大模型只“提议”,数据来“裁决”
- 四道硬性判据:取值重叠度过阈值、子键不唯一、父键近似唯一、列名有据可依
- 未通过者降级为候选,不入正式记忆
-
时序假象防护:短窗口内看似重合的字段关系,必须拉长到月级验证;采样不足不予写入
-
冲突消解的三招
- 时间轴校验:用更长时间维度排除偶发重合
- 双源融合:代码中的 JOIN 证据优先于命名或描述性推断
-
对抗评审:独立评审者多数否决即打回重抽,避免“群体自信”
-
纪律与接口约束
- verified 只能由数据裁决产生;人工确认只能记为 asserted
-
将证据类型写入接口签名,杜绝“人工断言冒充数据验证”的灰区
-
与时序知识图谱的分工
- 时序图谱回答“事实何时有效”
- 受治理写入回答“这条记忆该不该被采纳”
- 两者处在记忆生命周期的不同端,可互补协同
记忆如何被用好:共享、调度与动态上下文
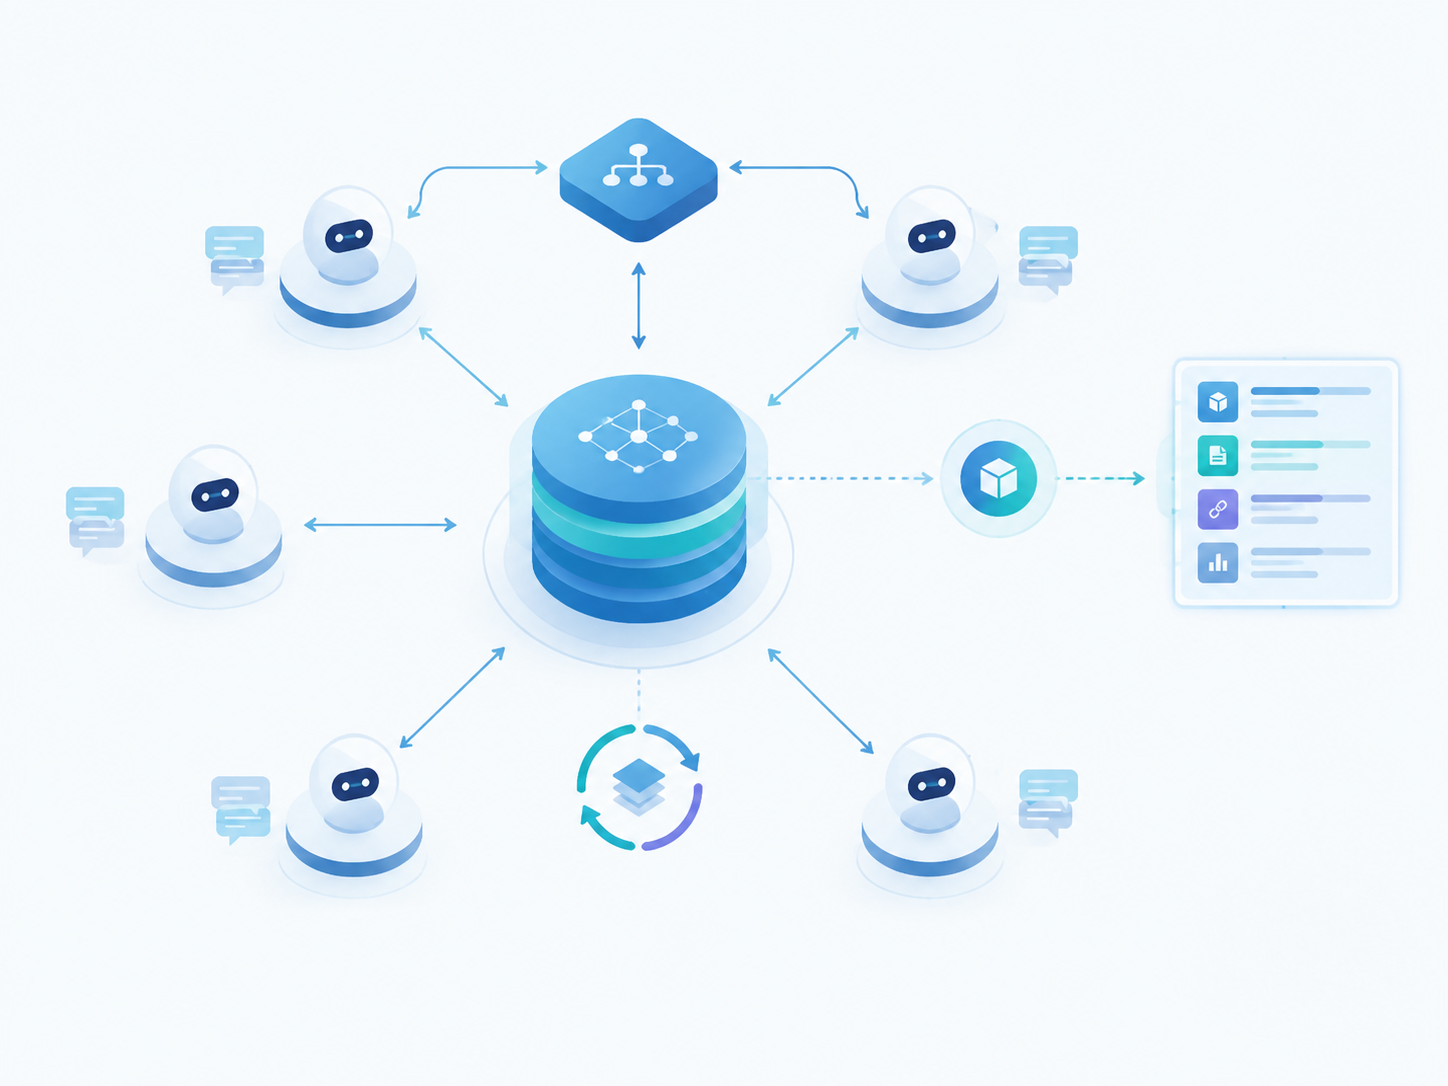
有了受治理的语义记忆,使用侧要做到“按对象锚定、随任务生成上下文、全链路可回退”。
- 共享与调度
- 多个 Agent 读写同一套语义层,统一口径不跑偏
-
调度器利用共享记忆分配子任务(查询、比对、生成、编排),减少重复对齐成本
-
动态上下文构建
- 以对象为锚(如工单、设备、指标),在调用前按需拼装上下文
-
只注入与当前对象和场景强相关的事实、口径与证据,控制上下文体积,降低幻觉
-
提示词组件与回归断言
- 将教训沉淀为可插拔提示词组件:指标口径卡片、表间映射卡片、质量闸门卡片
-
为关键问答与 SQL 生成设置回归断言:一旦答案偏离既有口径,自动告警并触发回滚
-
可撤销与可追溯
- 记忆版本化与回收站机制,错误记忆可撤销、可重演
- 指标与表映射的血缘追踪,让每次调用都能解释“依据何在”
影响与展望
语义记忆的治理将成为 Agent 工程的新基建,把数据治理与 AgentOps 拉到同一张桌子上。几条趋势值得关注:
- 架构上,语义层、知识图谱、向量检索将趋于融合;“对象锚定的 RAG”与“证据分级的事实库”会成为通用模式
- 工程上,受治理的写入与冲突消解将纳入 CI/CD;提示词组件化与语义回归测试,成为从实验到生产的必备护栏
- 组织上,数据团队与应用团队的边界被打通,出现“语义记忆管理员”角色,负责标准口径与记忆质量
- 生态上,围绕 Agent Runtime、Data Systems、可观测与安全的工具链将提供开箱即用的记忆治理能力,包括指标口径仓、证据评分器、时间轴校验器等
- 价值上,语义一致性直接转化为可审计、可复用、可迁移的智能生产力,减少错账与错判的系统性风险
当企业把“语义记忆”当作资产来管理——写入有裁决、冲突有消解、经验能沉淀、错误可撤销——Agent 才能真正从个体聪明走向群体稳健,在端云协同的复杂环境中长期可靠运行。这既是 Harness AI 时代的工程答案,也是让 AI 从能力走向系统、从实验走向生产的必经之路。
标签: Agent 语义记忆 企业数仓 数据治理 QCon上海
