RSI再创奇迹!StartLux推出开源决策模型StartLux-Decision,38项基准中31
引言
从对话到推理,再到能够权衡成本、风险与收益的“决策”,大模型能力版图正在迅速扩张。最新亮相的开源决策模型 StartLux-Decision,为这一赛道增添了颇具分量的坐标:在独立的 Decision Index 0.2.1 评测中,27B 版本获得 63.88 分,并在 38 项基准中有 31 项超过 Jev 1.13;在上海人工智能实验室发布 Intern-Decision 时采用的七项评测中,其 27B 模型平均准确率达到 91.82%,同样高于 Jev 的 88.74%。对“更会做决策”的模型,社区一直期待明确的证据链,如今数据给出了清晰信号。
这不仅是一次分数上的领先,更代表着“决策智能”在开源生态的质变:从通用对话能力向可控、可验证、可复现的决策过程迈进。下面,结合公开信息与决策模型的技术脉络,来解析 StartLux-Decision 的看点与意义。
决策模型的关键之处:从“会说”到“会选”
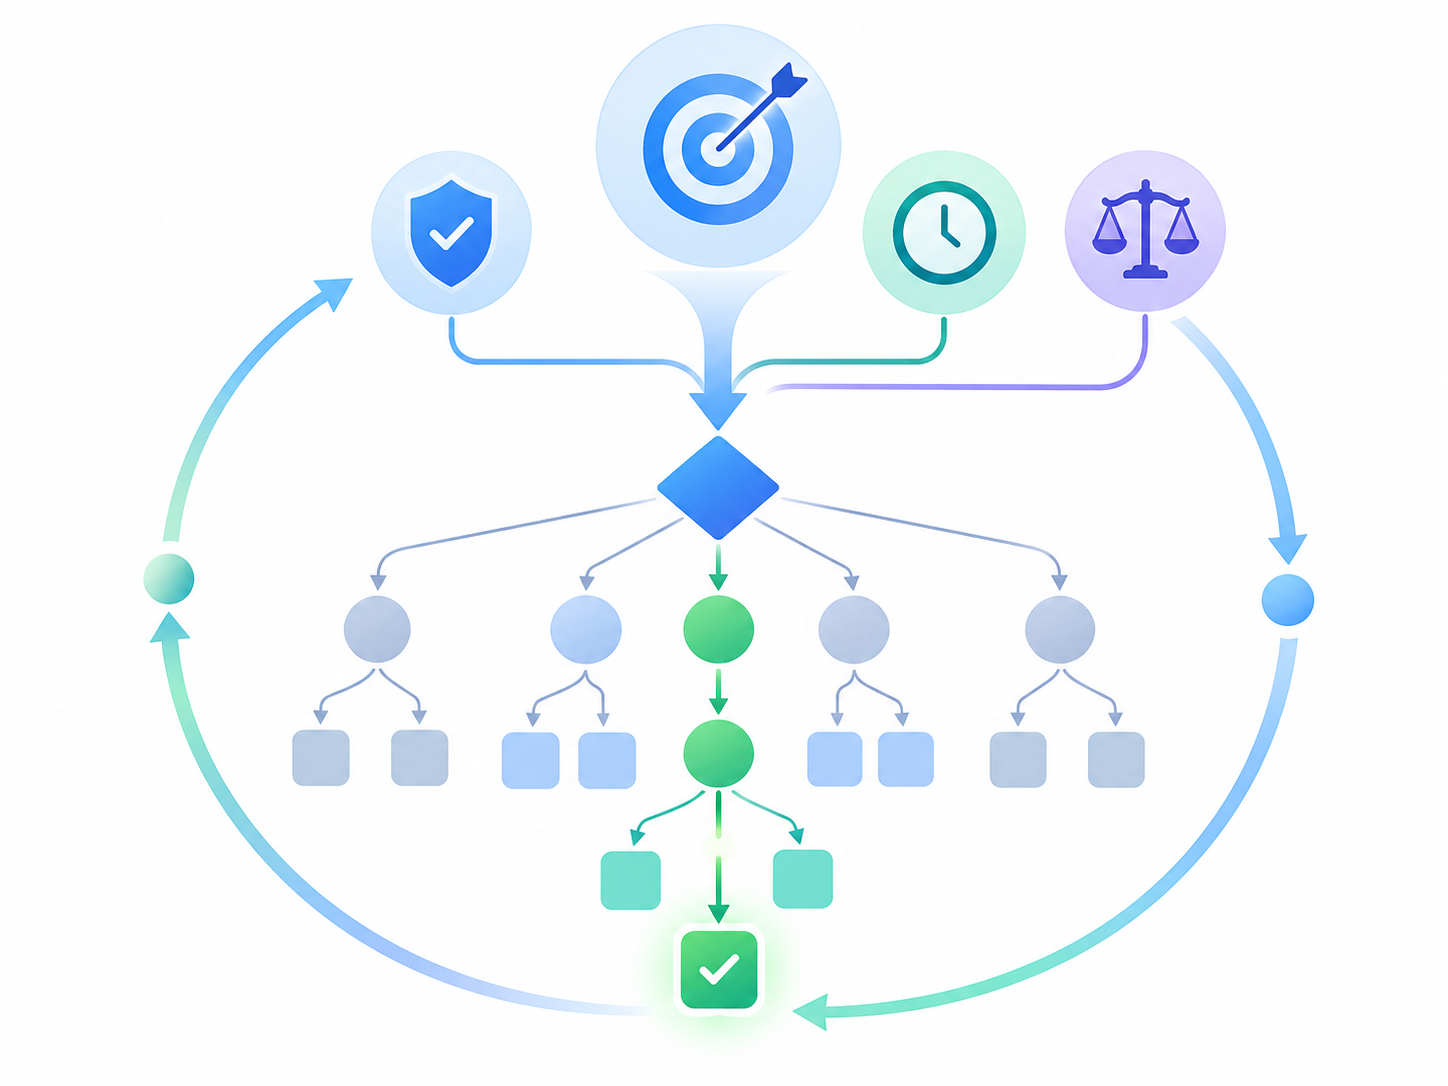
与传统大语言模型相比,决策模型有三个显著区别:
- 明确目标与约束:不仅生成看似合理的文本,还要在给定目标(如收益最大化、风险最小化、合规优先)与约束(时间、资源、规则)下输出可执行的选择或计划。
- 可追踪的推理链:强调过程透明,例如对选项的比较、代价估计、风险分析、备选方案权衡,便于验证与复盘。
- 稳健性与校准:不仅正确率高,还要在不确定性较大时保持适当保守,必要时拒答或调用外部工具以降低错误决策。
Decision Index 这类评测通常集成多维基准,例如策略规划、规则遵循、数理约束、工具调用与任务分解等,以观察模型在“选择—执行—反馈”闭环中的一致性和可靠性。因此,StartLux-Decision 在 38 项基准中有 31 项超越 Jev 1.13,并拿到总分 63.88,意味着其优势并非集中在某几个“熟练题型”,而是出现在广泛的决策场景中。
而在上海 AI 实验室相关的七项评测上,27B 模型 91.82% 的平均准确率对比 Jev 的 88.74%,说明在另一套具有代表性的任务设置中,StartLux-Decision 也能保持领先。这类跨基准的一致上风,有助于缓解“只在某个榜上强”的疑虑。
StartLux-Decision 的可能路径:稳态决策与多步推理
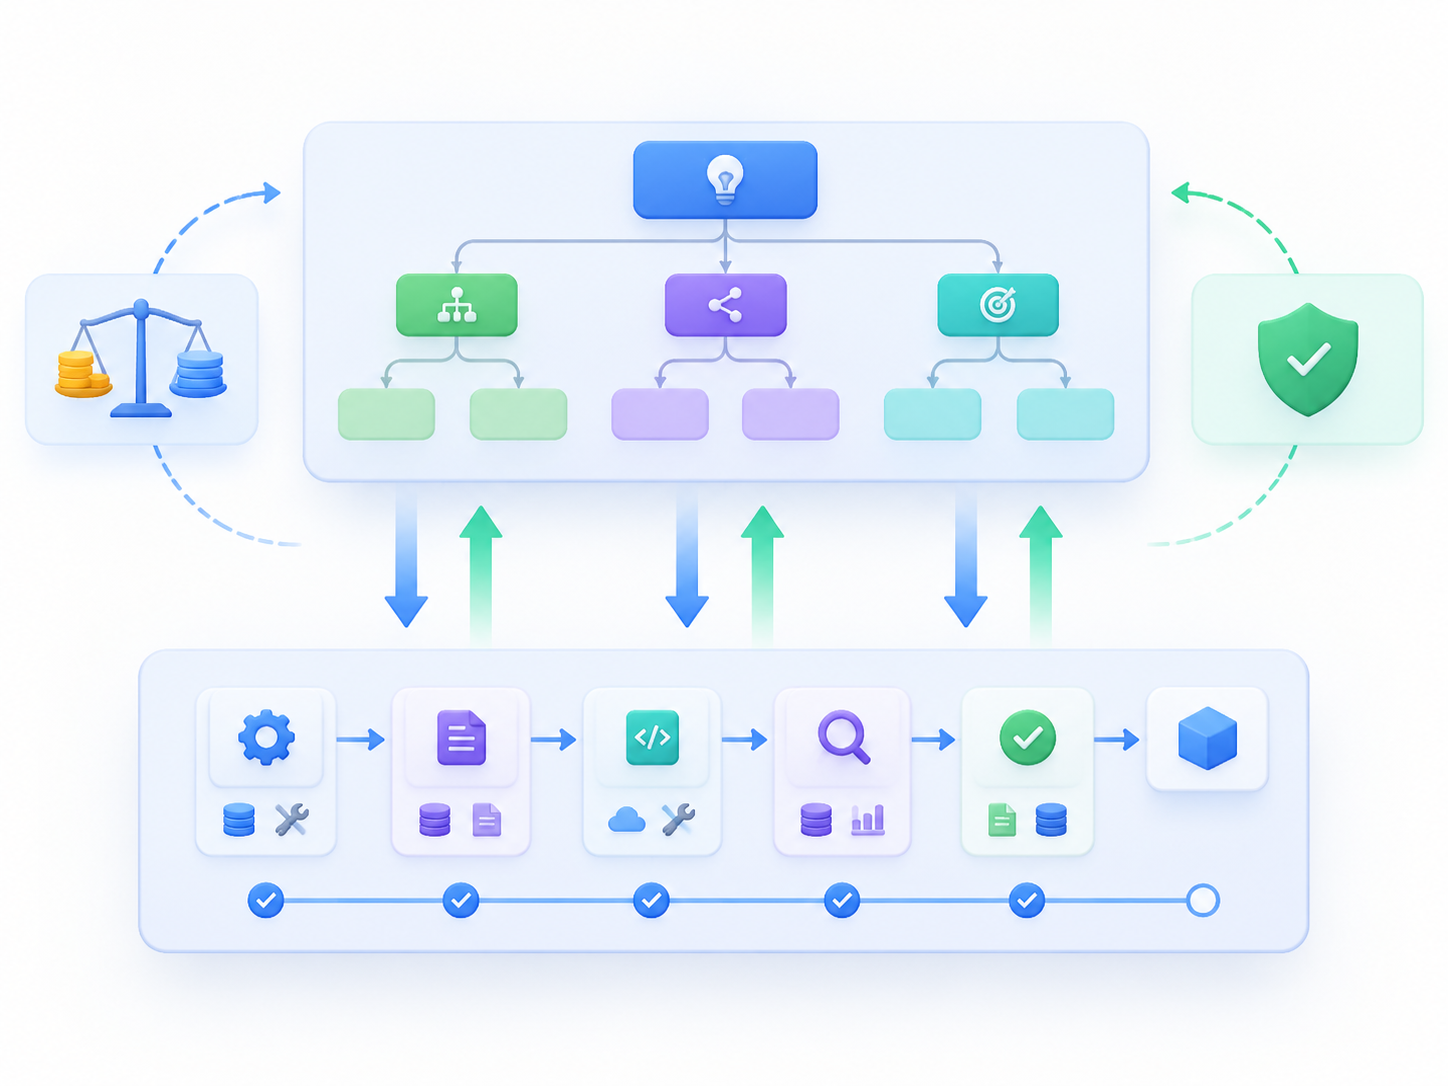
虽然尚未披露完整的训练配方,但从决策模型的共性与表现推测,StartLux-Decision 很可能在以下方面下过功夫:
- 多步规划与执行器解耦:通过“规划器-执行器”的架构,将高层决策(目标设定、路径设计)与低层行动(步骤执行、工具调用)区分开来,使得策略可解释、可调参、可复用。
- 代价与风险内化:在提示或训练阶段引入代价函数与风险偏好,鼓励模型在面对收益相近的选项时偏向更稳健的选择,提升决策校准度。
- 结构化输出与一致性检查:生成可结构化解析的决策计划,并辅以自检(如置信度标注、约束校验、步骤对齐),减少“自然语言看起来对但逻辑不自洽”的问题。
- 任务混合与反馈强化:通过覆盖广泛场景的数据(例如调度、预算、合规、策略博弈)与反馈信号,提升模型对“长尾、长程、长约束”三类难题的泛化能力。
这些机制的共同目标是,将生成式能力转化为可落地的决策能力:在复杂环境中保持稳定、在冲突约束下进行权衡、在不确定性面前做出合理的跨步或止步。
开源的现实价值:让决策智能走向工程化
StartLux-Decision 的开源属性有两层意义:
- 可复现实验与对齐实践:开源模型降低了研究与企业团队的试验门槛。无论是对齐策略(如基于偏好或结果的奖励设计)、还是工具调用管线(函数调用、检索、外部模拟器),都能在统一基线下进行可比对的改进。
- 嵌入 Agent 生态:决策模型是智能体(Agent)系统的“中枢”,负责任务分解、资源分配与策略切换。开源让其更容易嵌入各类工作流与行业工具链,例如自动化运营(RPA)、运营优化(调度与排产)、数智决策(财务与风控)、以及具备行动能力的机器人系统。
业界的一个共识是,单纯追求“更会说”的模型很难支撑工程级的自动化;需要“更会选、更会管控”的模型,才能承载责任边界与风险控制。StartLux-Decision 这类开源基座,为企业级应用提供了可验证的决策骨架,有助于从“灵感型 AI”走向“责任型 AI”。
对比与边界:领先背后的未尽之处
尽管成绩亮眼,理性看待基准分数仍然必要:
- 基准覆盖并非全域:离线评测难以完全覆盖动态、非平稳环境,如市场突发、用户偏好漂移、规制更新等。真实世界的反馈闭环仍需在线评估与 A/B 场景验证。
- 长程依赖与资源约束:长时间跨度、强资源约束的任务(如数周的多项目协调)对记忆、状态压缩与策略持久性提出挑战;如何在不丢失上下文的前提下降低成本,是工程上需要持续攻关的问题。
- 对齐与安全的双重负担:决策模型不仅要“能做”,还要“懂边界”。当目标冲突与伦理约束出现时,如何进行可解释的权衡与可审计的拒绝,仍需要更细粒度的安全策略。
领先的分数意味着起点更高,但真正的竞争会发生在“可重复、可解释、可治理”的落地过程中。
影响与展望
StartLux-Decision 的发布,为“决策智能”的开源版图新增了关键一极。结合多项权威评测的亮眼成绩,可以预期以下变化:
- 决策共识的形成:随着 Decision Index 等评测被更广泛采纳,决策模型的能力刻度将逐步统一,有利于社区避免“各自称王”的碎片化状态。
- 工程化能力的下沉:开源模型与工具链的结合,降低了在企业流程中部署决策智能的门槛,推动从实验室样机走向生产级流水线。
- 小大并行的产品线:在 27B 等中大型参数规模取得领先后,更小型、低延迟、便于边缘部署的蒸馏版本值得期待,形成从云到端的决策智能栈。
- 安全与合规的深度融合:在法规趋严与行业标准化推进的背景下,决策模型需要内生的风险管理能力,如置信度暴露、审计轨迹、策略约束语言等,而开源生态将成为共同试验场。
通往“决策即服务”的未来,关键在于把可解释性、可复现性与可治理性贯穿始终。StartLux-Decision 的出现,是一次重要的集体进步信号:决策不再只是“聪明的一瞬”,而是可以被训练、被评价、被复用的工程能力。若后续在更多真实世界任务与在线评测中持续展现稳健性,开源决策模型或许会成为新一代 AI 系统的默认中枢,支撑从个人助理到行业平台的全栈智能化。
标签: 决策模型 大语言模型 开源生态 AI评测 智能体Agent
