引言
当多智能体(Multi-Agent)从实验室迈入企业生产线,难题不再是“能否调用大模型”,而是“如何在成本、时延、可靠性边界内,把任务真正交给 AI 完成”。随着模型具备更强的推理、工具调用、多模态与长任务能力,系统关注点从单次推理速度,扩展到任务依赖、上下文演化、执行环境与反馈回路的整体设计。2026 年 AICon 北京的“面向多智能体应用的大模型推理调度与缓存优化”主题,正是面向这一转折点给出工程化答案:模型决定 Agent 能做什么,工程决定它能否落地创造价值。
从“单次调用”到“系统工程”:多智能体引发的性能重构
多智能体协作的典型流程包括任务分解、工具调用、多轮交互与结果汇聚,应用性能指标也必须从“单次调用延迟”提升为:
- 端到端任务完成时间与关键路径时延
- 多轮交互的轮次时延(回合时间)
- 在既定 SLO 下可支持的并发规模与成本
其中,KV Cache 成为系统性能的抓手与瓶颈来源。一方面,上下文持续增长带来推理与存储压力;另一方面,工具调用的外部等待在时间轴上制造“空窗”,而显存仍被占用。跨智能体的相似上下文又导致潜在可复用的数据无法被高效共享。这使问题从“算得快”变为“调度对、存得巧、复用好”。
痛点诊断:围绕 KV Cache 的三维瓶颈
多智能体推理的低效,集中体现在 KV Cache 的时间、空间与共享三个维度:
- 时间维度:智能体等待外部工具(检索、执行脚本、调用 API)时,缓存占用显存却不产生计算;若直接丢弃,恢复执行又需高代价的重计算与数据搬运。
- 空间维度:显存是稀缺资源,非关键路径任务可能“挤占”关键任务所需的缓存,导致关键路径阻塞、尾延迟拉长。
- 共享维度:多个智能体接收相同或高度相似的内容,但由于各自历史与内容位置不同,常规前缀缓存难以复用,形成重复存储与重复计算。
可行的分析方法,是把执行时间线、任务依赖图与缓存生命周期放在一起观察,定位等待、抢占、重计算与重复存储的来源,为后续优化提供决策依据。
TokenCake:智能体感知的推理调度与显存管理
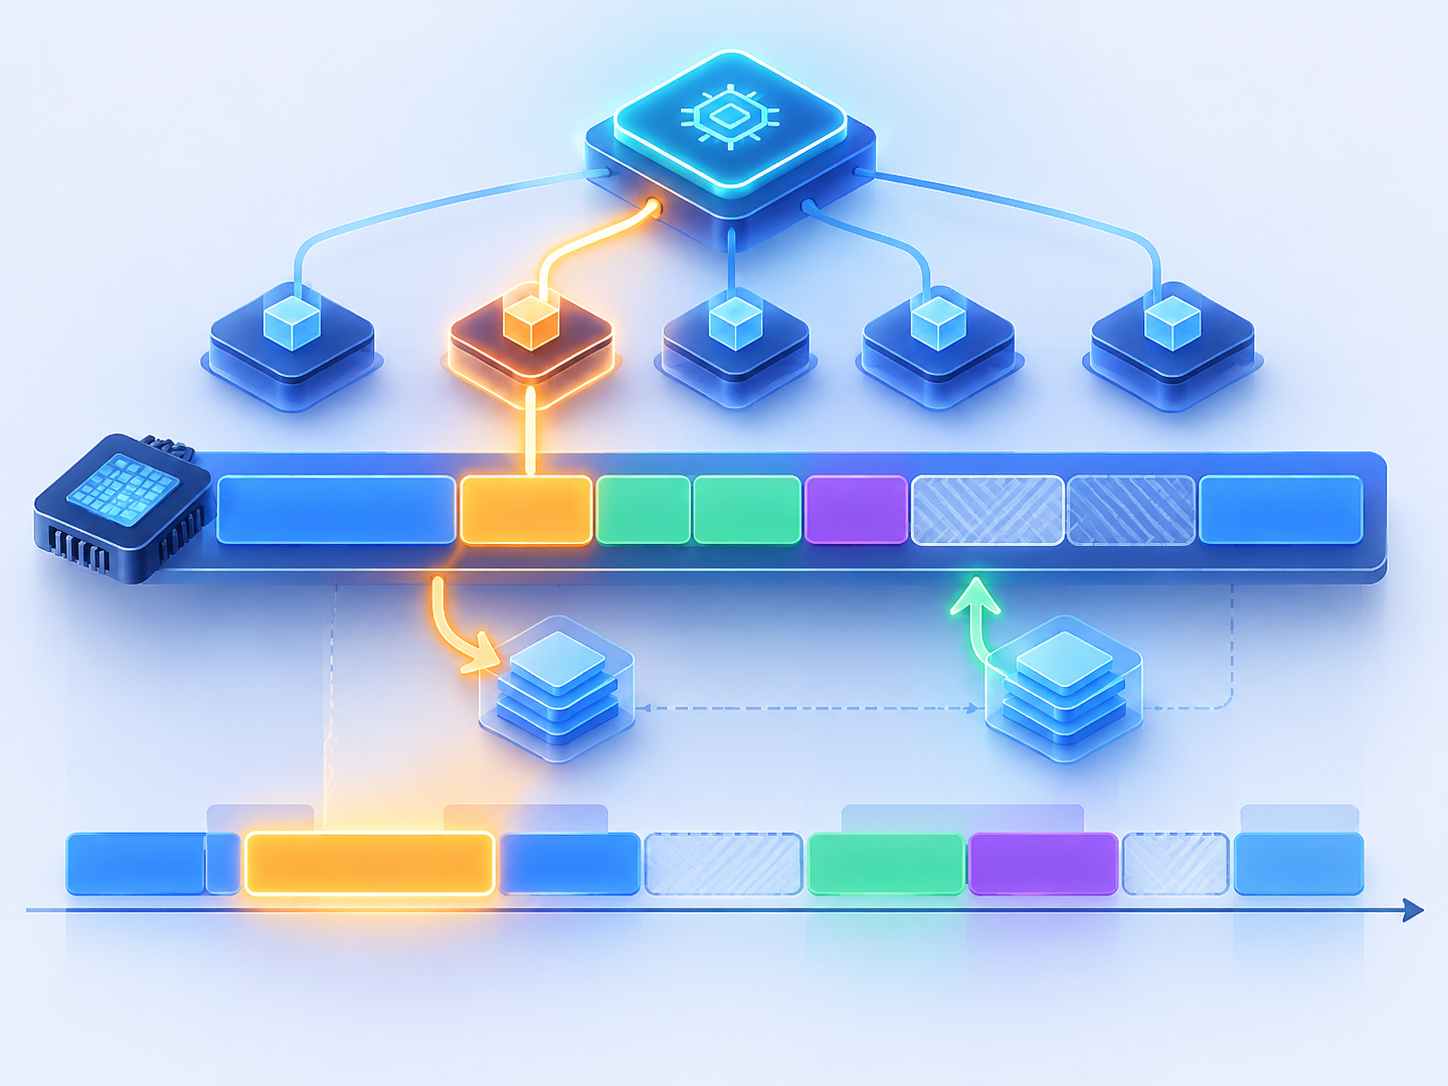
TokenCake 的核心,是让推理系统“看见”应用层的信息,并据此联动调度与缓存管理:
- 应用信息表达:把智能体间的依赖关系、工具调用事件与运行状态传入推理后端,让调度器具备全局视野。
- 空间调度:结合依赖图与实时状态确定优先级,通过动态显存分区与门槛控制,保障关键路径的缓存与算力,不让次要任务挤占资源。
- 时间调度:识别工具调用形成的空窗期,主动卸载闲置缓存,降低占用;在预估恢复时间点前进行预测式回迁,减少恢复时的等待。
- 协同机制:在“任务优先级—显存压力—迁移成本”三者之间求解折中,统筹减少关键路径阻塞与上下文重计算。
在协作式代码生成等场景中,TokenCake 可利用单测执行、依赖安装等外部等待窗口,腾挪关键缓存并提前预热回迁,显著压缩端到端时延与 P95 尾延迟,同时提升单位显存下的并发量。
TokenDance:轮次级共享与差分存储,面向 All-Gather 协作
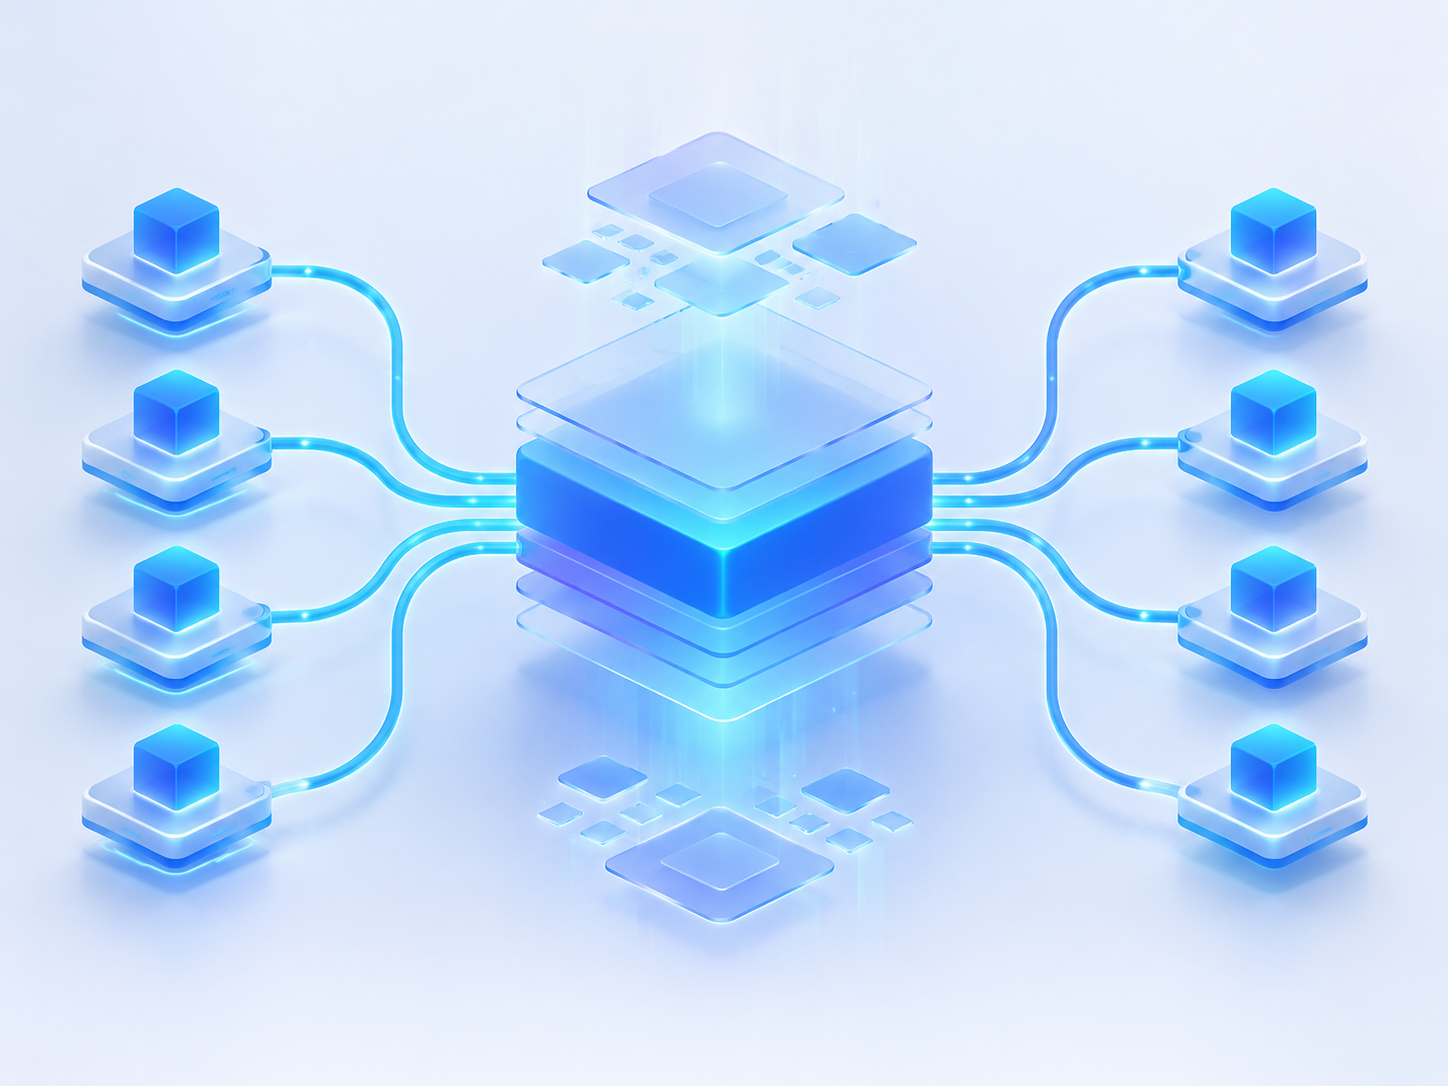
多智能体常采用“各自生成—集中汇聚—分发共享上下文”的交互模式(类似 All-Gather)。TokenDance 针对这一轮次化协作设计缓存复用策略:
- 集合式复用:保留提示词的逻辑块结构,把上下文兼容的请求成组处理,集中构建与复用缓存,摊薄共享开销。
- 差分存储:为共享部分保留主副本,仅为各智能体维护私有差分,避免大段相似缓存的重复保存。
- 融合恢复:将差分恢复与缓存传输融合为一次流水操作,把额外的数据搬运成本降到最低。
- 适用边界:当共享上下文比例高、请求兼容性强时收益最大;若输出质量需要更强多样性或上下文分歧较大,复用粒度与分组策略需谨慎调优。
在深度研究、多角色协作写作、社会模拟等场景中,TokenDance 可减少跨智能体的重复计算与存储,让多轮协作的总体吞吐更稳、更省内存。
工程落地与评估方法:从“算法好”到“系统好”
为了让优化真正进入生产,需要明确模块边界与数据交换:
- 接入路径:应用编排层将依赖图、轮次计划与工具事件上报;推理调度器据此分配批次与显存;缓存管理模块负责卸载、回迁、差分与融合。与现有推理引擎集成时,可通过中间层适配,不必重写内核。
- 案例实践:对协作式代码生成与深度研究,重点优化关键路径与工具等待;对 Generative Agents、AgentSociety 等多轮协作,强化共享与并发伸缩。
- 评估指标:同时观察端到端完成时间、P95/P99 尾延迟、吞吐与并发能力、显存占用与复用率、重计算比例与数据搬运开销,避免“局部快、整体慢”的错觉。
影响与展望
多智能体时代,大模型推理系统不再是“黑盒算力器”,而更像“面向任务的微型操作系统”。谁能在调度与缓存上拿到系统级红利,谁就能以更低成本、更稳 SLO 交付更复杂的智能体工作负载。TokenCake 与 TokenDance 的价值在于将应用结构引入推理内核,用显存与时间的双维度协同把资源花在刀刃上。
展望后续,几条方向值得关注:
- 更细粒度的显存管理:KV 压缩、量化与片上/片外分层存储的协同。
- 预测与自适应:基于历史与依赖图的等待窗口预测、预取与动态批处理。
- 跨模型与多模态:在异构模型与多模态上下文间实现可迁移的差分与复用。
- 运行时标准化:统一的智能体—调度—缓存接口,降低接入与迁移成本。
当工程与模型能力相互增益,Agent 才能真正走进企业流程,承担可度量、可验收、可控成本的生产角色。这也是当前产业从“能跑起来”迈向“跑得稳、跑得值”的关键一步。
标签: 多智能体 大模型推理 KV缓存 调度优化
还没有评论
发表评论