引言
面向长文档、智能体与多轮交互的时代,基础模型的“效率曲线”正在被重新绘制。最新开源的文心 5.5 Flash Base(ERNIE 5.5 Flash Base)以大规模 MoE 架构、极长上下文与系统级优化为核心,在知识、推理、数学、代码、多语言与长上下文等多项基准测试上刷新同尺寸模型表现,指向一个清晰趋势:大模型竞争正从参数堆叠转向“有效算力”的极致利用。
核心内容
规模与架构:用得其所的“2800 亿”
- 架构与激活:采用稀疏 MoE,总参数量约 2800 亿,但每个 token 仅激活约 140 亿参数,在性能与成本间取得良好折中。
- 训练与上下文:使用约 33.5 万亿 token 预训练,预训练上下文长度至 128K;微调与推理阶段支持最长 100 万 token,这对长文档理解、跨会话记忆与复杂任务规划尤为关键。
- 评测结果:在同尺寸基座模型对比中,文心 5.5 Flash Base超越 DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base 等,显示出在广域能力上的均衡与领先。
要点在于“每 token 激活参数”与“可用上下文”的统筹。相较于一味扩容总参数,稀疏激活让算力使用更聚焦,配合极长上下文能力,模型拥有更大的问题分解与信息整合空间。
注意力与长上下文:稀疏、门控与表达力的三重奏
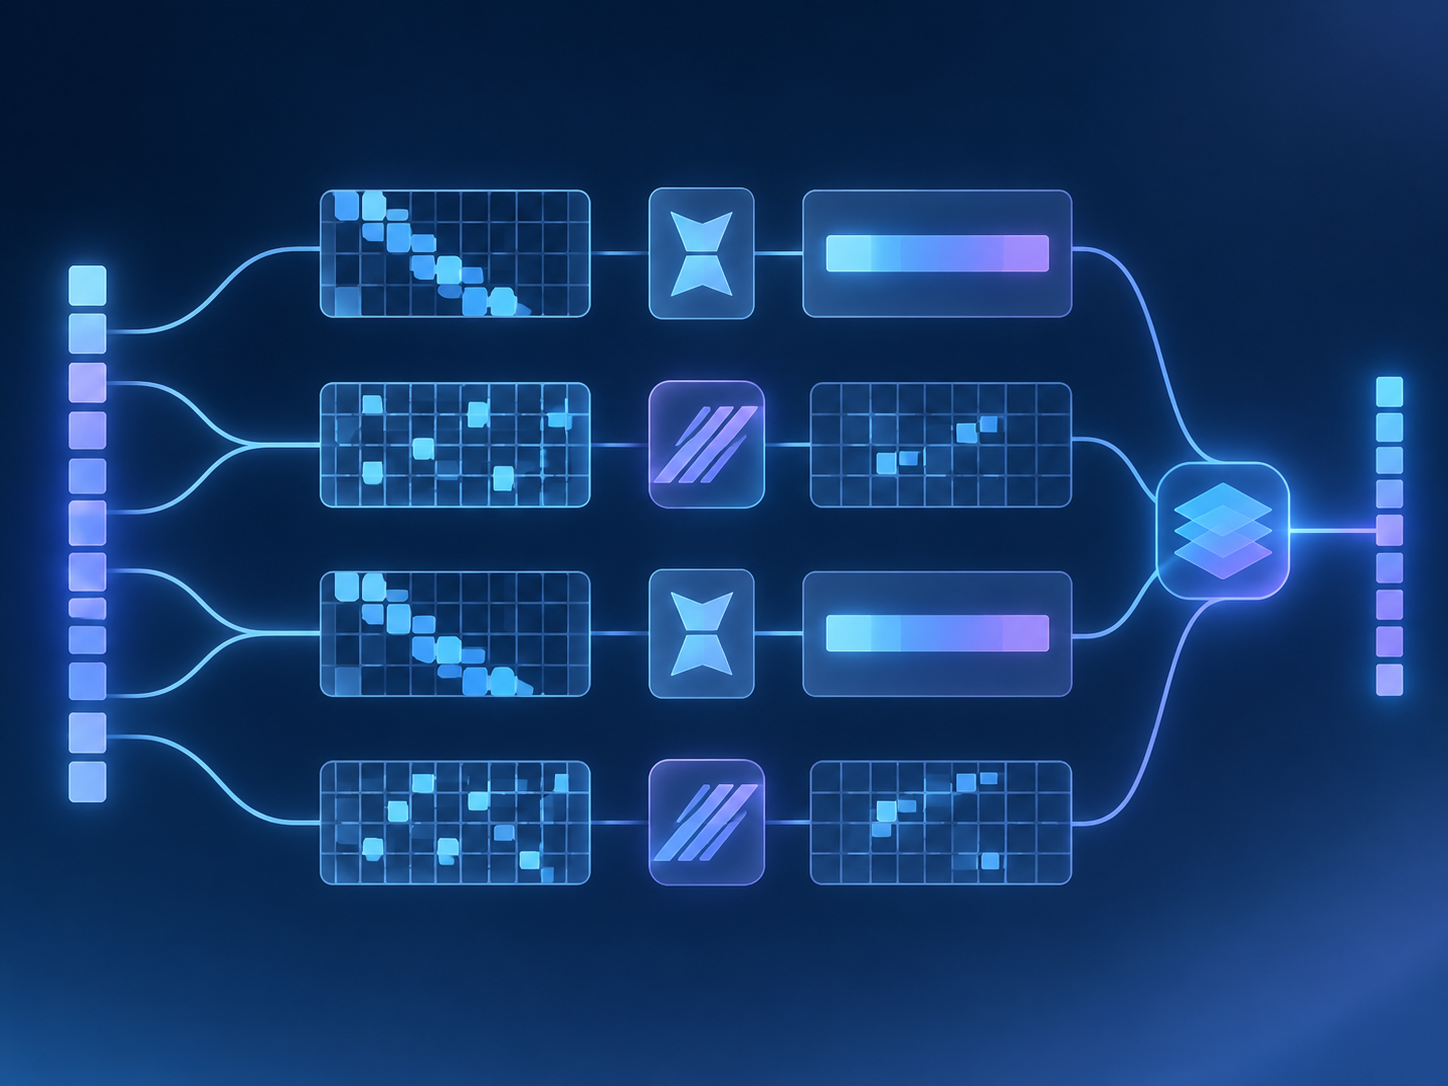
围绕长上下文成本高与信息选择难的痛点,文心引入一组互补的注意力创新:
- Latent-Gated Sparse Attention:将混合稀疏注意力与低秩门控、虚拟头机制协同设计,做到“该稀疏时稀疏、该放大时放大”。
- HCA + MLA 的分工:通过组合两类注意力,让部分层专注“压缩并保留历史关键信息”,另一部分层负责“细粒度访问特定历史位置”,提升长依赖访问效率。
- 低秩门控注意力(Low-Rank Gated Attention):用低维表示完成信息门控,门控投影权重减少约 75%,在长上下文条件下降低显存与计算占用。
- 虚拟头注意力(VHA):训练阶段增强表达力与稳定性,推理时融入算子,额外开销极小,兼顾训练质量与部署效率。
此外,面向大 head dim 的 FlashMask-4 注意力算子优化了算子级效率;这些改动从算法到内核实现形成闭环,使 1M 上下文不再只是“参数支持”,而是“可负担、可用好”的能力。
专家路由与训练机制:让“路由分数”更接近“真实效用”
- Multi-Router Latent MoE:采用多个独立路由器共同参与专家选择,缓解单一路由器偏差,使路由评分更贴近专家的实际贡献,同时不增加激活专家数量与通信开销。
- 训练目标 ECHO:无需额外 MTP(Multi-Token Prediction)模块,复用主干最后一层,让模型在预训练中学会“前瞻性续写”。同为单步训练,ECHO 在多步起草上优于常见的辅助 MTP 模块,而复用的最后一层还能充当投机解码的草稿模型,直接提升推理与代码生成吞吐与稳定性。
这意味着在不显著增加训练和推理复杂度的前提下,模型获得了更稳健的专家使用策略与更高效的解码路径,实际落地时的吞吐/成本比更具优势。
基建与生态:从算法到系统的一体化设计
- 分布式 Muon 优化器的工程化改进,提高大规模训练阶段的通信与显存利用效率。
- 算子与通信的协同优化,使长上下文与大维度注意力在集群环境中更具可扩展性。
- 作为开源基座模型,为企业与开发者提供可微调、可定制的通用底座,降低构建专业模型的门槛,便于在检索增强、代码代理、企业知识库、合规审计等场景快速迭代。
影响与展望
文心 5.5 Flash Base 体现出当前大模型演进的三条主线:稀疏化带来的有效计算、长上下文下的信息选择与压缩、以及训练目标与解码路径的协同优化。对产业而言,直接收益包括:
- 更长的“记忆”让智能体任务更稳定,跨文档推理与长期规划能力提升。
- 更高的吞吐/成本比降低推理成本,利好高并发与大规模部署。
- 开源基座降低二次开发难度,加速垂直领域模型与应用的涌现。
也需要理性看待与持续验证:
- 1M 上下文虽可用,但预训练为 128K,超出训练分布的鲁棒性及最优使用策略(如检索+上下文混合)仍需在真实业务中标定。
- “同尺寸 SOTA”强调的是同级基座模型对比,面向特定任务的指令微调与对齐后表现仍可能因数据与范式差异而显著波动。
- 超长上下文并非总是成本最优,合理的检索、摘要与结构化中间表征,仍是长期工程最佳实践。
展望下一步,三方面值得关注:
- 路由与注意力的进一步自适应化,在不同任务负载下自动分配计算与记忆;
- 以投机解码为核心的端到端推理栈优化,重点提升实测 tokens/s 与延迟稳定性;
- 从评测到生产的全链路指标统一,如“每美元有效推理 token”“长程事实一致性”等,更贴近真实价值的度量将重塑模型选择。
以“效率”为锚点的技术路线,正把通用大模型推向“更省、更稳、更长记忆”的新范式。文心 5.5 Flash Base 的开源,为社区提供了一个兼具规模、长上下文与系统化工程的基座,接下来的竞争,将更像一场围绕数据、算法与系统协同优化的“总工艺”比拼。
标签: 文心 大模型 MoE 长上下文 开源
还没有评论
发表评论