引言
当智能体从“回答问题的工具”迈向“能理解目标、调用系统并完成任务的合作者”,企业落地的关键不再是模型能否生成一段正确答案,而是能否在真实业务中稳定、低成本、可控地完成长链路任务。AI Coding 这类长上下文场景尤其敏感:一次请求可能携带百万级 token 的代码与日志,既考验推理性能,也暴露出存储、通信与调度的系统瓶颈。围绕这一痛点,昇腾 A3 平台在 AICon 北京的分享给出了一套“研究+实践”的系统性解法,直面算力利用率、KV Cache、首 Token 延迟与多卡通信的四大挑战。
长上下文放大的四道坎:问题不只在模型
AI Coding 的价值来自全局上下文理解与持续执行能力,但这恰好让推理系统暴露出以下四类瓶颈:
- 算力利用率(MFU)低:prefill 与 decode 计算形态差异大,设备时而吃满、时而空转,FLOPs 难以持续转化为吞吐。
- KV Cache 开销大:序列越长,KV 随上下文线性膨胀,显存与带宽成为硬阈值,直接限制并发与扩展性。
- 首 Token 延迟(TTFT)高:prefill 阶段长且串行,用户感知延迟被显著拉高,端到端交互体验受损。
- 多卡通信瓶颈:跨卡/跨机并行带来 all-reduce、pipeline 同步开销,若无法与计算重叠,整体速度被“细腰”卡住。
这些问题不是“优化某个算子即可解决”的单点挑战,而是贯穿模型、算子、内存、调度与集群拓扑的全链路工程课题。
Infra 侧的系统性加速:让吞吐、时延与显存三角达成平衡
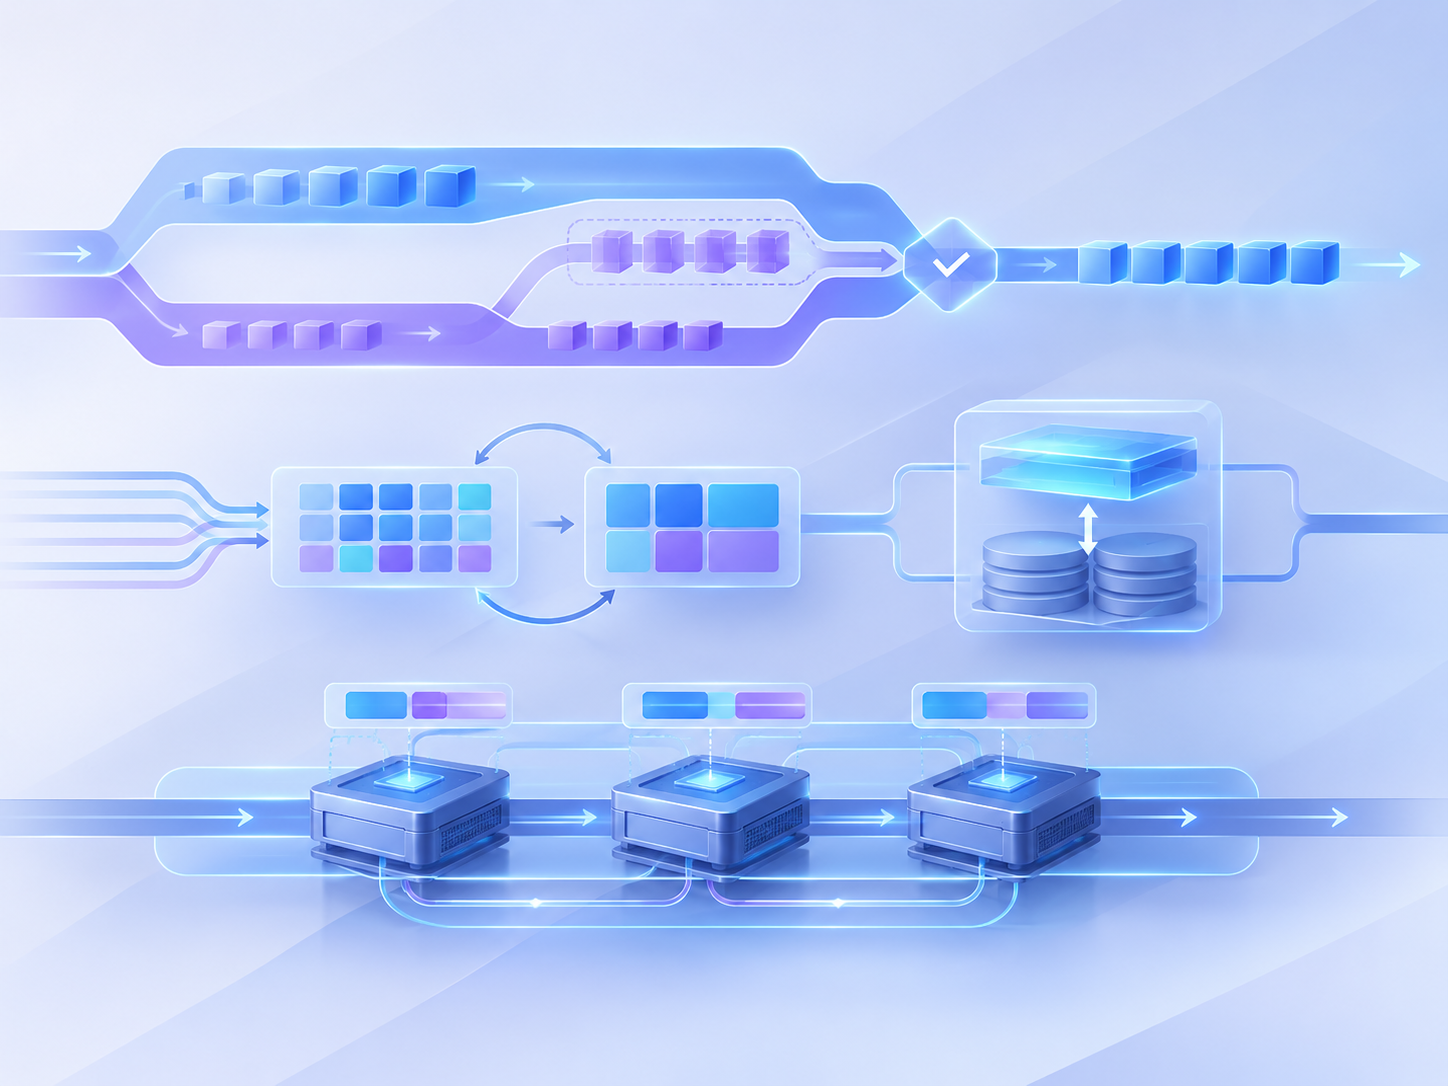
面向昇腾 A3 的推理实践,从框架与调度入手,建立了可控的性能-成本解:
- PD 分离(Prefill/Decode):将重预填与轻解码拆分独立调度,针对性优化算子布局与并行度,兼顾 TTFT 与 TPOT。
- 投机推理(Speculative Decoding):以轻量草稿模型预判 token,主模型验证通过直接提交,显著降低首个 token 的冷启动等待。
- 动态批处理:根据实时并发与序列长度调整 batch 形态,提升设备利用率,同时避免长尾请求拖慢整体。
- 分级 KV 缓存与多卡并行:将热点 KV 留在高带宽显存,冷数据下沉到更廉价存储;结合通信-计算重叠与分阶段同步,减轻跨卡瓶颈。
在这些策略的组合下,1M 长序列请求的并发从 4 提升到 10,吞吐达到 2.5 倍增长,同时维持可接受的时延曲线。这背后的要点是“面向目标的配比”:为 TTFT 留出快速通道,为高并发设计稳态批次,避免以单一指标牺牲整体体验。
算法与算子共振:TurboQuant 与 CANN 融合加速
Infra 之外,算法与算子层面的两条路径同样关键:
- 低比特量化与 KV 压缩:以 W4A8 为基础,配合 KV 3~4bit 压缩减小显存与带宽压力。TurboQuant 通过 Hadamard 旋转域量化,逼近权重的近优解,缓解低比特下的精度损失。
- 融合算子链与内存友好实现:基于 CANN/Ascend C 将算子链路融合,消除中间 buffer、减少 kernel 调度与访存往返,使得硬件峰值算力更长时间处于“有效工作状态”。
工程化落地方面,相关能力随 CANN 商业版本与 vLLM-Ascend 主版本集成,降低了生态对齐与维护成本。在 3P1D 并行架构下,TPOT 维持约 30ms、TTFT 控制在 10s 以内,业务侧吞吐提升 3 倍以上,且在精度不变的约束下实现稳定收益。这意味着长上下文服务终于可在 SLA 与成本之间找到“企业可用”的平衡点。
下一代昇腾与异构算力:为复杂 Agent 预留增长带宽
面向更复杂的 Agent 与超大规模模型,算力演进的方向清晰:
- 代际跃迁:以昇腾 950 为代表的新一代芯片在算力/带宽/内存层面同步提升,为长序列与高并发提供更高的底座上限。
- 异构算力池化:将 GPU/昇腾/CPU/NPU 统一编排,匹配不同阶段(prefill/verify/工具调用)的最优性价比设备。
- 训推一体与近存互联:缩短参数/激活/缓存的在途距离,减少跨设备、跨层级的数据搬运,进一步压缩 TTFT 与稳态延迟。
从系统视角看,这是对“让算力服务任务”的重构:以任务形态驱动算子与硬件的协同,以数据路径约束反推并行与分层策略。
影响与展望
- 对企业:推理加速不只是性能竞赛,更是成本、SLA 与合规的综合工程。稳定的 TTFT、可控的显存占用与可预测的并发扩展,是将 Agent 纳入生产流程的前提,也让验收标准与权限治理可被量化。
- 对工程团队:优化重心从“单次调用”转向“上下文、工具、执行环境与反馈回路”的整体设计。PD 分离、投机推理、动态批处理与分级 KV,提供了可复用的工程方法学。
- 对生态:TurboQuant 与融合算子在主流推理框架的落地,打通了“算法-算子-框架-硬件”的闭环,降低了长上下文服务的门槛,为更复杂的 Agent 工作流(代码理解、测试运行、自动修复)释放空间。
- 对行业方向:随着昇腾 950 与异构池化实践推进,推理与工具调用、多模态与长任务将进一步融合。可以预见,决定 Agent 能力上限的仍是模型,但能否“进厂创造价值”,最终取决于工程能否把算力转化为稳定、可负担的服务。
从这一视角回看 AICon 的技术专题,后训练、推理优化、Agent 工程与知识工程并非割裂模块,而是贯穿数据、模型与系统的统一问题:让智能体以可衡量、可治理的方式,承担真实业务中的确定性工作。这正是算力优化的意义所在,也是企业级 AI 从原型到规模化落地的必经之路。
标签: 昇腾 推理加速 长上下文 TurboQuant Agent工程
还没有评论
发表评论