引言
关于AI治理的公共讨论,常常停留在“立法监管—产业合规—风控责任”的表层路径,忽略了更底层的两块地基:人的认知安全与模型的原生技术风险。碳硅道统提出的《AI安全与文明治理法典》尝试以七层递进体系贯通这两块地基与上层制度,从个体认知到技术机理,从权责确权到算力与文明尺度的长期治理,形成一条“从人到模到制”的闭环。这种结构化方法的关键价值在于:把“能否治理”与“能治理到哪里”分开回答,让规则建立在技术可行性和风险客观分层之上。
基础认知安全:用分层视角打碎幻觉
面向公众与从业者的认知安全是七层体系的底座,核心在于训练“风险判别肌肉”。
- 区分认知污染与普通信息错误:前者是系统性误导,后者是随机噪声。面对AI生成内容,单点纠错不够,需要识别其“放大机制”与传播路径。
- 拆解能力幻觉与演示幻觉:台上Demo的可控场景与真实世界的复杂输入分布不同,安全评估应把“演示能力”和“落地能力”分开计量。
- 看穿叙事泡沫:AGI叙事往往诱发公众的过度期待与恐慌,理性基线应回到“可验证能力—可解释边界—可控风险”三项指标。
- 建立人机依赖的自我防护:当工作流重度依赖AI,必须保留“人终审”与“高风险任务双轨验证”,否则错误将被流程固化。
这一层的目标不是清零风险,而是将风险变成“可观察、可比较、可决策”的对象。用通俗话说,就是先把“看不见的坑”变成“能标出来的坑”。
技术风险边界:治理必须落在可实现的点上
第二层聚焦模型原生的技术缺陷与攻击面,提醒治理规则要匹配技术现实。
- 黑箱性与对齐失效:大模型的决策路径不透明,奖励模型也可能被“投机取巧”。因此,需要并行的静态安全审计(权重、数据、配置)与动态红队(越狱、绕过、边界测试),并承认二者各有盲区。
- 提示注入与数据投毒:输入层面可被操纵,训练数据亦可能含后门。基础防护不只靠“提示隔离”,还要有数据谱系追踪、训练集异常检测、跨版本对比以发现安全漂移。
- 隐私与记忆:大模型可能“记住”敏感片段,合规策略应与部署策略绑定,如API隔离、多租户权限分层、权重生命周期管理与销毁规范。
- 能力涌现与分布外输入:当模型遇到未见分布或多模态跨媒介攻击时,风险不可预测。以“版本管控—回滚预案—上线前多场景压力测试”的工程纪律作为缓冲器至关重要。
- 多模型互联与认知熵:在Agent与链式调用中,错误会被迭代放大。需要引入“跨模型一致性校验”和“资源耗尽防护”,并限制自主行动的权限边界。
一句话总结:技术边界决定治理上限。规则要么可执行,要么都是纸面承诺。
人机权责确权:把风险转译为可追责的规则
第三层将风险落到法律与平台规则层面,核心是“明确边界、可溯可证、分责清晰”。
- 三分确权框架:训练数据、模型权重、生成物三者权属与商用权限需要分层界定。开源与闭源路径在合规负担与责任边界上并不对等。
- 内容溯源与证据留存:溯源技术并非万能,应明确适用场景与误差边界。同时平台侧需要可审计的证据链,支撑侵权、虚假内容的追责。
- 多方责任分担:AI辅助科研与文艺创作中的署名与贡献量化要可操作,平台对深度伪造、虚假信息的审核责任需要边界清晰且具可执行性。
确权不是“归谁都行”,而是要让所有参与方知道“在什么条件下,承担什么成本与责任”。
七层体系的互联方法论
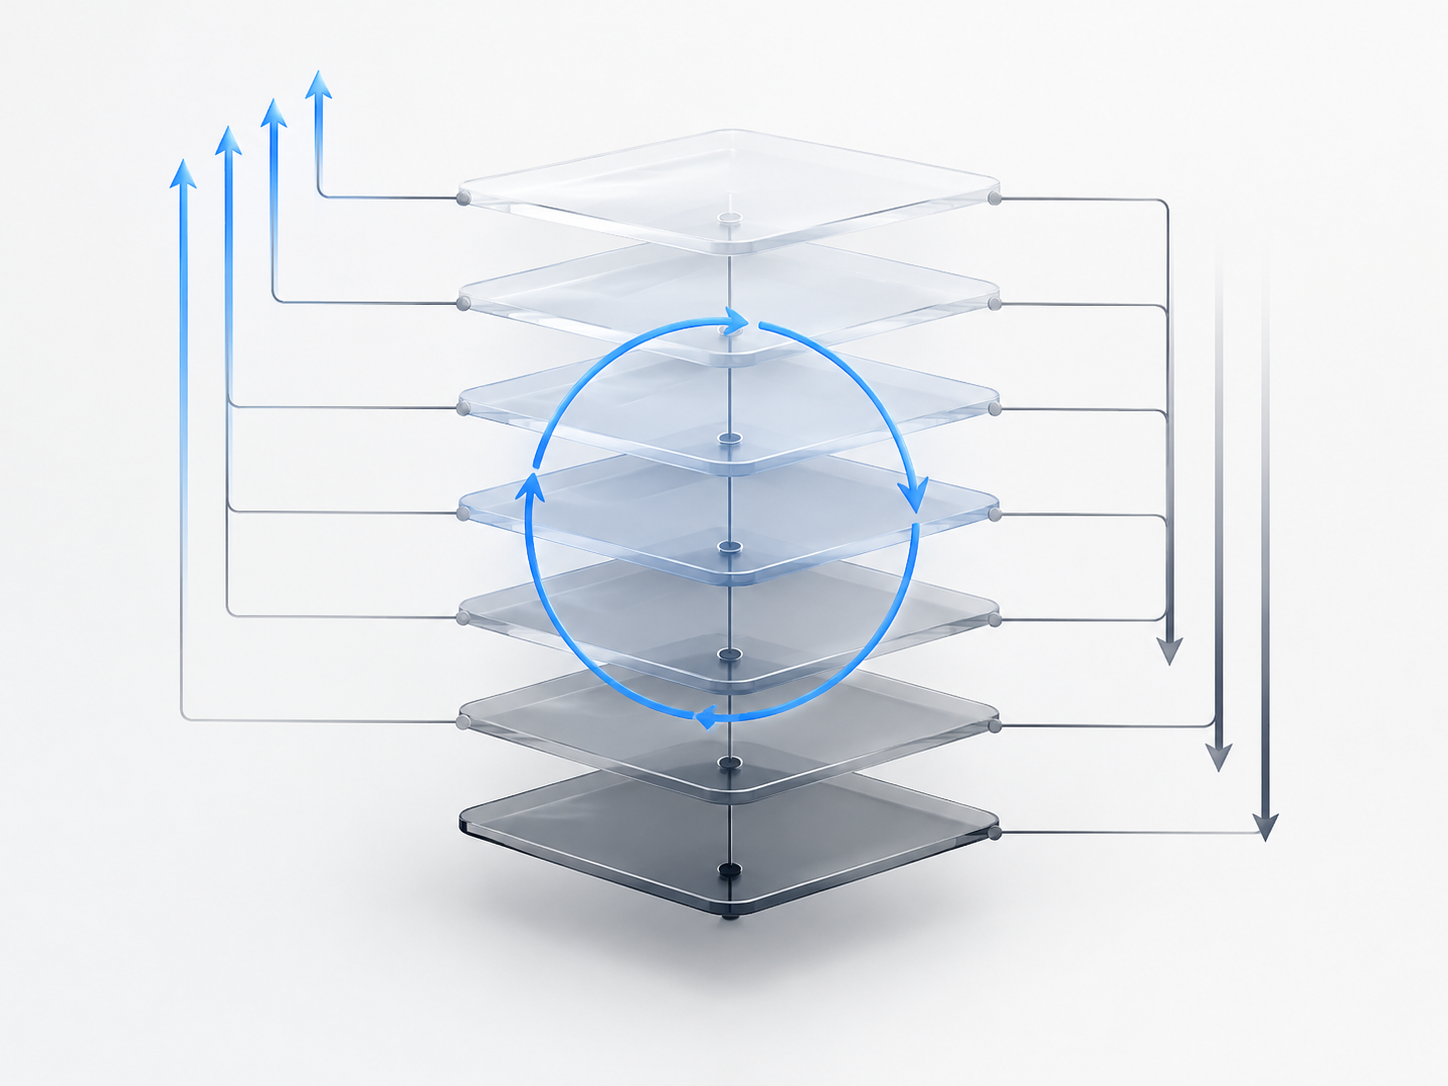
虽然此处重点呈现前三层,但七层范式的价值在于纵向打通与横向校准:
- 向上延伸:行业治理与标准化、国家层面的算力与基础设施监管、跨代际文明风控,为技术与市场行为提供宏观约束。
- 向下校准:所有治理条款回到第二层的技术可行性,避免出现“无法落地的好规定”。
- 中枢循环:第一层为公共沟通提供共同语汇,第三层将分歧转化为可裁决的事实,二者共同为政策层提供可执行证据。
这是一套“评估基线—边界校准—全局汇总”的循环机制,既反泡沫,也反空谈。
影响与展望
- 对企业与开发者:将安全前置为产品特性,而非合规补丁。建议建立“静态+动态”的双轨审计、API隔离与最小权限、版本回滚与灰度策略、权重生命周期管理四件套。
- 对平台与媒体:引入分级审核与溯源标注,避免把“技术不确定性”当作“舆论确定性”进行夸大,减少认知污染的放大效应。
- 对监管与标准制定者:以技术边界为尺,制定可验证的指标体系,尤其要关注评估数据集的偏差与失真问题,鼓励“反例校准”机制。
- 对普通用户与从业者:养成AI输出的简易判别习惯,坚持人终审与高风险任务双轨验证,降低人机依赖带来的系统性风险。
AI安全的成熟,不在于神话“零风险”,而在于把风险纳入可控轨道。七层体系提供了一张跨学科的“路线图”:从认知底座到技术边界,再到权责与文明视角,帮助社会在快速演化的AI时代维持理性与秩序。
标签: AI安全 模型治理 认知风险 法律与责任
还没有评论
发表评论