引言
要让智能体真正理解并驾驭物理世界,光看视频不够,关键在“亲手尝试—观察后果—积累经验”的闭环。AgentGarten提出的方案,将可执行代码与神经渲染实时拼接成一个练兵场:动作改变世界,世界反馈视觉,经验沉淀为策略,再进入下一轮。更重要的是,这个练兵场以超过 30 fps 的吞吐持续运行,让策略在短周期迭代中涌现与进化。
让世界“可执行”:代码造物理,扩散绘视觉
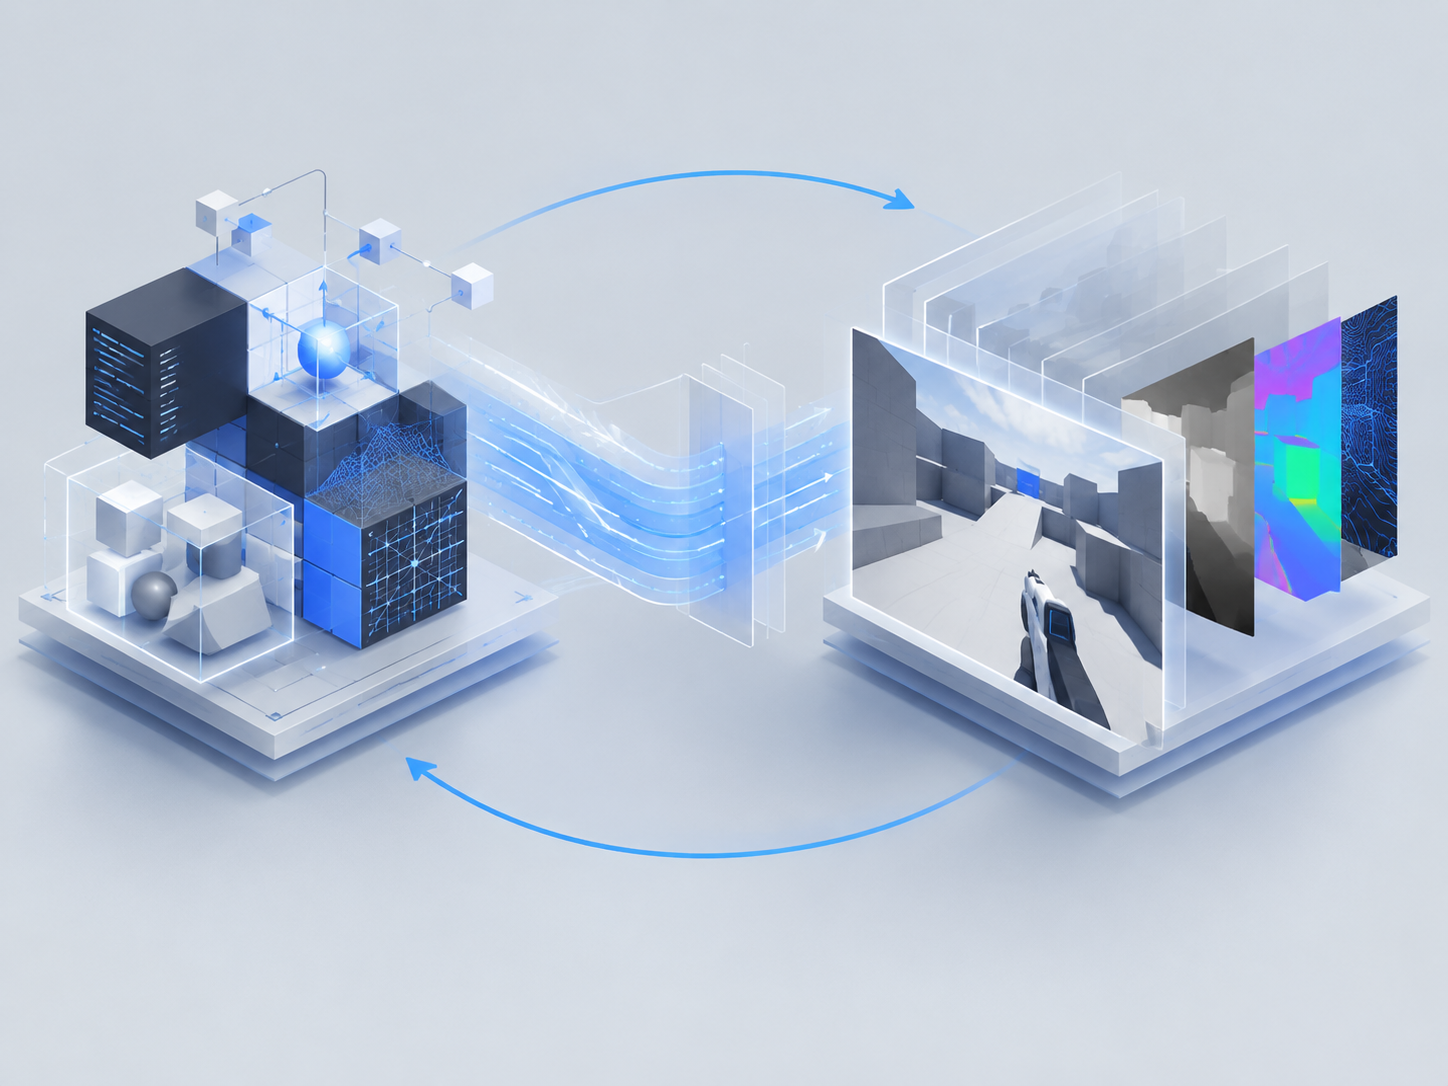
AgentGarten的核心是分工明确的双引擎:
- 物理与规则由代码裁决,保证状态可查询、可干预、可重复,不出现“幻觉物理”。
- 视觉由神经渲染器生成,依据环境导出的几何条件(如深度、法线),在毫秒级合成拟真的下一帧。
这一架构带来两项关键跃迁:
1) 可控性:碰撞、胜负、资源数量等都在显式状态里,任务制定与评测不再受黑箱束缚。
2) 扩展速度:搭建新场景只需描述几何与规则,渲染器负责“看起来怎样”,把环境构建从美术密集转为程序化扩展。同一视觉接口可服务翼装飞行、机械臂操作、导航与多车交互等多任务。
从智能体的一人称相机出发,动作触发状态更新,几何草图导出,渲染器生成画面再喂回决策模块。这条闭环把“可执行的因果”与“可感知的外观”契合在同一时间轴上。
在试炼场中涌现:自我反思与策略进化
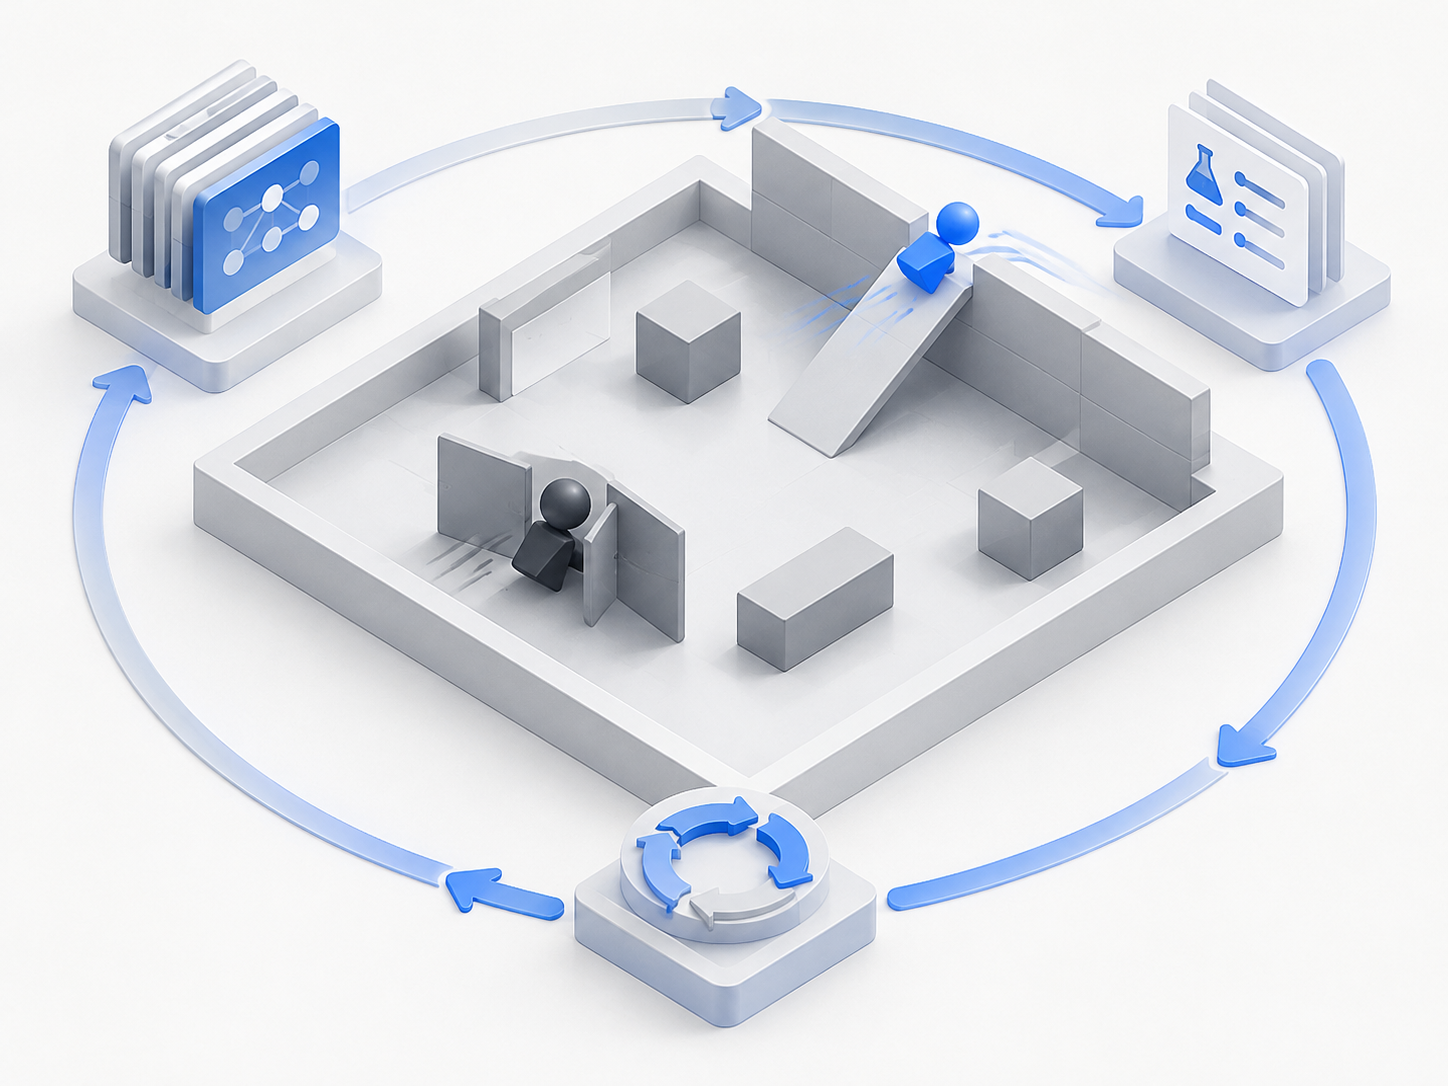
自博弈场景里,策略涌现的节奏肉眼可见:躲藏者学会搬挡板造掩体,搜寻者掌握架坡道翻墙,首跳失误后主动调整再试。这背后不是静态策略库,而是持续的“实验手册”机制:
- 每轮结束进行复盘,记录成功与失败的条件。
- 提炼可迁移的操作步骤与注意事项,标注待验证的假设。
- 下一轮带着手册进入试错,以更高效的探索密度迭代。
这相当于把元认知(反思—归纳—再计划)嵌入交互循环。相比单纯的奖励驱动,明示的记忆与假设管理加速了“从尝试到原则”的抽象过程,使策略更稳健、也更具可解释性。
为何这是一条更稳妥的通往通用智能之路
过去两条路径各有短板:游戏引擎物理精准但视觉贫乏,视频大模型画面逼真却状态隐式。AgentGarten的解法是拆分并重组:
- 用代码确保因果与评测可控,支持复杂任务裁判与细粒度查询。
- 用扩散渲染提供沉浸视觉,让感知与决策接近真实分布。
- 用高频闭环提升“经验密度”,让智能体以最短的周转时间验证假设并修正策略。
这对于开放式学习尤为关键:智能体不再被动消耗外部数据,而是在自生成的情境里持续产出“有标签的经历”(状态、动作、结果三位一体),形成可复用的经验库与课程设计。
挑战与待解问题
现实并非没有坑:
- 物理真实度:代码规则是否足够细致,能否覆盖柔性材质、流体、摩擦非线性等。
- 渲染偏差:用深度/法线条件合成的视觉会不会在复杂光照、半透明材质上产生误导。
- 长时规划:跨数百步的目标分解、信用分配与记忆检索仍是瓶颈。
- 评测与安全:多智能体博弈中的规则漏洞、奖励黑客与失控策略,需要更严密的裁判与沙箱。
把这些问题显式化正是“可执行世界”的意义所在:它允许逐项设计、逐项验证,并将改进纳入循环。
影响与展望
AgentGarten为机器人、自动驾驶与具身智能提供了一条变量可控、反馈高频的训练路径。短期看,最直接的收益是快速课程构建与多任务迁移;中期看,基于“实验手册”的元认知框架可与大语言模型结合,形成从目标描述、策略生成到失败解释的统一工作流;长期看,若能加入可微物理、跨模态传感与真实数据校准,将有望缩小仿真到现实的鸿沟,推动开放式、多智能体生态中的持续进化。
把世界变成“能写、能看、能改”的试炼场,是迈向通用智能的一次结构性推进。当智能体能在这样的场里自主设问、自主试错、自主归纳,进化不再是偶然涌现,而是被系统化地加速。
标签: 智能体进化 神经渲染 扩散模型 仿真学习 自我博弈
还没有评论
发表评论