引言
一组来自DeepSeek员工群聊的截图在AI圈掀起波澜:有人调侃“在工位玩游戏”,有人称“没刷榜,分数不小心涨了”。玩梗的背后,是一套清晰的技术与组织叙事:当底层架构与训练范式进入新阶段,能力增长可能不再依赖“刷题式优化”,而呈现出一种对友商的“降维打击”。这并非反常识,而是技术成熟度与人才密度叠加后的必然。
核心内容
“打游戏”的误读与技术底座
把“工位打游戏”当作偷懒显然是误读。对前沿大模型团队而言,节律的张弛与工程的强度并不矛盾。更关键的是,成绩为何“控制不住地涨”。
- 更贴近真实任务的评测:DeepSWE之类基准不只是代码补全,而是面向真实仓库的缺陷定位、上下文理解和可运行补丁。这类任务对“代理式”能力、环境交互与工具调用提出更高要求,能客观反映系统性进步。
- 架构与训练范式的协同:MoE(混合专家)通过稀疏激活在固定算力下提升有效容量;更好的 gating 与并行策略,配合MLA(对注意力的结构优化)降低时空开销,释放推理与上下文理解的上限。
- 从“微调”迈向“自博弈”:强化学习(RL)与自我改错(self-correction)正在成为代码与推理能力的放大器。当数据引擎、验证环(tests/CI)和自动化评估完善后,模型能在更少人工标注下形成可迁移的策略。
- 推理时策略优化:多步计划、工具调用、候选采样与验证循环(如执行-检查-修复),让模型在评测上获得结构性收益,而非单点技巧。
当这些要素形成闭环,“刷榜”的边际价值下降,通用能力的整体跃升自然会在更广泛的任务上体现出来。
精英密度与组织范式
外界调侃DeepSeek“偏爱奥赛金牌”,折射的其实是“精英浓度”与组织机制的匹配。此类团队的特点是:
- 极强的数学与系统直觉,缩短从论文洞察到工程实现的路径;
- 扁平管理、低流程负担,迭代周期以小时计,而非以周计;
- 高信任工作制,给与个人在算法、系统和数据上的大空间。
这带来超线性的协作效应:顶尖人才在同一代码库中相互校正,快速聚焦有效创新点;而不是把精力耗散在冗长汇报或跨部门对齐上。当然,代价也存在——对知识沉淀、工程规范、可复用性提出更高要求,否则“天才堆栈”难以复制。
“没刷榜”的方法论
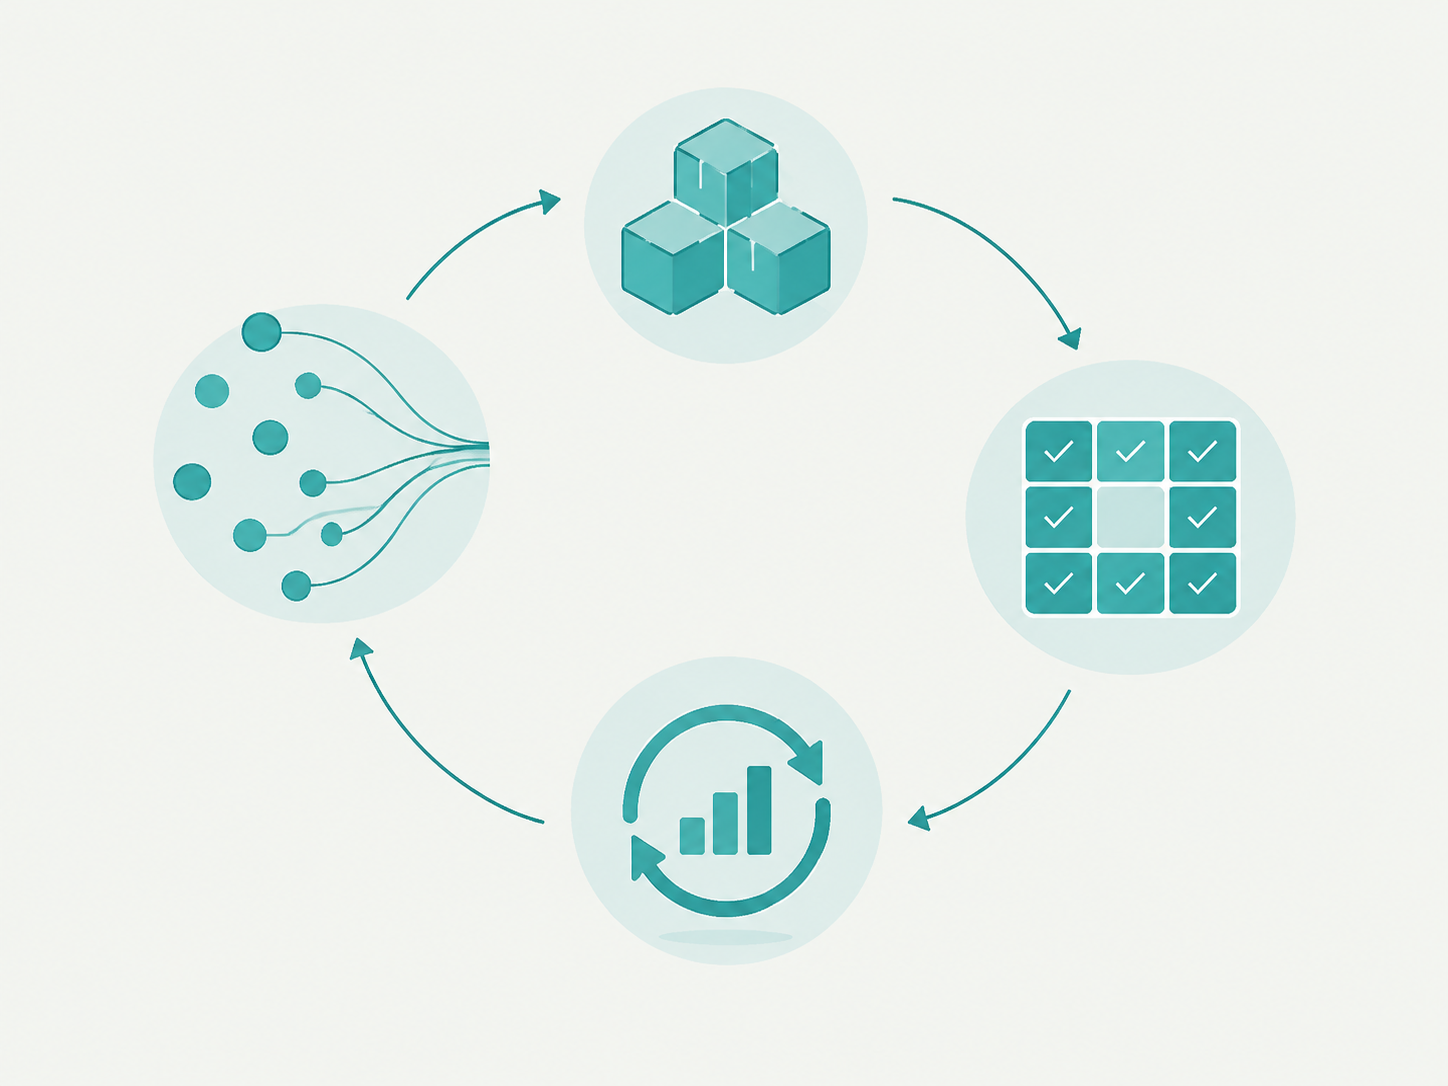
“没刷榜”并不意味着对评测漠视,而是方法论的转变:不以某个榜单为导向做投喂式训练,而是构建更强的“数据—训练—评估—反馈”系统。
- 数据引擎:强调真实任务分布、去偏与难例挖掘,降低数据污染对评测的干扰;
- 训练策略:从RLHF到RLAIF、从监督微调到混合目标,控制“奖励黑客”与虚假进步;
- 评估体系:多维度、覆盖真实世界长尾,用外部环境执行、单元测试和工具链验证结果;
- 系统工程:稳定的专家并行与张量/流水并行组合、推理服务弹性扩缩,确保能力转化为可用性。
这套方法不是“反榜单”,而是“超越榜单”——当基础能力“厚”到一定程度,分数自然随之上涨。
友商的窒息与分化
把视角转向国内其他头部团队,压力感显而易见。智谱(GLM)正加速从政企本地化转向云端API,收入结构逼迫其在稳定性、合规性、SLA与生态兼容上投入更大工程资源;月之暗面(Kimi)在长文本上完成用户心智后,缩减营销、回撤资源至基础模型与推理效率(如K2系列),力图用底层突破支撑产品差异化。
两类路径因此分化:
- 基础研究-架构驱动:以算法与系统为核心的“厚平台”,阶段性看似“松弛”,实则把难题前置到训练范式与系统设计上。
- 商业化-产品驱动:以稳定交付、行业落地与生态为核心,流程更重、节奏更稳,短期“分”可能不极致,但可持续性强。
“降维打击”在很大程度上来自目标函数的不同:一家追求全球最优的能力前沿,另一家追求大规模可用的商业最优。长期看,这两条路径并非零和,甚至会在芯片适配、推理优化、数据治理与评测规范上形成共振。
影响与展望
- 技术走向:MoE将继续普及,重点转向专家路由稳定性、跨层共享与推理效率;RL与自我改错回归中心舞台,评测将更多引入执行验证、防污染与长期任务链条。
- 组织与人才:高精英密度确实能在前沿突破期带来“智力压制”,但工程化与知识沉淀决定了后续的可复制性。如何在“快迭代”与“强治理”间取得平衡,是下一阶段的胜负手。
- 产业生态:榜单将回归“参考系”,真正的比拼转向系统工程与全栈能力。更严苛的开源基准、难例集与Agent型评测会涌现,减少“策略投机”的空间。
- 风险与边界:“打游戏”的梗不应被误读为反专业主义。对齐、安全、合规与能源成本将成为能力扩张的硬约束,尤其在企业与公共部门应用中。
- 中国大模型的窗口:在算力约束下,若能持续以算法与系统效率弥补资源差距,国内团队有机会在“性价比-能力曲线”上形成全球竞争力。接下来比拼的不仅是谁跑得更快,更是谁能把“快”固化为平台与生态。
所谓“降维打击”,终究不是戏谑,而是体系化能力的外显。当技术底座与组织范式相互强化,能力曲线自然上扬;而当友商完成路径校正,下一轮竞争又会回到同一起跑线。真正可持续的优势,仍然是底层创新与系统工程的复利。
标签: DeepSeek 大模型 MoE 强化学习 中国AI
还没有评论
发表评论