引言
超长文档正成为AI应用的新常态:成套研报、审计底稿、长篇法规与整本书籍的机器可读化需求不断攀升。传统OCR在多页拼接与跨页语义保持上捉襟见肘,模型在长度上的“天花板”也长期存在。文心 Unlimited OCR 2 的开源发布,把这一上限从“数十页”推向“任意页数”,在精度与效率上同时达成最先进水平,为文档解析迈入“OCR 3.0时代”给出了一份具有里程碑意义的答案。
核心内容
1) “页数自由”的技术支点:SR-SWA 与无限解码
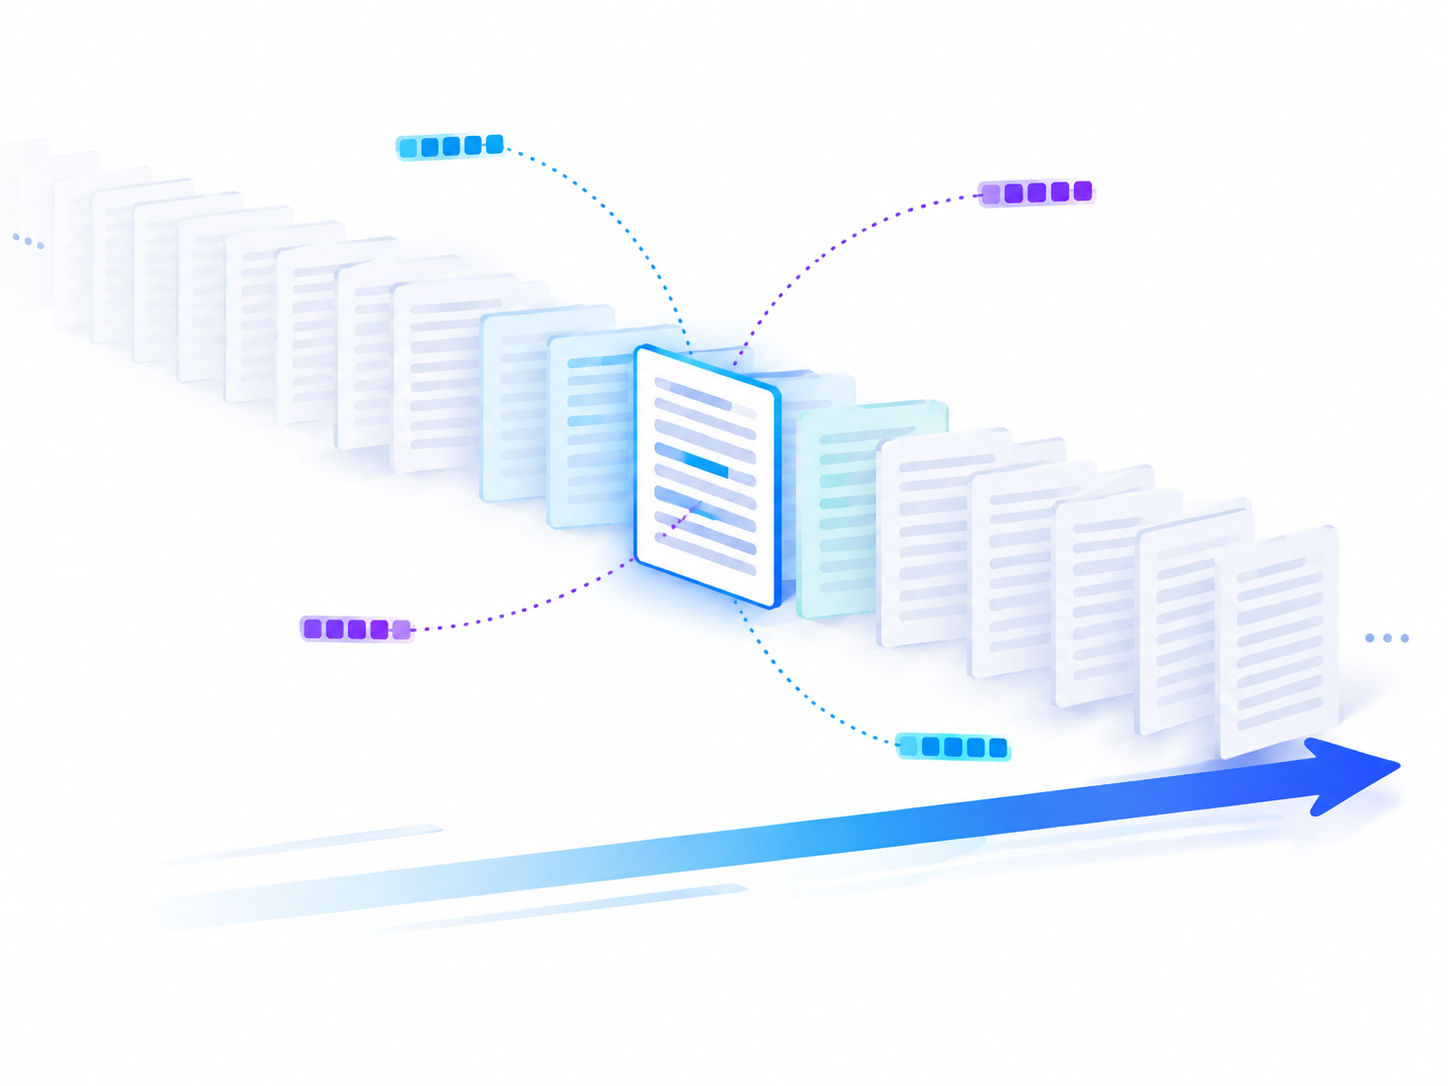
文心 Unlimited OCR 2 的关键在于稀疏参考滑动窗口注意力(SR-SWA)。它借鉴人类抄录书籍的策略:专注当前页,必要时参考前后页,而非全书反复通读。具体设计体现为:
- 页面门控(Page Gate):把每个查询的视觉参考范围从整本文档收缩到相关页,同时显式建模跨页位置关系,减少无关计算。
- Token Buckets:从全局筛选得分最高的视觉Token桶,捕捉少量但重要的长距离依赖,使“跨页引用”成为可控且高效的稀疏操作。
- Unlimited-Horizon Decoding:在解码层面做“无限”流式展开,进一步降低超长文档下的计算与显存压力,避免传统全注意力的平方级爆炸。
在百页场景中,SR-SWA单步解码速度相比 Full Attention 提升约7倍,相比上一代 R-SWA 提升约5.6倍。这意味着,长度不再以线性乃至二次方的惩罚吞噬性能,工程上的可用性显著提高。
2) 实证与基准:从“能解长文”到“解得更准”
据公开评测,Unlimited OCR 2 在面向多页文档解析的 MPDocBench 上取得84.6分,在百页级超长文档的 MarathonDocBench 上取得77.1分,端到端性能达到SOTA,显著领先多款主流模型。更具说服力的是长文极限实验:一次性解析《哈利·波特》全系列7部、合计3600余页,仍保持较高精度与实用效率。
应当看到,这类基准不仅考察字符识别,还评估版面、段落、表格与跨页关系的整体还原能力,属于“结构化理解”的系统考题。Unlimited OCR 2 的领先,反映的是在跨页语义一致性、长距离依赖与整体恢复质量上的综合优势。
3) 从1.0到3.0:范式演进与新工作流
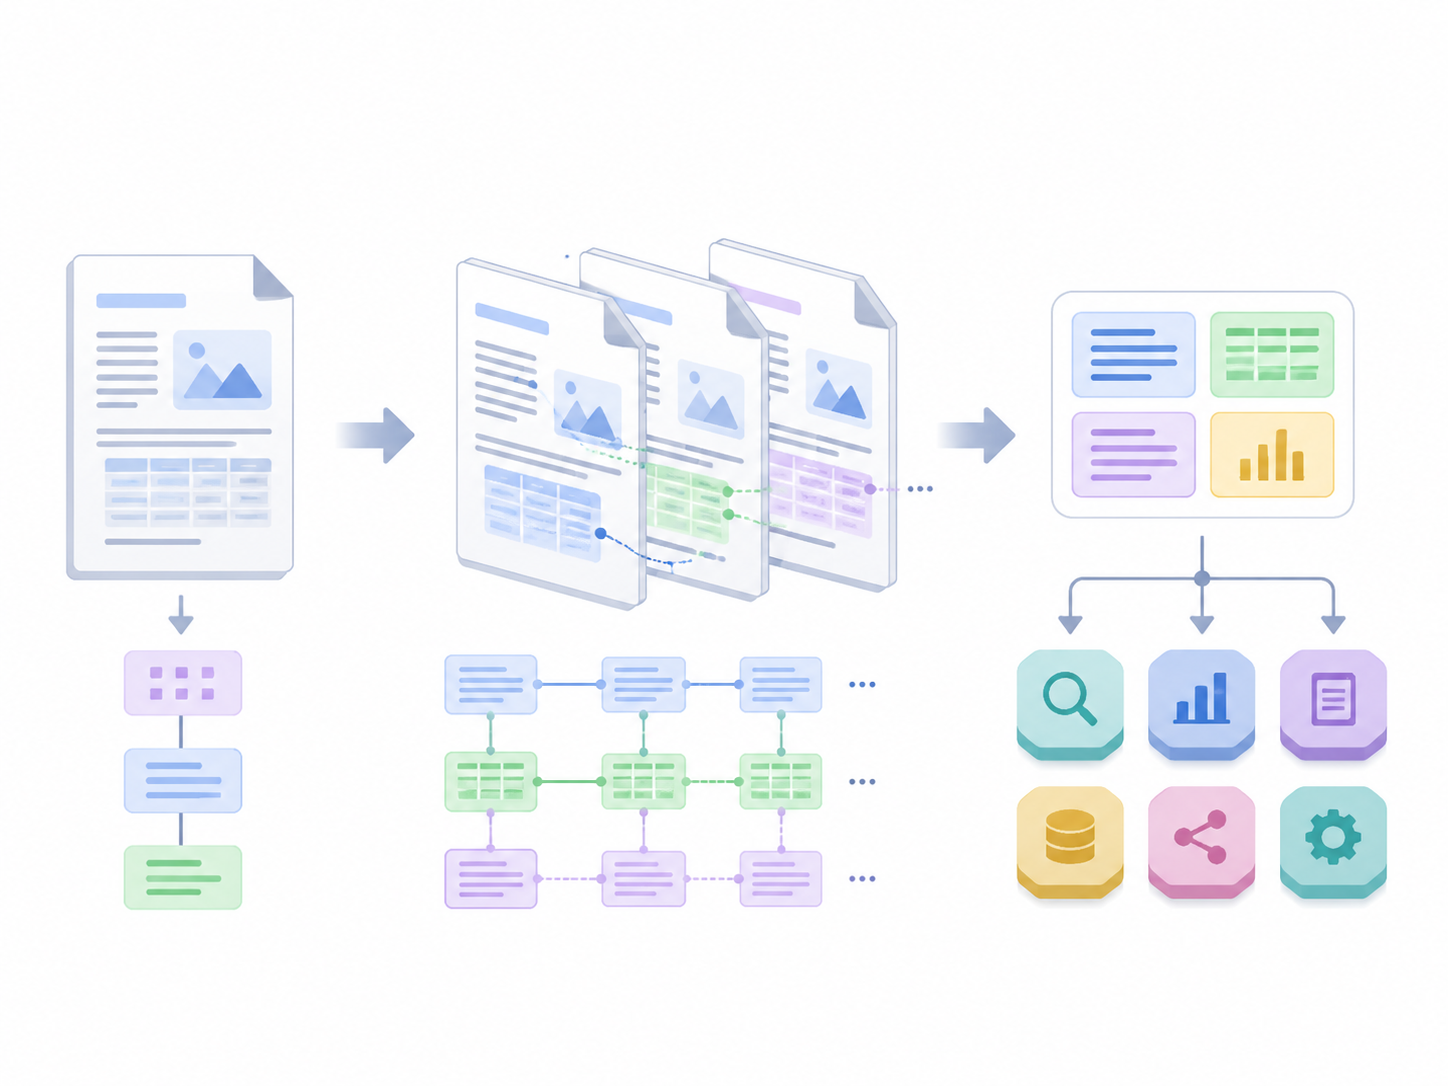
OCR 1.0时代强调单页识别与拼接,跨页一致性更多依赖后处理;Unlimited OCR 第一代以参考滑动窗口将范围拉至数十页;如今的第二代,通过SR-SWA与无限解码机制,把“连续长文”的处理从工程权衡变为默认能力。由此催生新的工作流:
- 跨页实体与表格追踪:如财报中跨页表格、附注与索引的自动联动。
- 长篇法规与合同核对:条款引用、跨页编号、版本差异的结构化比对。
- 学术与出版数字化:章节级引用、目录—正文—附录的语义连贯重建。
更重要的是,这套能力与多模态大模型、检索增强(RAG)等技术叠加,可形成端到端的“文档智能体”:先以OCR 3.0获得高保真结构化输入,再进行问答、摘要、对齐与审阅,减少“垃圾进垃圾出”的链路风险。
影响与展望
Unlimited OCR 2 的开放,给企业与开发者带来三方面直接影响。其一,成本结构改善:在同等硬件下处理更长的文档集合,单位页成本与延迟下降。其二,产品形态升级:从“单页识别器”走向“长文理解器”,复杂场景(多附件、跨页表格、长段落引用)成为可设计的默认用例。其三,生态扩展:开源模型与权重释放,降低二次开发门槛,加速行业形成共识接口与数据格式。
仍需理性认识“无限”的边界。任意页数不等于不受资源约束,极端场景下仍要通过策略控制,如:
- 动态稀疏与优先级调度:让关键页与关键块获得更高注意力预算。
- 错误传播与回溯:长链路中早期误识的纠偏机制需与解码器协同设计。
- 版式与脚本多样性:手写、竖排、低清扫描、公式与表格混排仍是挑战,需要更强的多域适配与数据增强。
- 隐私与合规:长文多含敏感信息,端侧或私有化部署、可控追踪与水印防护不可或缺。
展望未来,SR-SWA 这类“人类抄录启发”的稀疏注意力仍有提升空间:更细粒度的跨页位置编码、更智能的Token选择器、与检索索引的联合优化、以及页级/段级缓存复用,都可能进一步压缩长文成本。随着OCR与大模型的深度耦合,文档解析将从“识别文本”升级为“理解文档”,OCR 3.0 的真正价值,也将在真实业务的自动化与智能化中加速释放。
标签: OCR 文档解析 大模型 开源 SR-SWA
还没有评论
发表评论