引言
2026 年,RSI(Recursive Self-Improvement,递归自我改进)成了模型厂商的“内功心法”。融资路演里,“Self-Training”四个字几乎是估值的加速器;工程现场里,日均数百万个临时沙盒被拉起、销毁、再拉起,去验证下一轮系统改动是否有效。热度之下,行业也在冷静对齐一把标尺:真正的 RSI,不只是“AI 改进 AI”,更关键是把改进经验固化成资产,让学习方法本身迭代。这意味着从 L1 到 L5 的层级跳跃,远不止堆算力那么简单。
现实却有些扎心。全球范围看,多数系统仍停在 L1-L2 的过渡带,L3、L4 在软件工程、科学发现等垂直领域才露出苗头,L5 的“AI 自发明下一代 AI”还仅限于极少数受限原型。在国内,大家也都在改“造 AI 的机器”——训练流程、推理系统、GPU 算子、Agent 脚手架——但几乎没有团队敢放开手脚直接让 AI 改写底层模型权重。为什么?值不值?能走多远?这些问题,正在决定国产 RSI 的路线与边界。
RSI 的等级与“真实水位”
要理解当前进展,先要理解 RSI 的分层逻辑。可以粗略概括为:
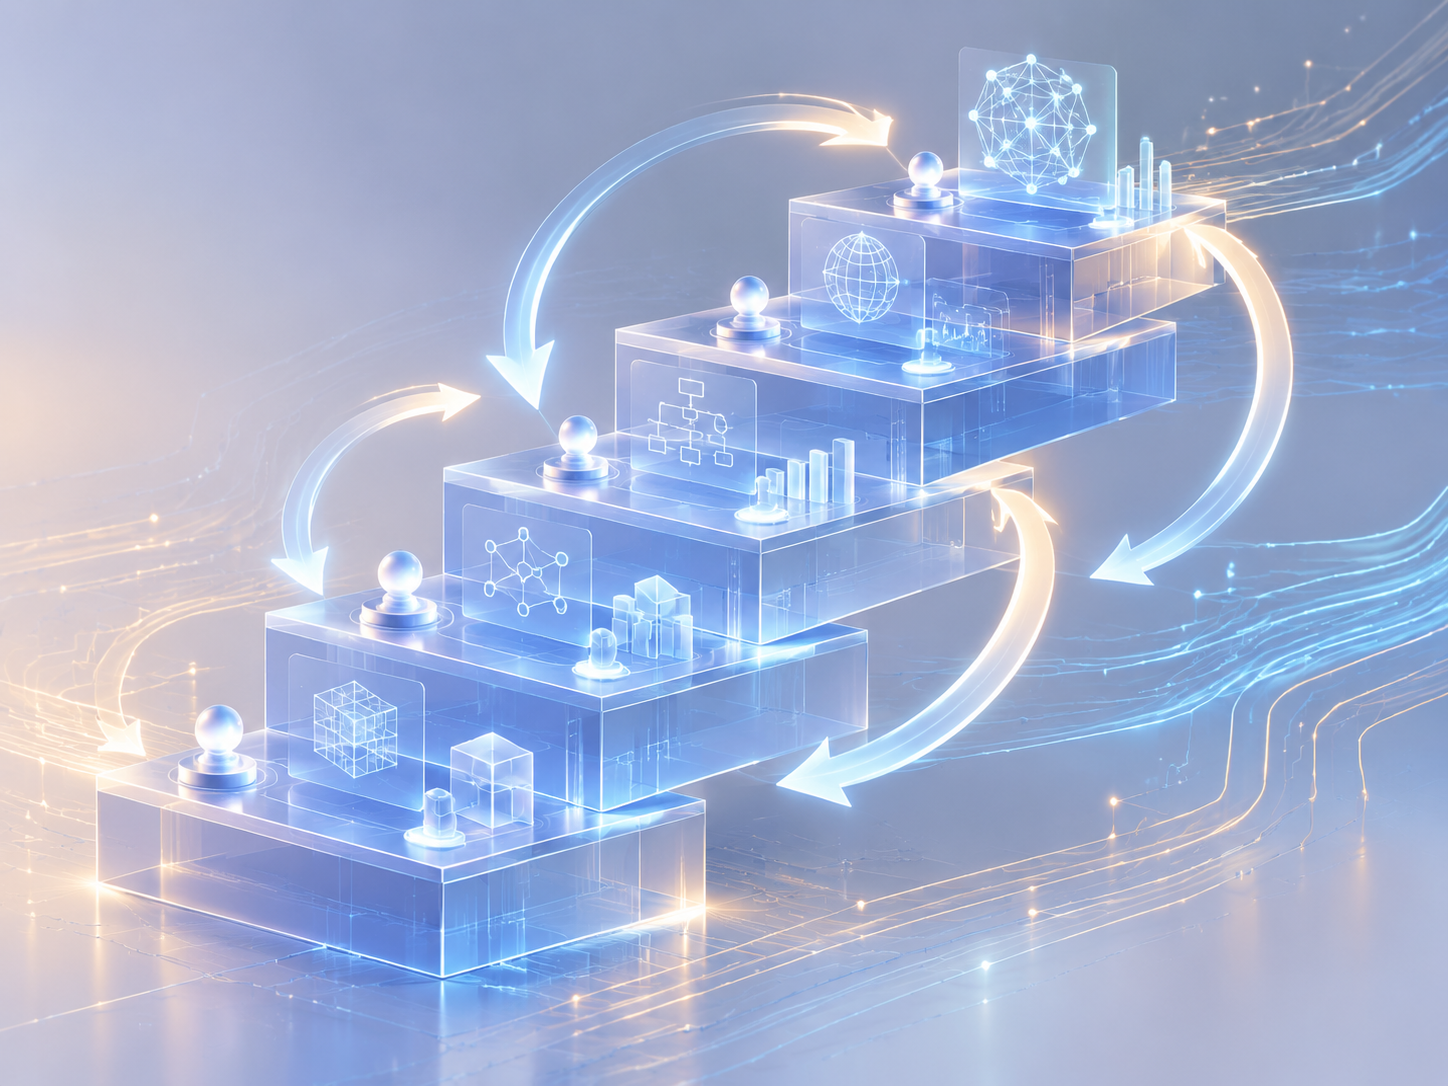
- L1:自动化数据处理与评测,流水线更高效,但学习方法不变。
- L2:组件级闭环优化,能自发定位瓶颈、试验改动、回收经验。
- L3:在特定垂直领域实现任务级闭环,目标函数更复杂,回路更稳。
- L4:跨域迁移与方法学演化,开始“改方法而非仅改参数”。
- L5:全栈闭环,AI 能在约束内自设计、验证并部署下一代 AI。
用这把尺子去量国内厂商近两月晒出的 RSI 成果,主战场集中在 L1-L2:把推理、算子、调度、Harness 等系统化为可被 Agent 操作的对象,搭建稳定的评测面板和回滚机制;在部分垂直方向出现 L3/L4 的雏形,比如大规模代码代理、科学计算流程的自动化设计。至于 L5,仍是“看看论文”的阶段。
一个行业共识
短期里,最值得投入的不是“敢不敢让 AI 改权重”,而是“能不能让改动闭环起来”。闭环不等于聪明,闭环意味着可控、可复用、可积累。它把一次性的技巧变成系统资产库,把工程的偶然收获变成可重复的产能。
智谱的样本:先造“机器”,再让机器造 AI
国内跑得最实的案例来自智谱:选择从“最脏最累”的推理系统切入口,再延展到 Agent Harness,两个方向分别指向降本与增效。
推理系统:10 万张国产卡,两周自举生产级服务
- 由 GLM-5.3 驱动的 Infra Agent 接管推理基础设施,从算力编排、任务切片到缓存与中间态管理,端到端自动化。
- 在 10 万张国产芯片集群上,两周从零自举出 GLM-5.3-Flash 的生产级推理服务,在线扛量。
- 关键指标:端到端吞吐提升至基线的 3.2 倍;硬件利用率与单 Token 成本追平主流英伟达 GPU;匿名上线后 6 天累计处理超 62 万亿 Token。
- 经验沉淀:将有效的优化方案抽象为“优化骨架”存入资产库,二次遇到相似瓶颈可直接复用,形成最小闭环——“模型优化系统,系统服务模型”。
这是一种极具“工程含金量”的 RSI:以真实线上流量做裁判,以产能与成本作为目标函数,AI 负责提出改动、压测、回滚与归档,最大限度降低试错成本。
HarnessPro:不碰答案的“帕累托自改进”
Harness 是大模型外侧的调度框架,掌管提示词、工具调用、算力预算与任务路由。传统上,这是一张高维超参网,只能靠工程师“捏”。HarnessPro 的设计要点在于三点:
- 零答案接触:避免“偷看标准答案”导致的评测作弊。
- 多 Agent 分工:诊断 Agent 找瓶颈,生成 Agent 合成压力用例,规划与实现 Agent 在性能/成本不同导向下改框架代码。
- 双目标优化:同时优化准确率与执行成本,按帕累托前沿选择改动。
结果显示,在不触碰标准答案的前提下,高难代码任务的通过率反而提升,单任务成本削减 53%。这恰好印证了那句广为流传的判断:驱动循环的不是智能,是闭环本身。只要有可改进的对象、可信的裁判和可维持的反馈回路,系统就会被稳步逼近最优。
为什么没人敢动“权重”?
在技术叙事之外,权重级 RSI 的迟疑有其深层原因:
- 安全与治理:自改权重存在“奖励投机”“梯度黑客”等风险,一旦在生产环境放飞,事故不可逆、责任不清晰。
- 评测不完备:权重变化影响分布外行为,现有基准往往覆盖不足,缺少能约束泛化与对齐的强裁判。
- 可追溯与可回滚:系统级指标(吞吐、延迟、成本)可即时量化且易回滚;权重变更的因果归因与灰度策略更难。
- 数据与合规:自生成样本可能污染训练分布,触发版权或隐私风险;审核成本上升。
- 经济性:与其豪赌难以解释的权重改写,不如先榨干“系统红利”,单 Token 成本与可用性改善立竿见影。
这也是行业当下的理性选择:把最能形成闭环、收益可量化的层面先打穿,然后再为权重级自改进铺设防火墙、检验台与回滚跑道。
“一天造 300 万个沙盒”的意义
在 RSI 的工程化阶段,“沙盒”成了新型要素生产工具。它不只是测试环境,更是高频验证、低成本探索的调度单位:
- 规模化对照实验:并行启动海量短生命周期环境,快速 A/B 不同算子、编译选项、量化策略与路由策略。
- 自合成压力与故障:由 Agent 生成对抗场景与边界用例,验证鲁棒性与退化行为。
- 可控发布与回滚:小流量金丝雀发布,异常自动熔断,变更与指标闭环入库。
对应到栈内的“可改对象”,今天国内团队重点在四类:
- 训练流程:数据清洗/合成、采样策略、配方搜索与小步迭代。
- 推理系统:批处理/并行/缓存、KV 管理、调度与编排。
- GPU/加速算子:自动算子调优、编译搜索、内存与通信规划。
- Agent 脚手架:工具接入、提示与路由、成本-性能权衡。
它们的共同点是:指标可量化、评判可自动化、知识可资产化。这正是 RSI 从“炫技”走向“产能”的门槛。
影响与展望
短期影响会非常直接:谁先把系统级 RSI 打出稳定闭环,谁就能用更少的成本提供更快、更稳、更“懂业务”的模型服务,形成“成本-性能—迭代速度”的三连增益。由此衍生的资产库(优化骨架、评测用例、调度策略)会形成强粘性的技术壁垒。
中期看,L3-L4 会在高价值垂直领域加速落地:代码代理、数据工程、科学计算与工业仿真,都是目标函数清晰、沙盒可控、收益可即时结算的黄金赛道。围绕它们的评测与治理体系,将决定能否安全地迈向“有限权重自修改”,比如让 AI 在强评测护栏下提出“微小权重补丁”,通过可解释性与金丝雀流程逐步合入。
至于 L5,真正的前提不只在模型本体,还在系统治理:需要更强的评测覆盖、更可靠的因果归因、更完善的溯源与合规,以及更低成本、更高规模的沙盒与算力基座。换句话说,L5 是系统工程成熟度的产物,而非一次灵光乍现。
判断未来一年国内 RSI 进展,有三个值得盯的里程碑:
- 线上可解释的“微改权重”安全通道出现,并在小范围稳定服役。
- 自生成评测的覆盖率与事故捕获率,持续优于人工基准。
- 成本侧指标(每 Token 成本、每成功任务成本、回滚半衰期)在同等质量下显著领先。
当这些信号同时出现,“AI 造 AI”的故事才会从概念走向范式迁移。
标签: RSI 自我改进 推理系统 Agent 国产大模型
还没有评论
发表评论