引言
同一个问题,只是多敲了几个空格,答案却从满分跳到离谱。这不是玄学,而是长上下文“省钱术”的副作用被放大。近期有研究点名 DeepSeek V4 系列在启用分块 KV-Cache 压缩时出现“周期性弱点”:当关键信息恰好落在压缩块的某些相位,模型表现如“天才”;换个相位,则像“断片”。在强调“把长文本成本打下来”的时代,这类隐蔽失真成了可靠性的新盲区。
核心内容
省钱之术如何变成“相位陷阱”
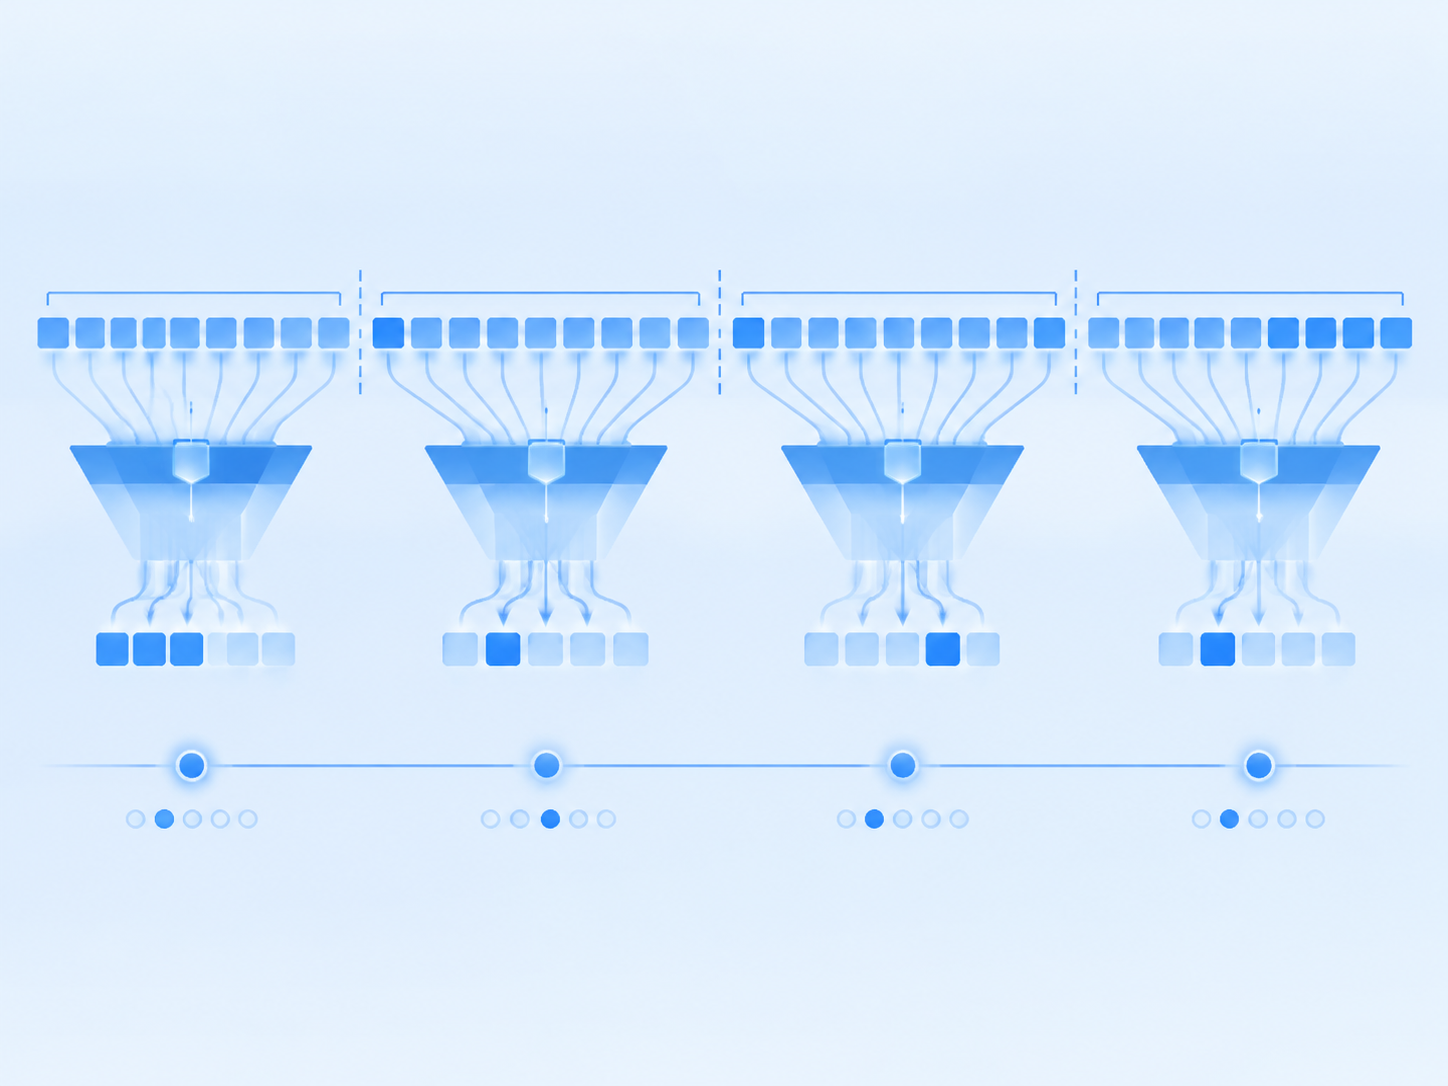
长上下文最大瓶颈是显存与带宽。分块 KV-Cache 压缩的思路,是把连续 Token 按固定步长切成段,再用可学习的门控将段内信息“提炼成摘要”,以此降低缓存规模与读写成本。
问题在于:标准 Transformer 的注意力主要依赖相对位置,不需要让“放在第几位”本身成为关键信号;而分块压缩后,段内的相对位置被门控函数赋予不同“槽位增益”,某些相位的 Token 更容易被保留,另一些则更容易被忽略。于是,“位置决定命运”——这就是相位敏感性。进一步分析还发现,注意力头会对不同相位形成“专业化”,让少数薄弱相位成为系统性短板,一旦关键信息落在这里,就可能被两轮压缩连续稀释甚至丢失。
简单地说:为了省显存引入了离散的相位结构;相位一旦固定,模型输出对轻微格式扰动(空格、换行、注释)会呈现周期性的强弱波动。
实证:从“等号干扰”到长文“大海捞针”
研究者先用代码补全做了一个极简测试:补全 FP8 量化函数的最后一个 token,正确答案应为 8。但仅仅在代码开头加一串装饰性的“=”符号,输出竟变成了 32。更诡异的是,错误并非随机,而与等号数量除以 4 的余数周期对应:
- 余数为 0 或 1:大概率答错,错误率最高达 71.3%
- 余数为 2 或 3:大概率答对,正确率可到 91.5%
随后是更贴近业务的检验:构造 128K 长上下文,埋入约 1.6 万个键值对,保持语义和长度不变,仅改变目标键值对在序列中的位置。结果显示:
- DeepSeek-V4-Flash-Base 不同位置间准确率差距高达 40.2%
- 换成 DeepSeek-V4-Pro-Base 差距为 34.8%
- 经过后训练优化,差距仍有 19.1% 与 14.8%,并未根除
针对周期性盲区,DeepSeek 在 V4.1-Flash 中尝试把压缩步长从 4 降到 2,等于细化相位种类并减少边界丢失。效果确有改善,位置间差距降至 6.1%,但问题并未完全消失。可见,这不是“打补丁”即可一劳永逸的工程问题,而是压缩范式自身的结构性副作用。
这不是提示工程能救的“玄学”
许多用户直觉会往提示工程上想:是不是再加点说明、再换个模板就能稳定?遗憾的是,此类误差触发常常来自与语义无关的小格式扰动——空格、分隔符、注释对齐、换行位置——它们改变的是相位落点,而非语义信息。提示写得再优雅,也挡不住“掉在盲点槽位”。
更务实的使用建议包括:
- 保持格式稳定:同类任务尽量使用一致的模板与标点,减少无意位移
- 关键任务双轨运行:在可选的情况下启用“稳健模式”(更小步长或关闭压缩),或以不同相位偏移重跑一次比对
- 检查长文关键条款:合同、合规、风控等场景,确保关键信息不被格式噪声埋没,可辅以检索式定位与二次核验
工程与研究层面的缓解思路
短期可行的工程方案:
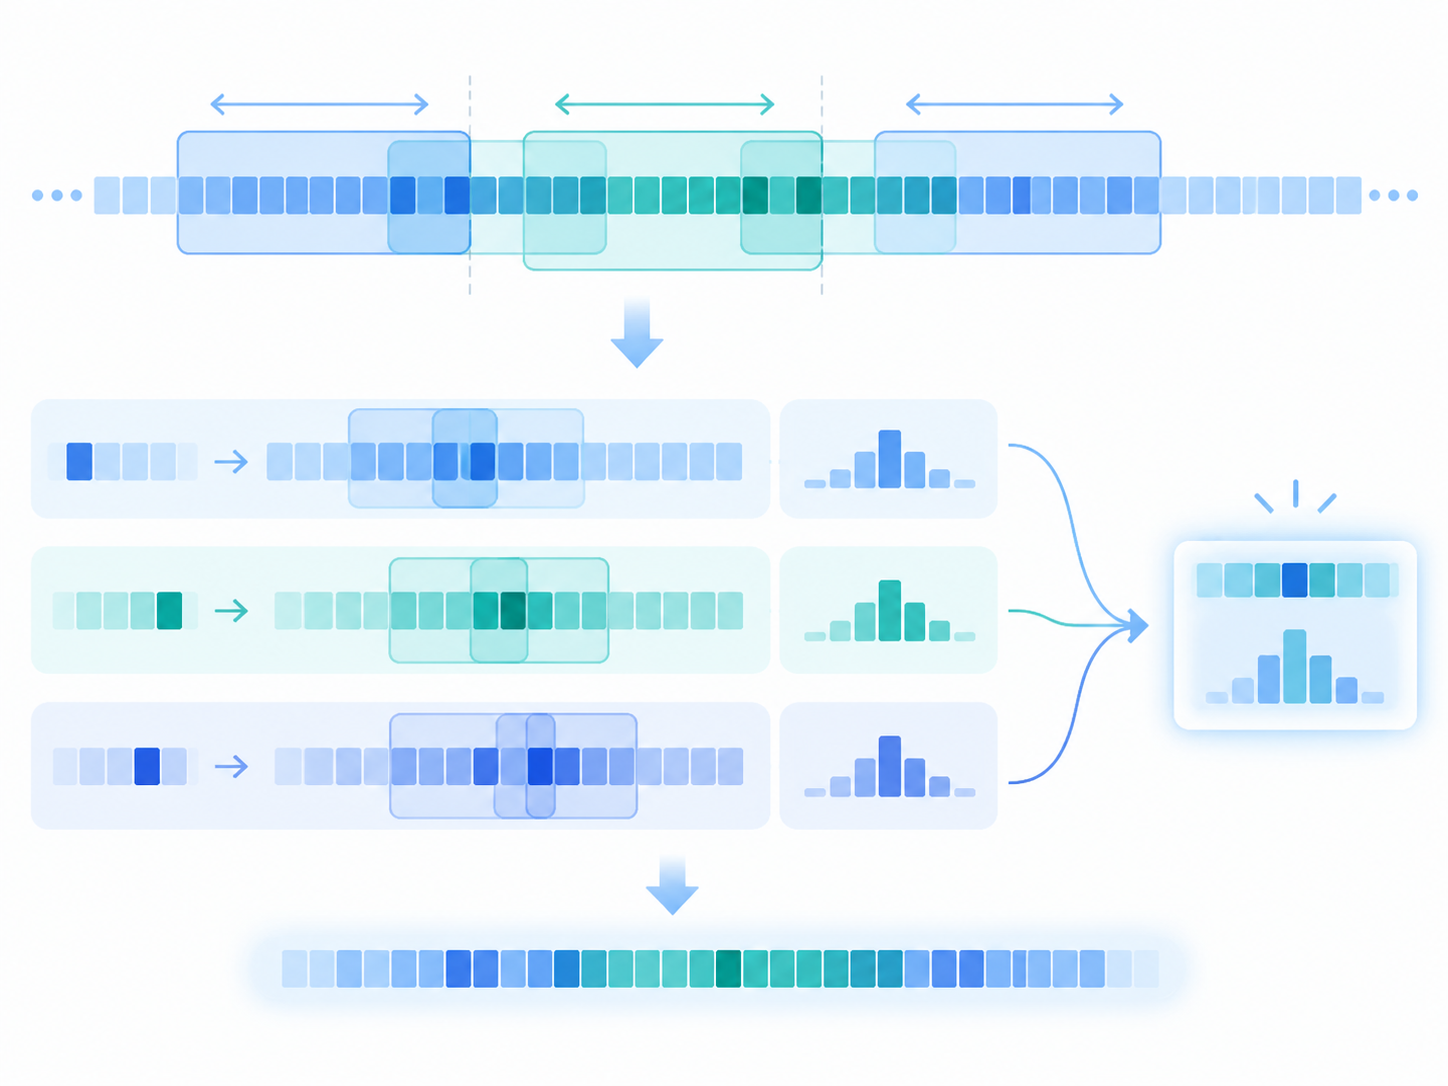
- 边界冗余与重叠分块:在块边复制若干 token,或采用重叠滑窗,降低边界丢失概率
- 动态压缩与注意力探针:为高显著性 token 预留更高留存预算,设置跨块专用注意力头作“探针”
- 多相位集成与重采样:对同一输入进行不同起点的相位偏移,多次推理投票,提升稳健性(以额外算力换可靠性)
中长期值得投入的研究方向:
- 相位随机化训练:在训练时对块起点、填充与空白字符进行随机扰动,显式引入“相位不变性”归纳偏置
- 槽位增益均衡与正则:限制门控对特定相位的过度偏好,加入相位均衡或不变性正则项
- 平滑压缩与相对位置友好池化:以连续核或注意力池化替代硬离散聚合,弱化离散相位界线
- 分层记忆与检索混合:把长程依赖更多交给可检索的外部记忆或分层摘要,降低对单一路径 KV 压缩的刚性依赖
影响与展望
这起“加点空格,模型翻车”的案例,实质上为长上下文竞赛敲响了可靠性警钟。过去行业强调“窗口有多长、显存省多少”,现在必须补上“相位稳健性”这一指标:在不同格式扰动、不同块起点下,答案是否一致?
对产业侧的启示:
- 模型需要公开“压缩档位—可靠性曲线”,而非只给一个最长上下文数字
- 提供可切换的“速览模式/精读模式”,让用户在成本与稳健间自选
- 对关键业务建立“相位抖动测试”与复核流程,纳入上线前评测清单
对研究侧的方向:
- 基准数据集应系统纳入空白字符、对齐、边界偏移等非语义扰动
- 开源与商用模型都应报告位置敏感性,并给出减灾技巧与默认安全策略
- 更本质的,是寻找兼顾成本与可预期性的记忆与压缩机制,让“省钱不等于碰运气”
长上下文是大模型走向真实应用的必由之路。下一阶段的竞争,不再是单纯把窗口做长、把 KV 做小,而是谁能在可控成本下,交付对“相位扰动”不敏感的稳定体验。
标签: 长上下文 KV缓存压缩 相位敏感性 DeepSeek 可靠性评测
还没有评论
发表评论