引言
大模型走向公众视野的方式正在改变:不再只有华丽的演示和最终分数,训练“过程本身”开始被公开。继语言与多模态模型的训练进展逐步透明后,Physical AI(物理智能)也迎来了类似尝试。生数科技的世界模型团队宣布对 Motubrain 2.0 的训练全流程进行半个月直播,直面一个关键问题:具身模型的能力是如何被“炼”出来的?
在具身智能领域,模型不仅要“看懂世界”,还要“动手做事”。这意味着训练不仅关乎数据与参数,更牵涉到任务拆解、动作决策、执行反馈和跨场景泛化。公开训练流程的价值,就在于让外界看到从失败到改进的每一步,理解能力形成的机制与代价。
核心内容
打开“具身训练黑盒”:四个环节的真实关注点
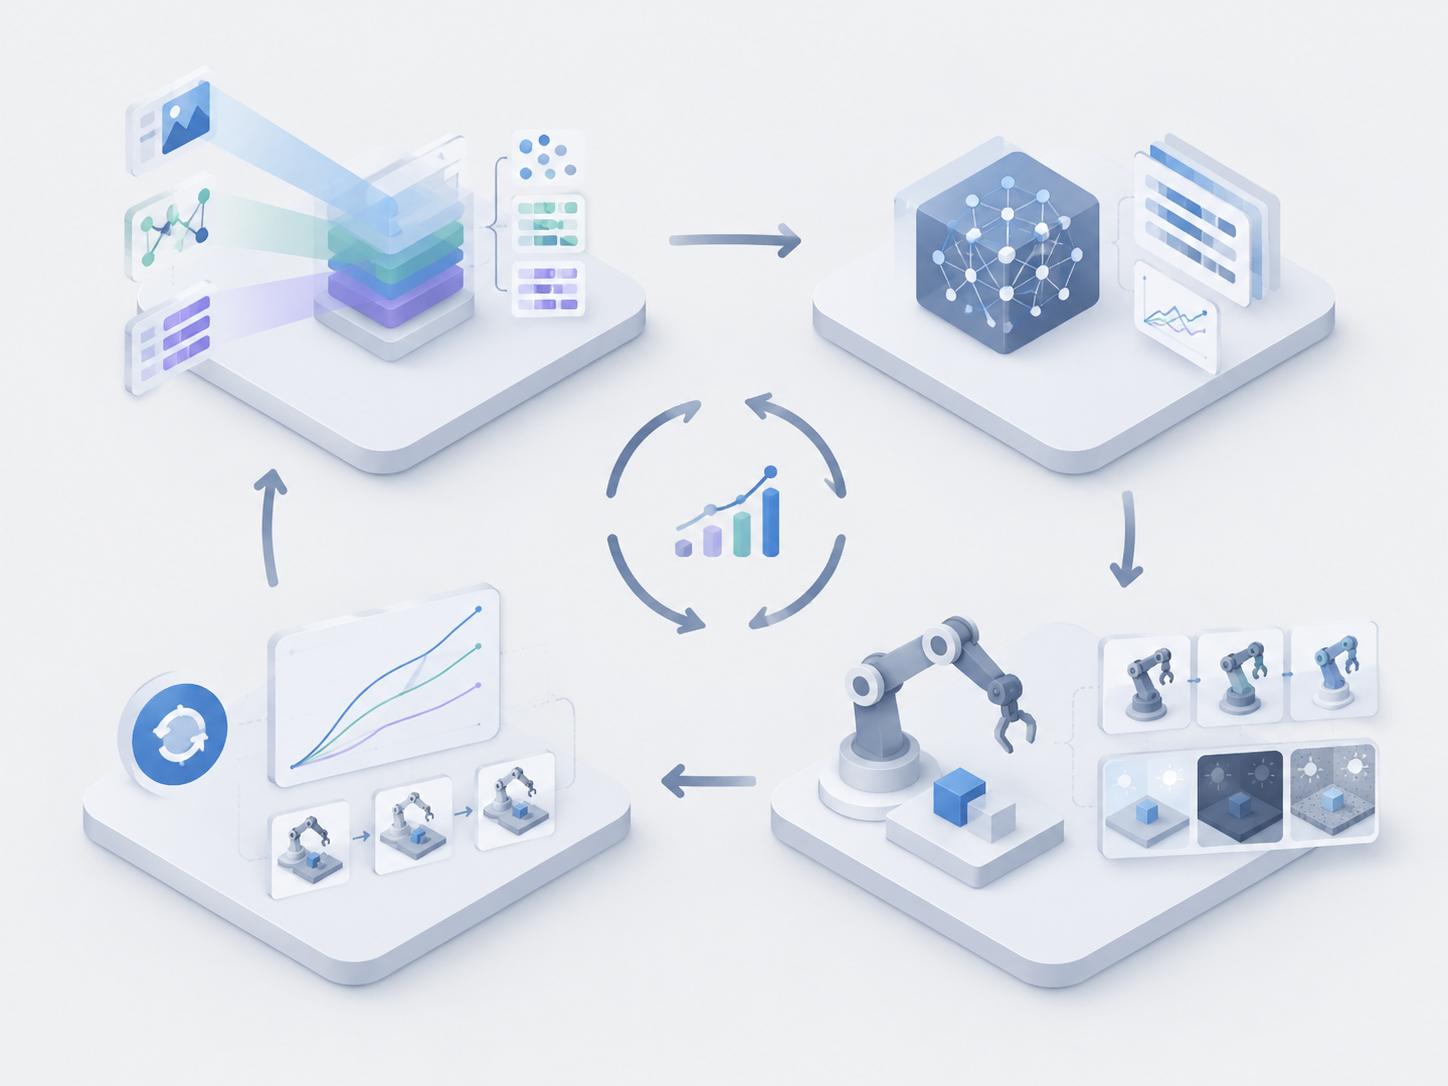
此次公开训练覆盖四个关键阶段,背后各有“看点”与潜在难点:
- 预训练:目标是建立通用表征并观察规模效应对零样本泛化的影响。关注点包括数据多样性、模态融合(视觉、状态、语义等)的权重分配,以及随规模扩张是否带来稳定的性能爬升,而非“越大越脆”。
- 后训练(针对任务的增量优化):面向具体场景提升成功率。关键是防止在单一任务上局部最优,避免破坏通用能力;评估指标应覆盖成功率、恢复能力(出错后的自我纠偏)、和对扰动的鲁棒性。
- Agent 任务执行与迁移:检验“经验能否复用到新任务/新环境”。这里应关注跨机体(不同机械臂或移动底盘)迁移、跨环境(光照、摩擦、遮挡)迁移,以及策略对长尾异常的处理。
- RSI(递归自我改进)探索:核心在“用执行反馈改造自身”。若能做到在线诊断与自修复,将是具身领域的里程碑。需要观察其是否真的减少人工干预、提高样本效率,避免“奖励投机”或过拟合短期反馈。
与只看最终 Demo 不同,直播会呈现曲线、对比与失败案例,揭示“从不可用到可用”的迭代成本。这种透明度,某种意义上比一次完美演示更难也更有价值。
Physical AI 为何格外难:从闭环到现实摩擦
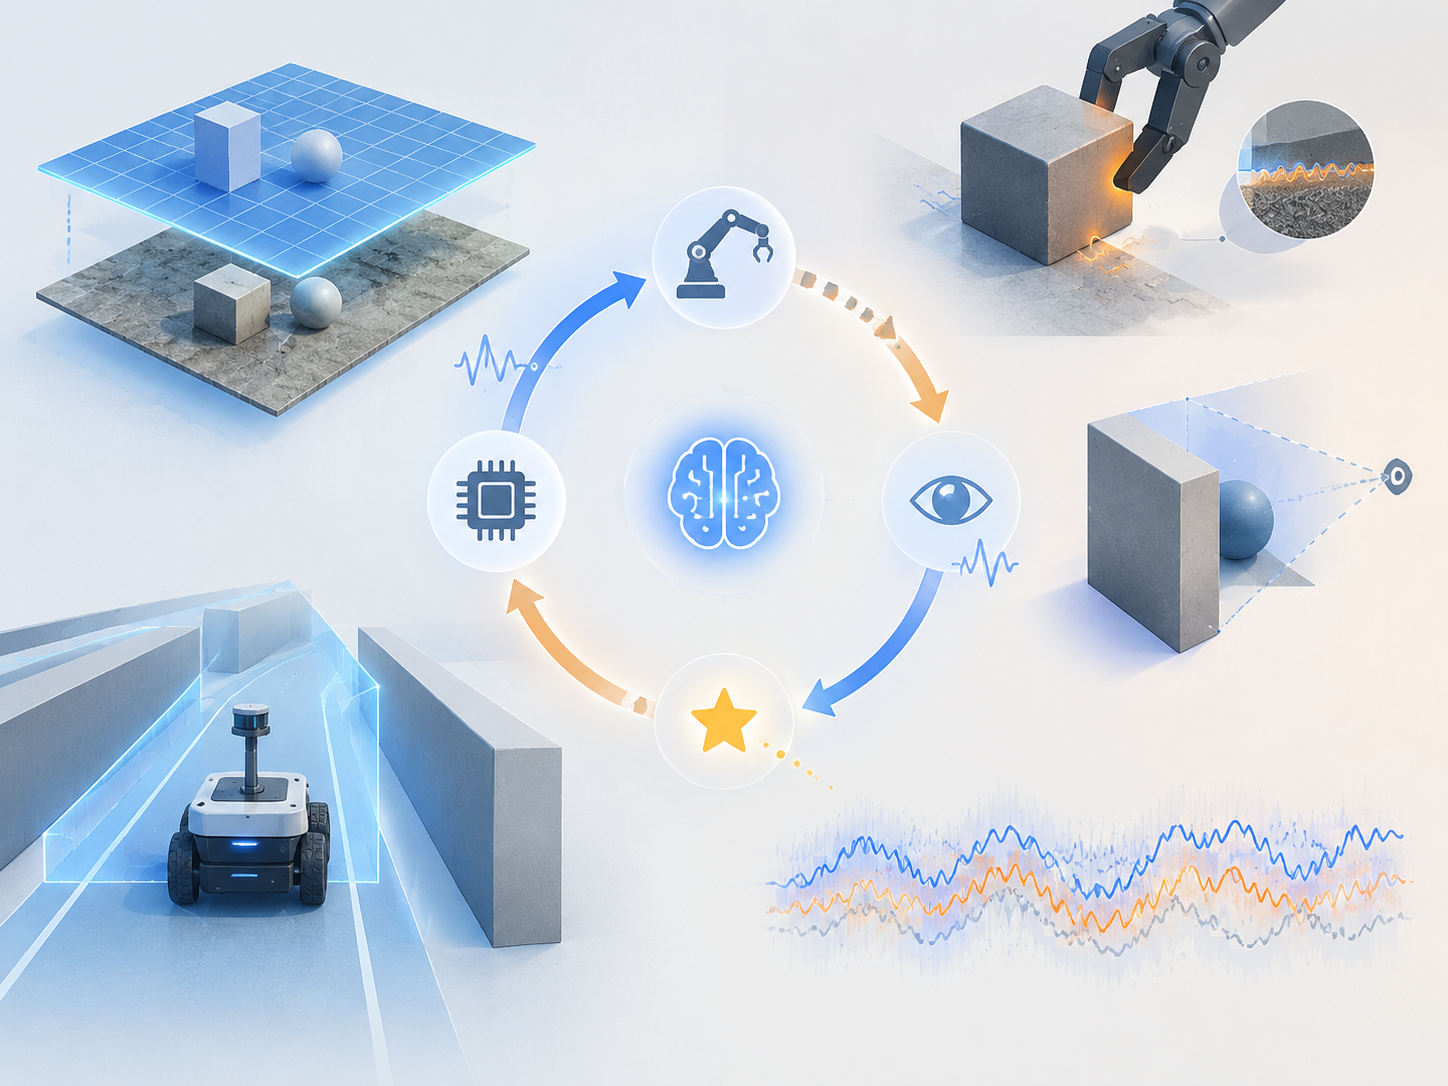
与大语言模型相比,Physical AI多了至少三重难度:
- 闭环控制与时序信用分配:动作的影响延时显著,成功或失败往往由早期微小决策决定,训练信号更稀疏、更噪声化。
- 现实世界的不可控性:传感器误差、接触动力学不确定、硬件老化与环境变化构成“活的分布偏移”;仿真到实机(sim2real)落差尤为棘手。
- 安全与代价:实机采样昂贵且风险高,如何在有限预算下获得高质量数据、如何将失败控制在可接受范围,是工程与算法的双重挑战。
在此背景下,建议关注直播中的“硬指标”:任务成功率与方差、动作延迟与能耗、跨机体/跨场景迁移曲线、以及少样本恢复能力。这些指标比单点成绩更能反映系统性进步。
从公开到开源:过程即产品
Motubrain 2.0 宣布即将开源,而选择先公开训练全流程,体现的是“过程即产品”的研发理念。其潜在价值包括:
- 复现与基准的改进:明确训练配方、失败样例与修复路径,有助于形成可对比的社区标准。
- 负责任的能力披露:让边界条件与失败模式可见,避免对具身智能的误解与过度预期。
- 集体智力:通过对可视化日志与对照实验的讨论,凝聚对“规模、泛化、自我改进”的共识与反驳,推动范式迭代。
当然,过程公开并不等于能力“已被证明”。真正的检验仍需标准化评测与第三方复现,以防训练中的短期效应被误读为长期能力。
影响与展望
- 对行业:训练透明化可能成为具身智能的新共识。谁能把“如何变强”讲清楚,谁就更可能建立信任与生态,从而加速数据、基建与评测的协同。
- 对技术:若RSI在实机闭环中展现稳定收益,或将成为具身版的“自我对齐”范式;而跨任务迁移结果,则是对“世界模型”质量的硬核检验。
- 对落地:仓储拣取、园区物流、轻工装配等场景最有望受益于任务迁移与少样本恢复。但安全边界、维护成本、合规责任仍是商业化必须正面解决的现实问题。
- 近期观察点:半个月窗口内,可重点看零样本基线是否稳步爬升;迁移成功率是否随迭代单调提升;RSI是否在“异常恢复”上优于单纯微调。决定长期走向的关键仍在三件事——数据闭环效率、实机数据性价比、与自动化评测体系。
具身智能从“演示即正义”转向“过程可解释”,是一场技术文化的更迭。Motubrain 2.0 的公开训练能否为Physical AI提供可复制的路线图,尚待时间检验,但至少把一道重要的门,真正推开了。
标签: Physical AI 具身智能 世界模型 机器人训练 开源
还没有评论
发表评论