引言
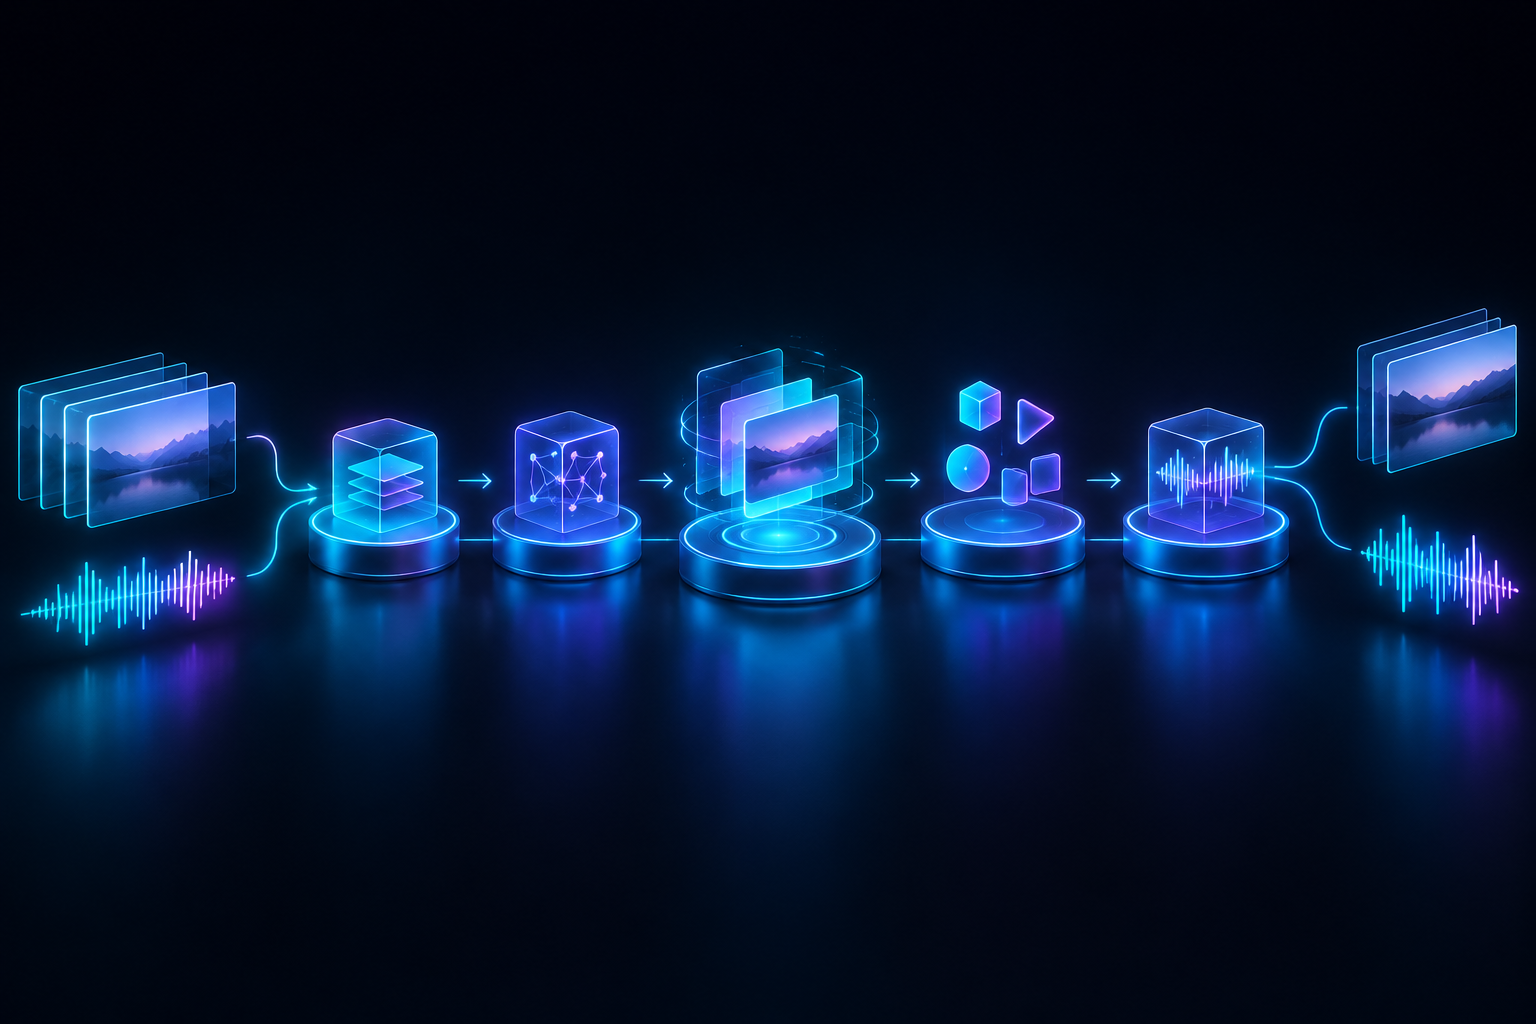
开源视频模型 H3 的爆发式增长,带动了音视频生成领域的快速迭代。基于这一基座,Pika 发布了衍生模型 H3 Flex,并将适配器权重与推理代码一并开放。它的最大亮点不在于“更清晰”或“更快”这种常规升级,而是以六步去噪完成画面与声音的联合生成。在一个统一的扩散过程里把“看”与“听”同时塑形,这种工程取向有望改变创作者的工作流,也为多模态生成的评测与优化提供了更明确的目标。
核心内容
六步联合去噪:从教师模型到高效采样
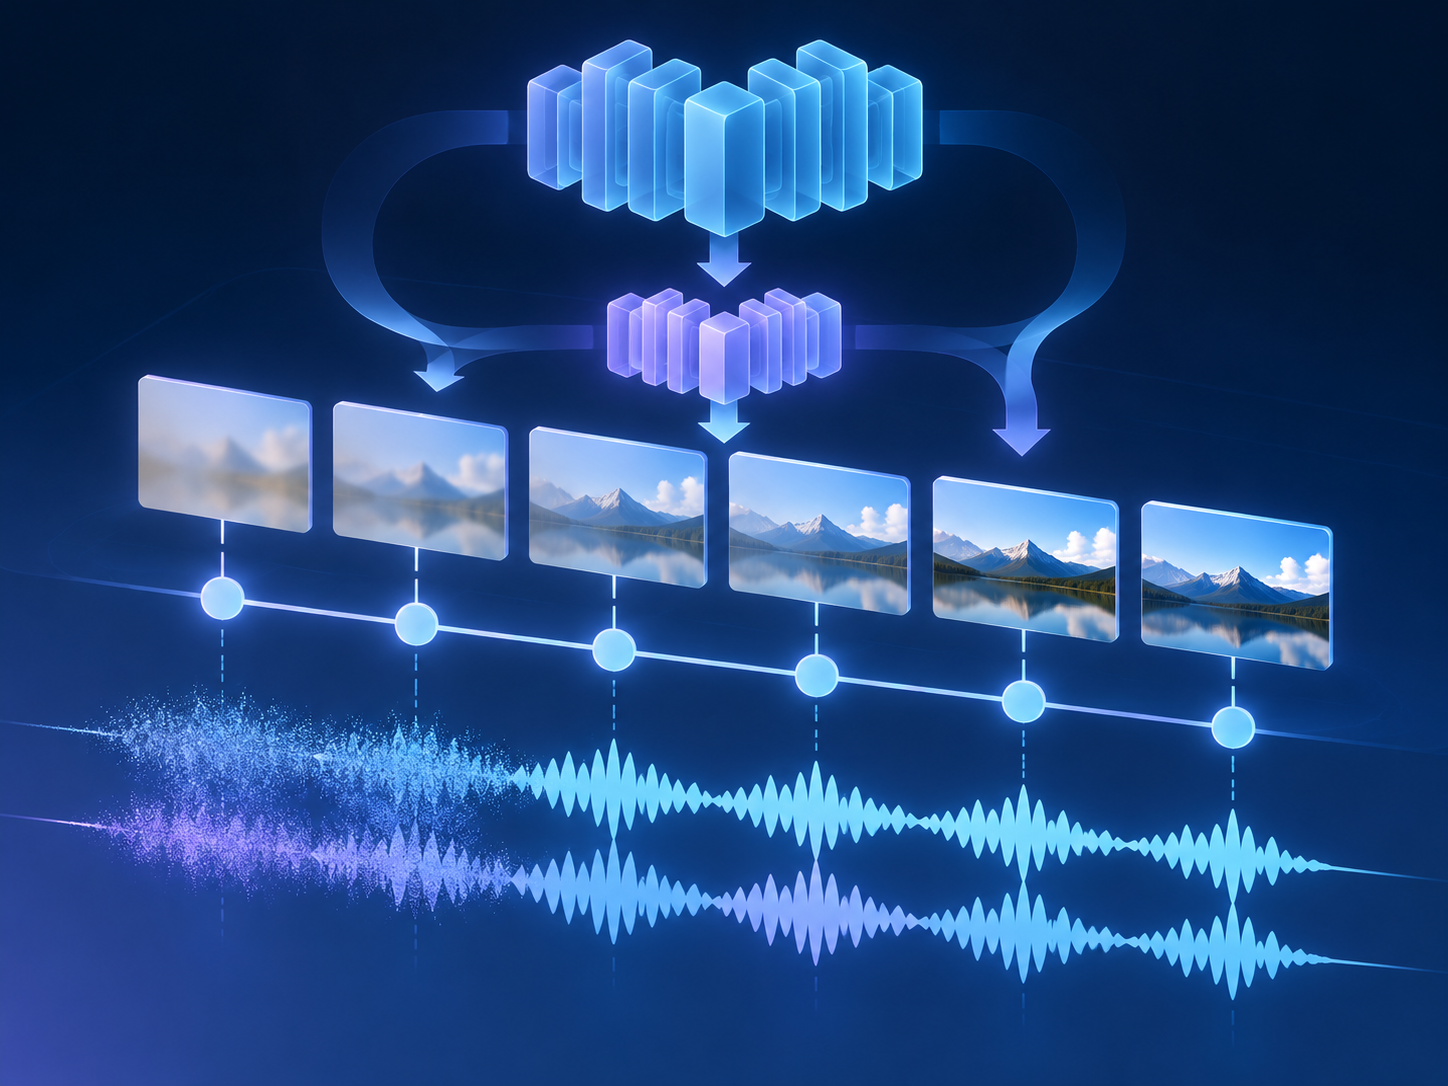
Pika 的做法是先在内部音视频数据上对 H3 进行监督微调,再通过投影分布匹配蒸馏(PDMD),把教师模型约 50 步的去噪过程压缩到 6 步。这意味着:
- 更短的采样链:生成时延显著降低,便于交互式创作与快速迭代。
- 同步一致性更强:音画在同一扩散轨迹上进化,口型、节拍、动态事件的对齐更自然。
- 潜在的精度损失用偏好优化弥补:适配器采用奖励反馈学习与直接偏好优化,重点提升美学质量、清晰度与指令遵循;在推理时合并适配器,不增加采样步数。
从工程角度看,这是一种“用系统性优化抵消采样缩短代价”的策略:以知识蒸馏获取速度,以偏好学习稳住主观质量,再以统一的音画扩散管线保证同步。对用户而言,六步不是噱头,它直接决定了本地生产力和工具可插拔性。
双 LoRA 适配器与多模态条件:从“写提示”到“提供参考”
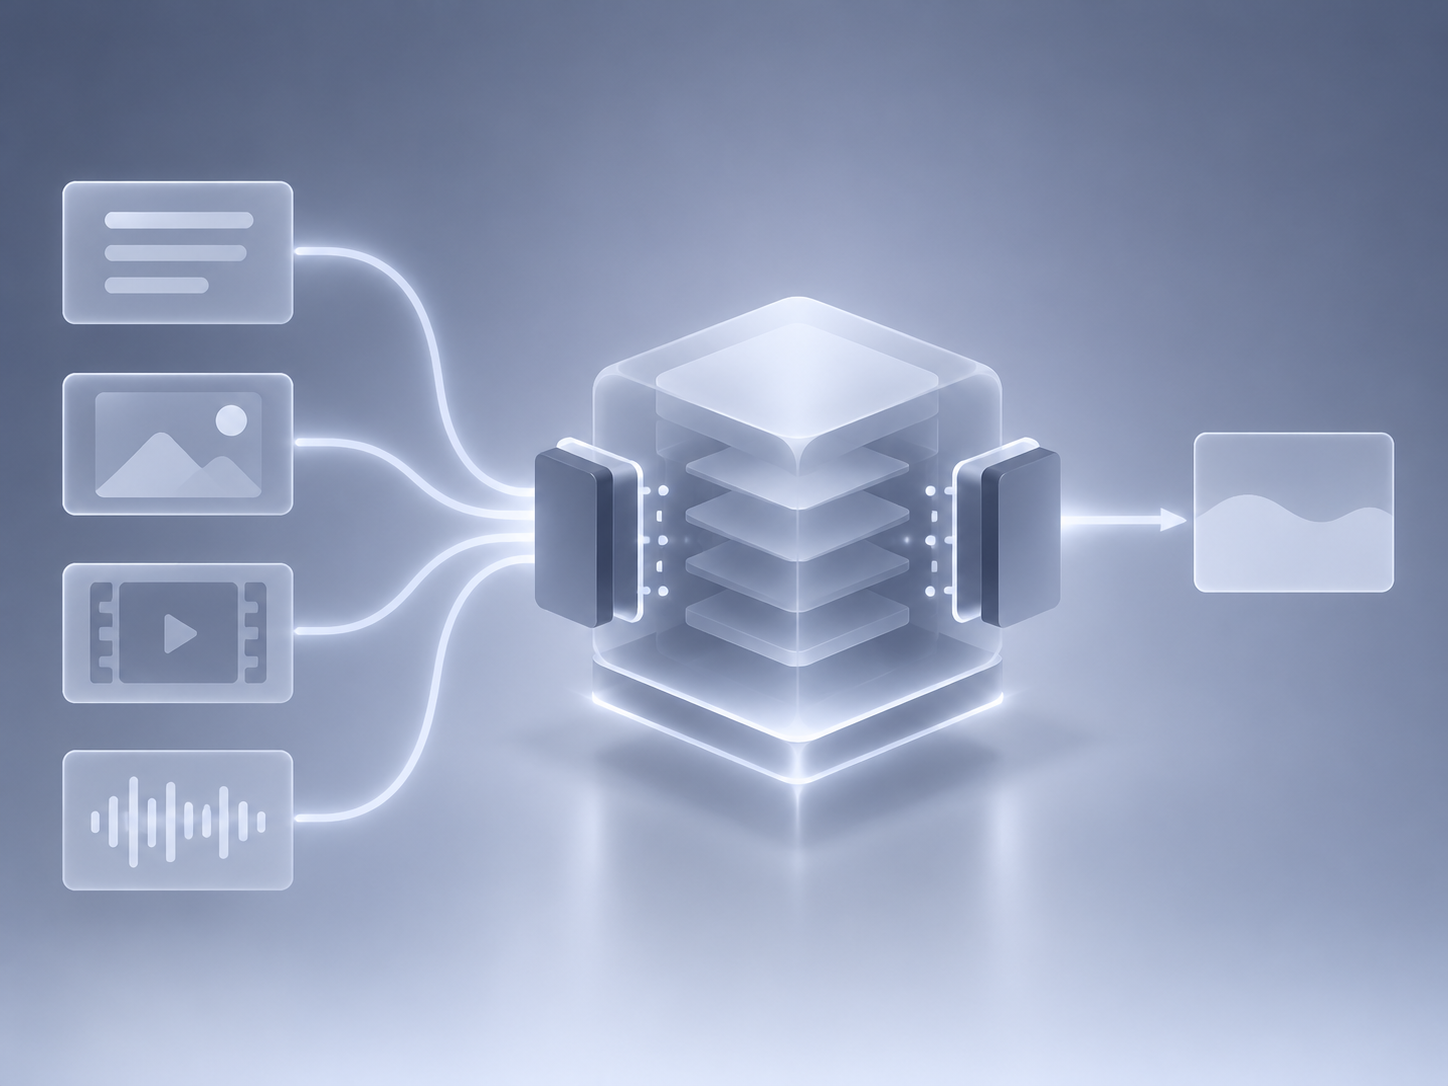
H3 Flex 随发布提供两套 LoRA 适配器:
- 文本/首尾帧条件生成:适合镜头设计与故事板变视频,起止帧帮助模型把握节奏与转换。
- 多模态参考生成:接收图片、视频、音频等作为风格与内容线索,更贴合商业级参考工作流。
模型原生输出 480P 与 768P,支持约 5–15 秒的视频和同步立体声音频。本地侧提供 MiniMax H3 的基础组件与推理工具,并给出了 ComfyUI 工作流与 Hugging Face Diffusers 接入路径。对开发者而言,这意味着:
- 现有节点图或管线可快速整合,无须重写大段代码。
- 以 LoRA 为单位的能力打包,便于按场景替换或叠加。
- 多输入形态降低纯文本提示的不可控性,把“灵感”转化为“可执行参考”。
本地草稿 + 云端增强:一套面向后期的完整链路
Pika 的方案将“草稿生成—筛选—高分辨率增强—后期混音”连成闭环:
- 在本地以 480P/768P 快速试错,挑选候选版本;
- 通过 API 做 1080P、2K、4K 增强;
- 同步生成的声音可拆分为五类音轨:对白、配乐、音效、拟音、环境声,便于分别精修与重混。
这对内容团队的意义不只是“更高清”,而是把后期工序前移:一方面尽早验证节奏、情绪与结构,另一方面通过分轨把生成音频变成可编辑的素材层,而非一条“不可分解”的混合轨。
性能与评测:速度、稳定性与公开基准
在同样的六步采样和模型权重下,Pika 报告的托管推理加速把一段 5 秒 768P 音视频的整体处理耗时从约 3.409 秒降到 2.129 秒,速度提升约 1.6 倍。这种“在不改动模型的前提下加速服务”的手段,通常来自调度、并行与内存管理的系统优化,说明团队不仅在模型上做减法,也在工程上做加法。
在公开对比中,H3 Flex 在多项视觉与音频指标上拿到领先分数,并在 DesignArena 文生视频榜单位列第八——成为该榜单中排名最高的开源视频模型。这一成绩更多反映“可复现的强基线”的价值:当开源模型在标准基准上站稳,生态的派生与定制才有明确的参照。
影响与展望
- 对创作者:联合生成让“画面设计”和“声音设计”同步推进,减少口型错位、节拍不齐等常见问题;分轨输出把生成内容自然纳入后期流程,替代以往“重录/重配”的成本。
- 对开发者:开放的 LoRA 适配器与推理代码,降低了把模型嵌入工具链的门槛;Diffusers/ComfyUI 的双路径兼容,意味着更广的生态覆盖与可视化调参空间。
- 对行业:H3 生态的爆发式扩散(数以百计的衍生模型)显示出“通用基座 + 专用适配器”的可行性。H3 Flex 以联合音画为默认范式,可能促使后续基准与评测也走向跨模态一致性。
展望未来,几件事值得关注:
- 更长时长与更强可编辑性:多段镜头衔接、时序一致性和跨镜头的角色/声音连续性,是下一阶段的核心难题。
- 实时与交互:六步采样提供了实时/准实时的可能性,结合参考输入,或将催生“边演边生”的现场应用。
- 合规与版权:音视频联合生成让“可识别风格”“可识别声音”问题更敏感,数据治理与风格保护机制需要与工具同步演进。
- 标准化评测:音画同步、对白可懂度、背景噪声控制等跨模态指标,可能成为开源模型竞争的新“公共度量”。
从“更快”到“更一致”,H3 Flex 把音画联合生成从概念落地为可用工具链。它不是终点,而是一个新的起跑线:当基础能力以开源形态下沉,真正的差异化将发生在工作流、资源管理与创作方法论上。
标签: Pika MiniMax H3 视频生成 音视频联合生成 开源模型
还没有评论
发表评论